对齐、评估与多模态图文讲义1927 字

多模态模型CLIP

·全库 76 / 611

《多模态模型CLIP》共 16 页、0.2 万字,通篇围绕 多模态、Transformer、prompt、向量 展开,归在「对齐、评估与多模态」这一层。

覆盖多模态Transformerprompt向量推理视觉

适合要给模型效果打分、判断它够不够用的人

目录骨架(8 节)
  1. 传统计算机视觉的“天花板”
  2. 监督学习的力量
  3. 范式转移:自监督学习才是真正的“蛋糕”
  4. CLIP 的核心思想:用自然语言作为监督信号
  5. 双塔奇兵:CLIP 的模型架构
  6. 核心秘方:对比学习(Contrastive Learning)
  7. 代码视角:对称交叉熵损失函数
  8. 从训练到推理:零样本分类的“魔法”

原 PDF 已逐页还原成图,共 16 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01多模态 AI 的革命:深度解析 CL…
  2. 02演讲大纲:一场从瓶颈到突破的探索之旅…
  3. 03传统计算机视觉的“天花板”
011 / 3
第 1 页
第 1 页

多模态 AI 的革命:深度解析 CL…

多模态 AI 的革命:深度解析 CLIP 模型

连接图像与语言,开启 AI“看懂”世界的新纪元

022 / 3
第 2 页
第 2 页

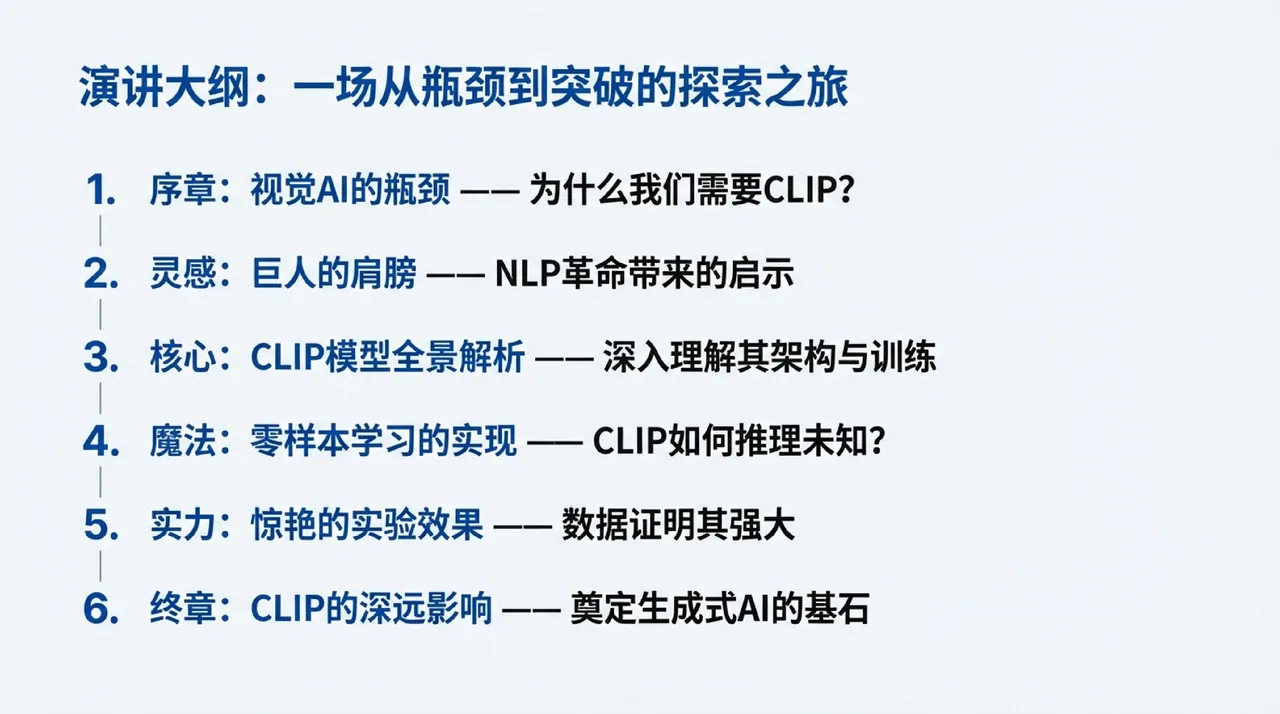
演讲大纲:一场从瓶颈到突破的探索之旅…

演讲大纲:一场从瓶颈到突破的探索之旅 1.序章:视觉 AI 的瓶颈——为什么我们需要 CLIP? 2. 灵感:巨人的肩膀——NLP 革命带来的启示 3.核心:CLIP 模型全景解析 ——深入理解其架构与训练 4.魔法:零样本学习的实现——CLIP 如何推理未知? 5. 实力:惊艳的实验效果——数据证明其强大 6. 终章:CLIP 的深远影响——奠定生成式 AI 的基石

033 / 3
第 3 页:传统计算机视觉的“天花板”
第 3 页

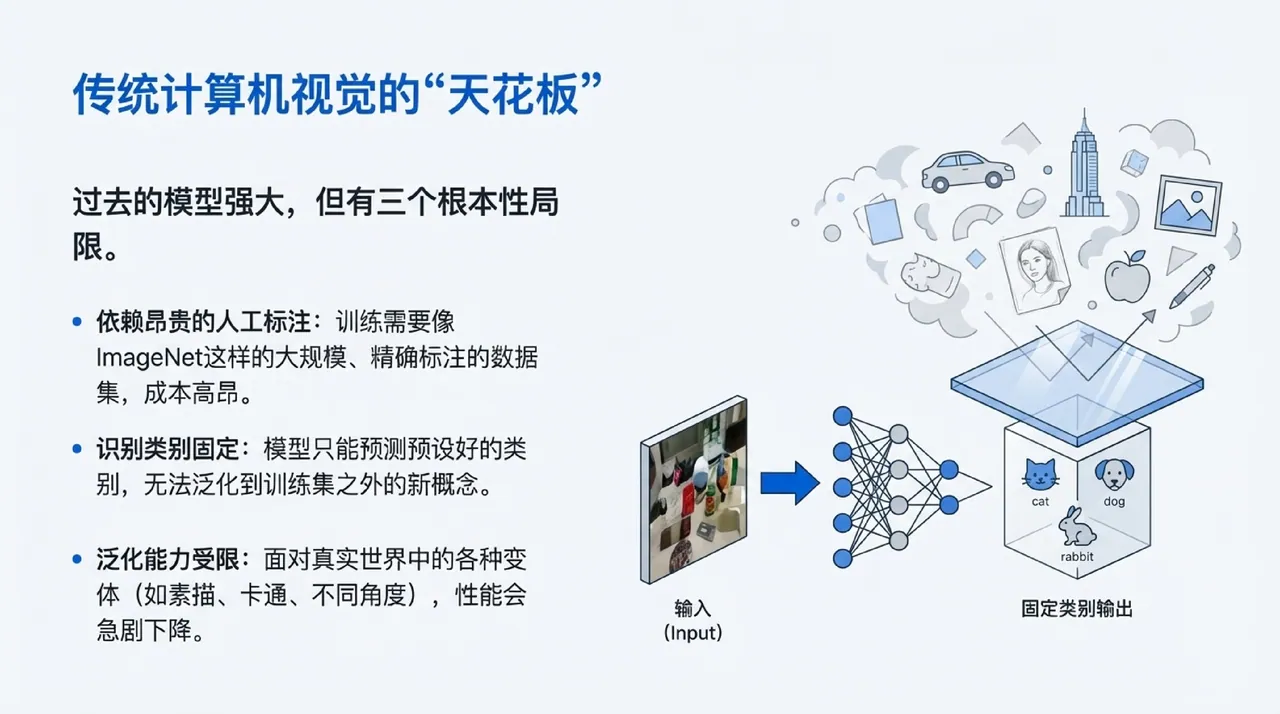
传统计算机视觉的“天花板”

过去的模型强大,但有三个根本性局 限。

  • 依赖昂贵的人工标注:训练需要像 ImageNet 这样的大规模、精确标注的数据 集,成本高昂。
  • 识别类别固定:模型只能预测预设好的类 别,无法泛化到训练集之外的新概念。
  • 泛化能力受限:面对真实世界中的各种变

体(如素描、卡通、不同角度),性能会 急剧下降。

固定类别输出

输入 (Input)

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求