框架与工具链图文讲义2100 字

Llamalndex构建基于行业数据的LLM应用

·全库 106 / 611

《Llamalndex构建基于行业数据的LLM应用》共 15 页、0.2 万字,通篇围绕 检索、知识库、RAG、上下文 展开,归在「框架与工具链」这一层。

覆盖检索知识库RAG上下文向量幻觉

适合要选技术栈、不想把别人踩过的坑重踩一遍的人

目录骨架(8 节)
  1. Llamalndex:构建基于行业数据的 LLM 应用
  2. 通用大模型的困境:强大但“无知”
  3. 破局之道:检索增强生成(RAG)
  4. 您的专属 RAG 框架:Llamalndex
  5. Llamalndex 的两大核心阶段
  6. 第一阶段:构建知识库(索引)
  7. 索引流程(1/3):数据连接器
  8. 索引流程(2/3):文档(Documents)

原 PDF 已逐页还原成图,共 15 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01Llamalndex:构建基于行业数据的 LLM 应用
  2. 02议程:我们的探索之旅
  3. 03通用大模型的困境:强大但“无知”
011 / 3
第 1 页:Llamalndex:构建基于行业数据的 LLM 应用
第 1 页

Llamalndex:构建基于行业数据的 LLM 应用

释放私有数据的力量,打造更智能、更精准的 AI 解决方案

022 / 3
第 2 页
第 2 页

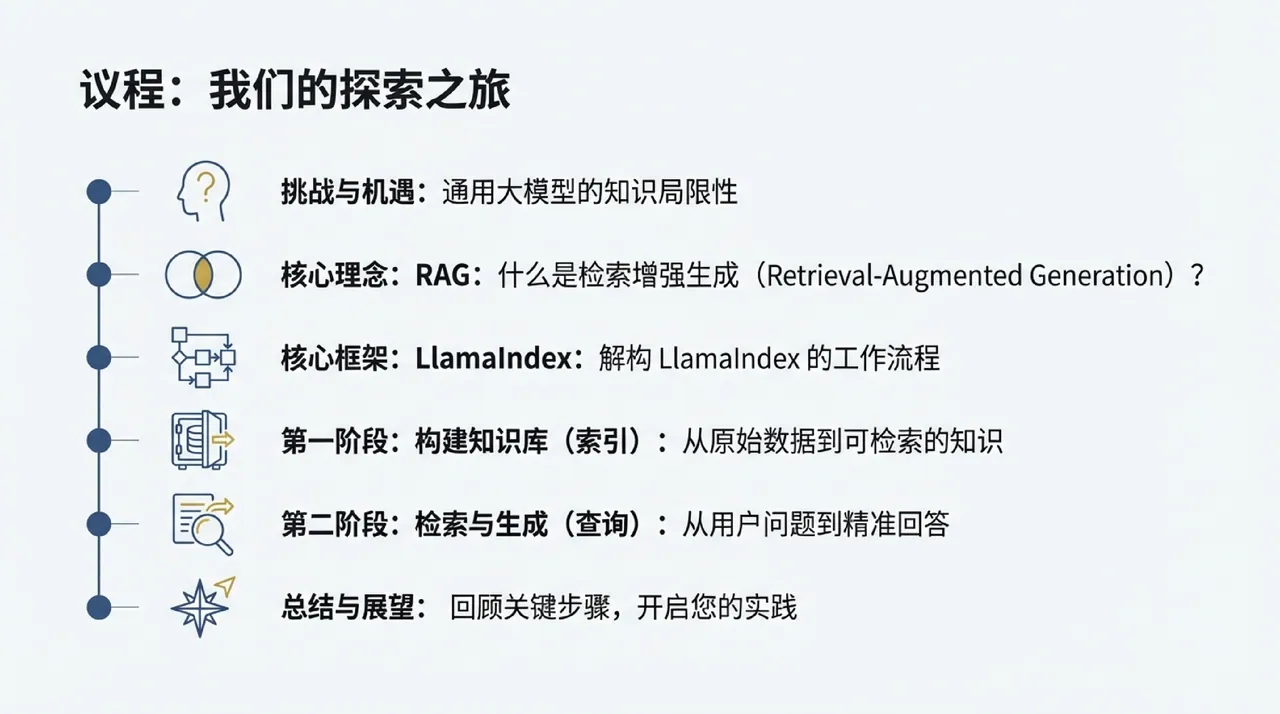
议程:我们的探索之旅

议程:我们的探索之旅

挑战与机遇:通用大模型的知识局限性

核心理念:RAG:什么是检索增强生成(Retrieval-Augmented Generation)? 核心框架:Llamalndex:解构 Llamalndex 的工作流程

第一阶段:构建知识库(索引):从原始数据到可检索的知识

第二阶段:检索与生成(查询):从用户问题到精准回答

总结与展望:

回顾关键步骤,开启您的实践

033 / 3
第 3 页:通用大模型的困境:强大但“无知”
第 3 页

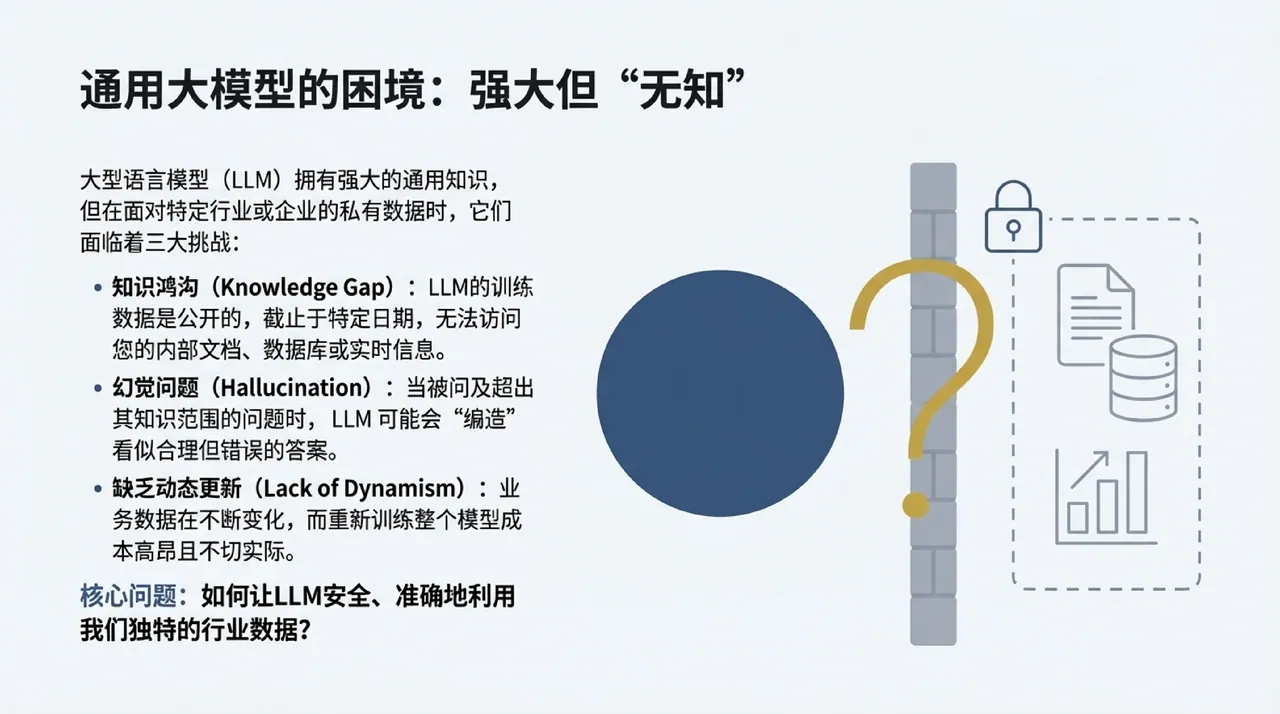
通用大模型的困境:强大但“无知”

  • 大型语言模型(LLM)拥有强大的通用知识, 但在面对特定行业或企业的私有数据时,它们 面临着三大挑战:
  • 知识鸿沟(Knowledge Gap):LLM 的训练 数据是公开的,截止于特定日期,无法访问 您的内部文档、数据库或实时信息。
  • 幻觉问题(Hallucination):当被问及超出

其知识范围的问题时,LLM 可能会“编造”

看似合理但错误的答案。 • 缺乏动态更新(Lack of Dynamism):业 务数据在不断变化,而重新训练整个模型成 本高昂且不切实际。 核心问题:如何让 LLM 安全、准确地利用 我们独特的行业数据?

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求