
亿级IM消息系统设计
《亿级IM消息系统设计》共 0.8 万字,通篇围绕 Redis、架构、评估、灰度 展开,归在「后端与系统架构」这一层。
适合给 AI 系统搭底座、要管得住的人
目录骨架(7 节)
- 消息 ID
- 会话 ID
- 58 到家
- 消息 ID 不递增可以吗
- 全局递增 vs 用户级别递增 vs 会话级别递增
- 连续递增 vs 单调递增
目录 · 4 节
分享内容
- IM 核心概念
- 读扩散 vs 写扩散
- 唯一 ID 设计
- 推模式 vs 拉模式 vs 推拉结合模式
- 业界解决方案
- IM 需要解决难点问题
- 架构心得
IM 核心概念
用户:系统的使用者
消息:是指用户之间的沟通内容。通常在 IM 系统中,消息会有以下几类:文本消息、表情消息、图片消息、视频消息、文件消息等等
会话:通常指两个用户之间因聊天而建立起的关联
群:通常指多个用户之间因聊天而建立起的关联
终端:指用户使用 IM 系统的机器。通常有 Android 端、iOS 端、Web 端等等
未读数:指用户还没读的消息数量
用户状态:指用户当前是在线、离线还是挂起等状态
关系链:是指用户与用户之间的关系,通常有单向的好友关系、双向的好友关系、关注关系等等。这里需要注意与会话的区别,用户只有在发起聊天时才产生会话,但关系并不需要聊天才能建立。对于关系链的存储,可以使用图数据库(Neo4j 等等),可以很自然地表达现实世界中的关系,易于建模
单聊:一对一聊天
群聊:多人聊天
客服:在电商领域,通常需要对用户提供售前咨询、售后咨询等服务。这时,就需要引入客服来处理用户的咨询
消息分流:在电商领域,一个店铺通常会有多个客服,此时决定用户的咨询由哪个客服来处理就是消息分流。通常消息分流会根据一系列规则来确定消息会分流给哪个客服,例如客服是否在线(客服不在线的话需要重新分流给另一个客服)、该消息是售前咨询还是售后咨询、当前客服的繁忙程度等等
信箱:指一个 Timeline、一个收发消息的队列
读扩散 vs 写扩散
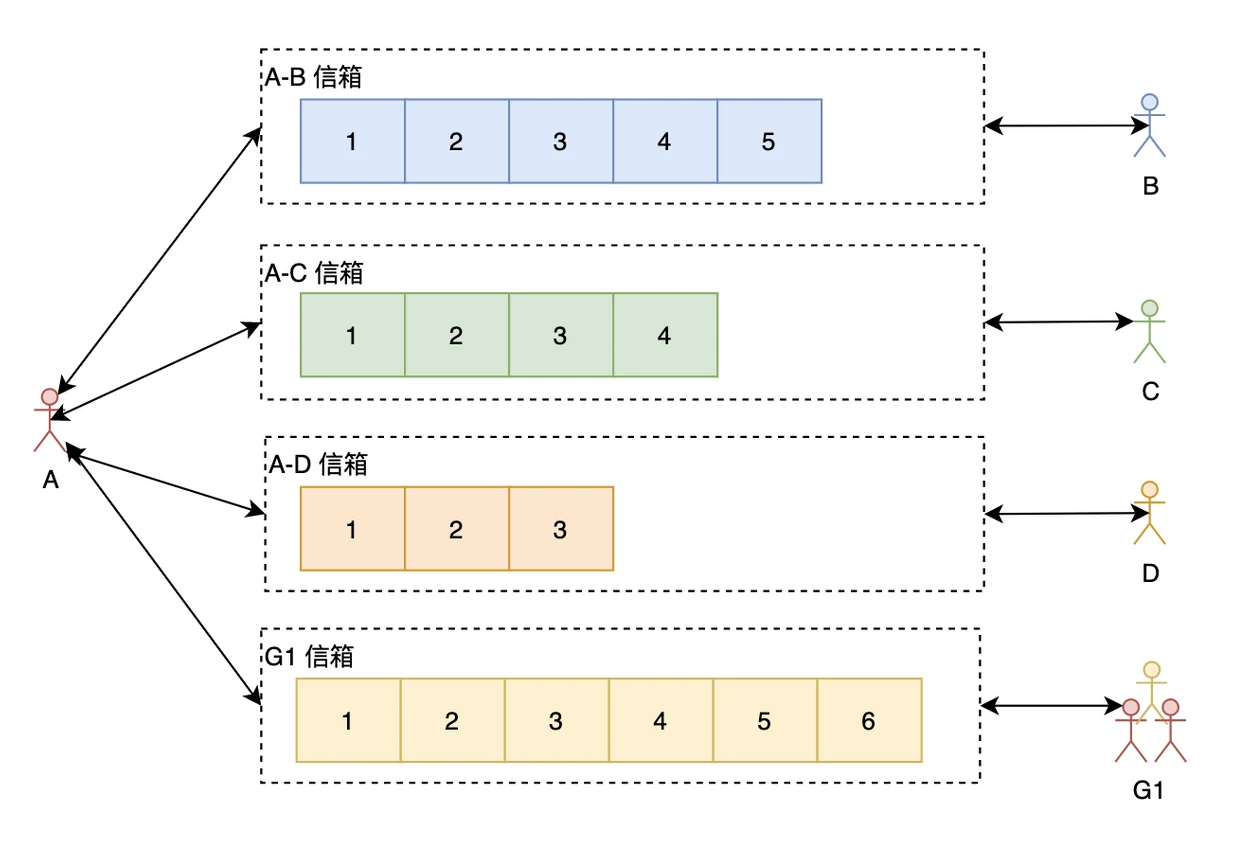
读扩散
我们先来看看读扩散。如上图所示,A 与每个聊天的人跟群都有一个信箱(有些博文会叫 Timeline),A 在查看聊天信息的时候需要读取所有有新消息的信箱。这里的读扩散需要注意与 Feeds 系统的区别,在 Feeds 系统中,每个人都有一个写信箱,写只需要往自己的写信箱里写一次就好了,读需要从所有关注的人的写信箱里读。但 IM 系统里的读扩散通常是每两个相关联的人就有一个信箱,或者每个群一个信箱。
读扩散的优点:
- 写操作(发消息)很轻量,不管是单聊还是群聊,只需要往相应的信箱写一次就好了
- 每一个信箱天然就是两个人的聊天记录,可以方便查看聊天记录跟进行聊天记录的搜索
读扩散的缺点:
- 读操作(读消息)很重
写扩散
接下来看看写扩散。
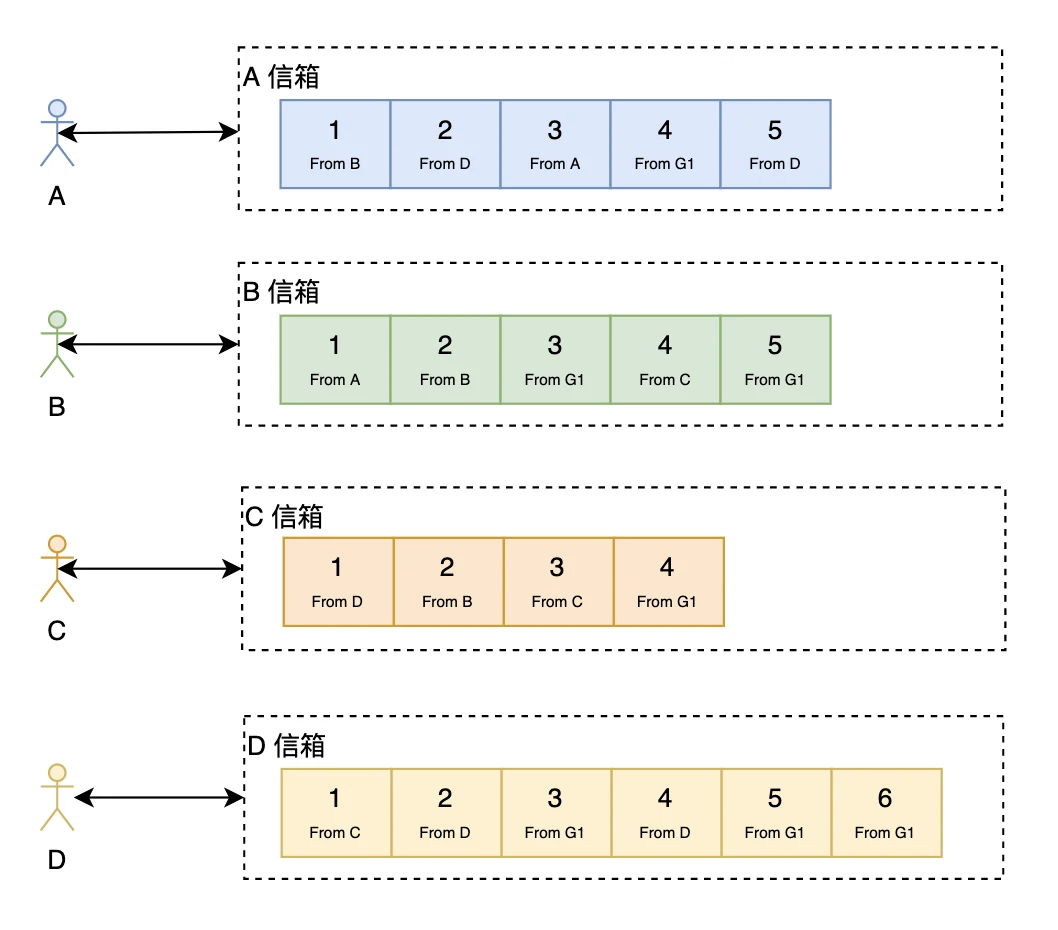
在写扩散中,每个人都只从自己的信箱里读取消息,但写(发消息)的时候,对于单聊跟群聊处理如下:
- 单聊:往自己的信箱跟对方的信箱都写一份消息,同时,如果需要查看两个人的聊天历史记录的话还需要再写一份(当然,如果从个人信箱也能回溯出两个人的所有聊天记录,但这样效率会很低)。
- 群聊:需要往所有的群成员的信箱都写一份消息,同时,如果需要查看群的聊天历史记录的话还需要再写一份。可以看出,写扩散对于群聊来说大大地放大了写操作。
写扩散优点:
- 读操作很轻量
- 可以很方便地做消息的多终端同步
写扩散缺点:
- 写操作很重,尤其是对于群聊来说
注意,在 Feeds 系统中:
- 写扩散也叫:Push、Fan-out 或者 Write-fanout
- 读扩散也叫:Pull、Fan-in 或者 Read-fanout
唯一 ID 设计
通常情况下,ID 的设计主要有以下几大类:
- UUID
- 基于 Snowflake 的 ID 生成方式
- 基于申请 DB 步长的生成方式
- 基于 Redis 或者 DB 的自增 ID 生成方式
- 特殊的规则生成唯一 ID
具体的实现方法跟优缺点可以参考之前的一篇博文:分布式唯一 ID 解析
在 IM 系统中需要唯一 Id 的地方主要是:
- 会话 ID
- 消息 ID
消息 ID
我们来看看在设计消息 ID 时需要考虑的三个问题。
消息 ID 不递增可以吗
我们先看看不递增的话会怎样:
- 使用字符串,浪费存储空间,而且不能利用存储引擎的特性让相邻的消息存储在一起,降低消息的写入跟读取性能
- 使用数字,但数字随机,也不能利用存储引擎的特性让相邻的消息存储在一起,会加大随机 IO,降低性能;而且随机的 ID 不好保证 ID 的唯一性
消息可以看做时序数据,使用递增的 ID 可以方便做消息分页拉取,提高分页性能。因此,消息 ID 最好是递增的。
全局递增 vs 用户级别递增 vs 会话级别递增
全局递增:指消息 ID 在整个 IM 系统随着时间的推移是递增的。全局递增的话一般可以使用 Snowflake(当然,Snowflake 也只是 worker 级别的递增)。此时,如果你的系统是读扩散的话为了防止消息丢失,那每一条消息就只能带上上一条消息的 ID,前端根据上一条消息判断是否有丢失消息,有消息丢失的话需要重新拉一次。