
HuggingFace 核心组件及应用实战
《HuggingFace 核心组件及应用实战》共 0.3 万字,通篇围绕 数据集、预训练、向量、微调 展开,归在「框架与工具链」这一层。
适合要选技术栈、不想把别人踩过的坑重踩一遍的人
目录骨架(7 节)
- 一、Hugging Face 简介
- 二、Hugging Face 核心组件
- 三、Hugging Face 应用实战
- 四、总结
- 1、Hugging Face Transformers
- 2、Hugging Face Dataset
- 3、Hugging Face Tokenizer
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.11.7
分享内容
- 什么是 Hugging Face?它的目标是什么?
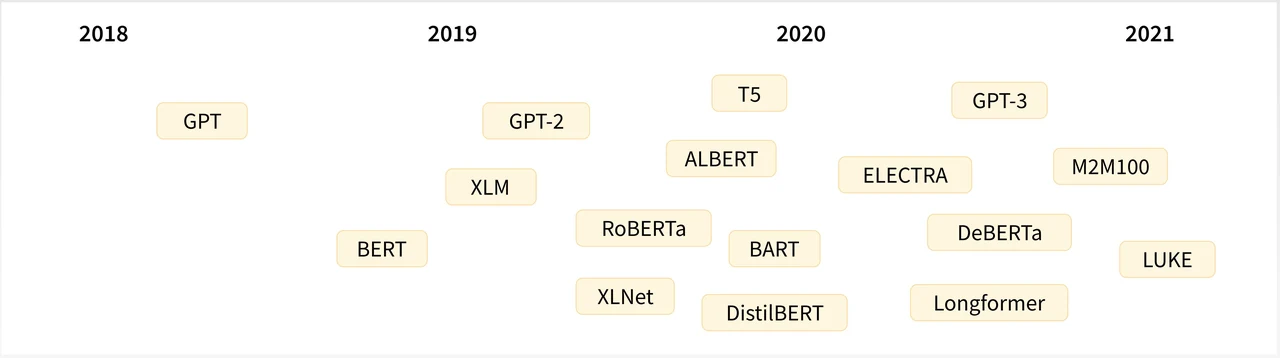
- Hugging Face 中包含哪些知名的预训练模型?
- 如果我们要在 Hugging Face 中下载 BERT,那么
- 只有一种版本,还是有多种版本可以选择?
- 每一种版本的 BERT 中,只有一种格式还是有多种格式可以适应多种下游任务?
- Hugging Face 库中有哪些有用的组件?
一、Hugging Face 简介
官网:https://huggingface.co/
Hugging Face 是一个开源的 AI 社区网站,站内几乎囊括了所有常见的 AI 开源模型,号称:一网打尽,应有尽有,全部开源。
在 Hugging Face 中可以下载到众多开源的预训练大模型,模型本身包含相关信息和参数,可以拿来做微调和重新训练,非常方便。
二、Hugging Face 核心组件
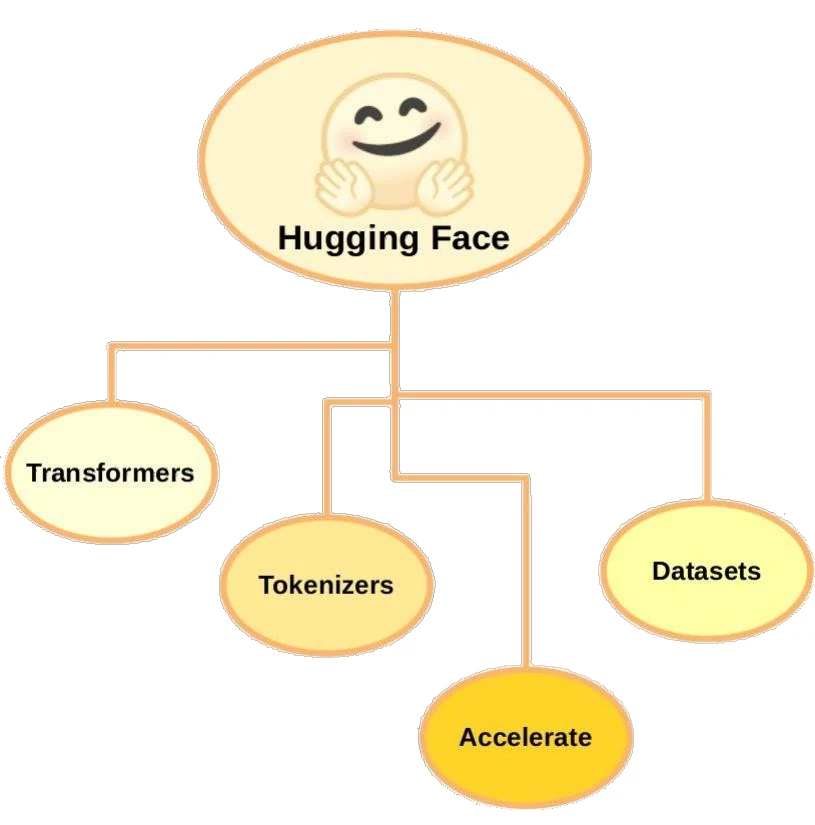
Hugging Face 核心组件包括 Transformers、Dataset、Tokenizer,此外还有一些辅助工具,如 Accelerate,用于加速深度学习训练过程。
更多内容可以去 Hugging Face 官网上发掘,下面重点介绍下它的三个核心组件。
1、Hugging Face Transformers
Transformers 是 Hugging Face 的核心组件,主要用于自然语言处理,提供了预训练的语言模型和相关工具,使得研究者和工程师能够轻松的训练和使用海量的 NLP 模型。
常用的模型包括 BERT、GPT、XLNet、RoBERTa 等,并提供了模型的各种版本。
通过 Transformers 库,开发人员可以用这些预训练模型进行文本分类、命名实体识别、机器翻译、问答系统等 NLP 任务。
Transformers 库本身还提供方便的 API、实例代码、文档,让开发者学习和使用这些模型都变得非常简单,同时开发者也可以上传自己的预训练模型和 API。
# 首先通过 pip 下载相关库:pip install transformers

# 导入 transformers 相关库
from transformers import AutoModelForSequenceClassification

# 初始化分词器和模型
model_name = "bert-base-cased"
model = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=2)

# 将编码后的张量输入模型进行预测
outputs = model(**inputs)

# 获取预测结果和标签
predictions = outputs.logits.argmax(dim=-1)
2、Hugging Face Dataset
Dataset 是 Hugging Face 的公共数据集仓库,以下是常用的一些数据集(欢迎补充):
- SQuAD:Stanford 大学发布的问答数据集
- IMBDB:电影评论数据集
- CoNLL-2003:NER 命名实体识别数据集
- GLUE:公共基准测试集
Hugging Face Dataset 简化了数据集的下载、预处理过程,并具备数据集分割、采样和迭代器等功能。
# 首先通过 pip 下载相关库:pip install datasets

# 导入数据集
from datasets import load_dataset

# 下载数据集并打乱数据
dataset_name = "imdb"
dataset = load_dataset(dataset_name)
3、Hugging Face Tokenizer
Tokenizer 是 Hugging Face 的分词器,它的任务是将输入文本转换为一个个标记(tokens),它还能对文本序列进行清洗、截断和填充等预处理,以满足模型的输入要求。它的主要功能是将文本分解为更小的单元(通常是词或子词),并将这些单元映射到数值表示。
以下是分词器的简单解释:
- 文本分割:分词器首先将输入的文本分割成更小的单元。例如,对于句子 "I love NLP",分词器可能会将其分割为 ["I", "love", "NLP"]。
- 词汇映射:分词器会将每个单元映射到一个唯一的数值索引,这些索引通常来自一个预定义的词汇表。例如,假设词汇表中 "I" 的索引是 1,"love" 的索引是 2,"NLP" 的索引是 3,那么分词器会将句子转换为 [1, 2, 3]。
- 处理特殊标记:分词器还会处理一些特殊的标记,比如句子开头的 [CLS] 标记和句子结尾的 [SEP] 标记,这些标记在某些模型中是必需的。
- 填充和截断:为了使输入的长度一致,分词器可以对较短的序列进行填充(添加特殊的填充标记)或对较长的序列进行截断。