
LlamaIndex大模型应用开发快速入门
《LlamaIndex大模型应用开发快速入门》共 0.3 万字,通篇围绕 检索、LlamaIndex、RAG、向量 展开,归在「框架与工具链」这一层。
适合要选技术栈、不想把别人踩过的坑重踩一遍的人
目录骨架(8 节)
- 一、什么是 LlamaIndex
- 二、LlamaIndex 核心组件
- 三、LlamaIndex 核心概念
- 四、个性化配置
- 五、总结
- 1. 简介
- 索引(Indexing)
- 检索和生成(Retrieval and generation)
一、什么是 LlamaIndex
1. 简介
LlamaIndex 是一个用于 LLM 应用程序的数据框架,用于注入,结构化,并访问私有或特定领域数据。就是将大模型部署到本地或是公司服务器上,然后将自有数据结合大模型为个人或是企业服务。
官方文档:https://docs.llamaindex.ai/en/stable/
中文文档:https://www.aidoczh.com/llamaindex/
RAG是一种用额外数据增强大语言模型知识的技术。
大语言模型可以对广泛的主题进行推理,但它们的知识仅限于训练时截止日期前的公开数据。如果你想构建能够对私有数据或模型截止日期后引入的数据进行推理的人工智能应用,你需要用特定信息来增强模型的知识。检索适当信息并将其插入模型提示的过程被称为检索增强生成(RAG)。
LangChain有许多组件旨在帮助构建问答应用,以及更广泛的RAG应用。
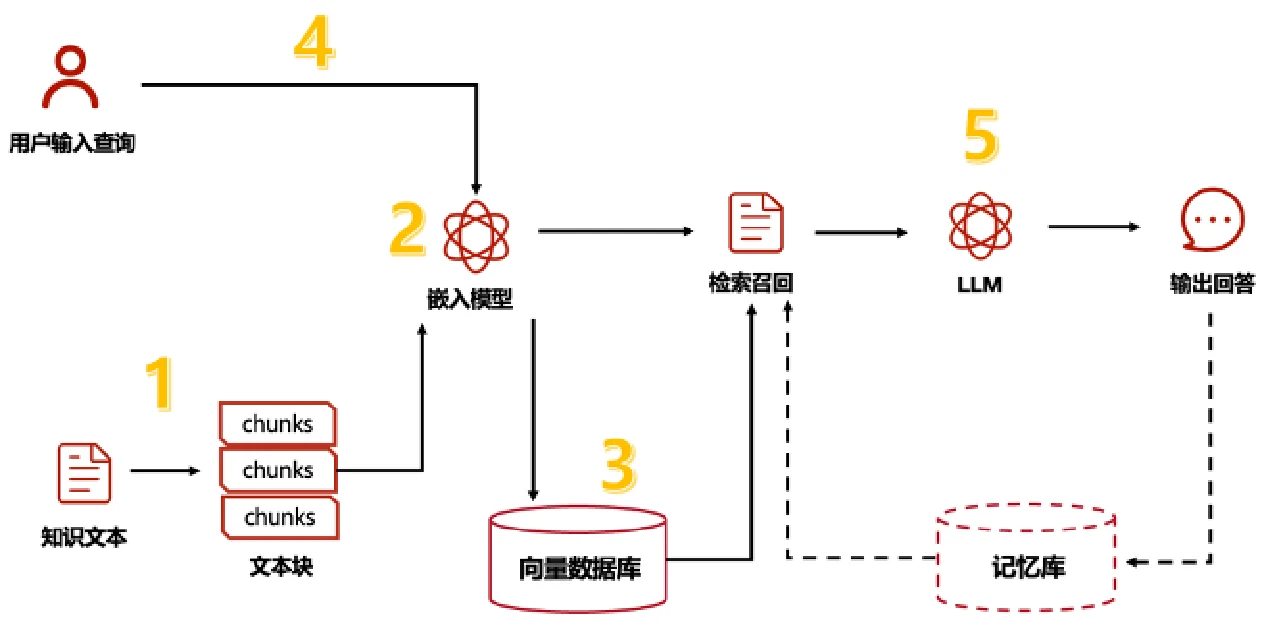
一个典型的RAG应用有两个主要组成部分:
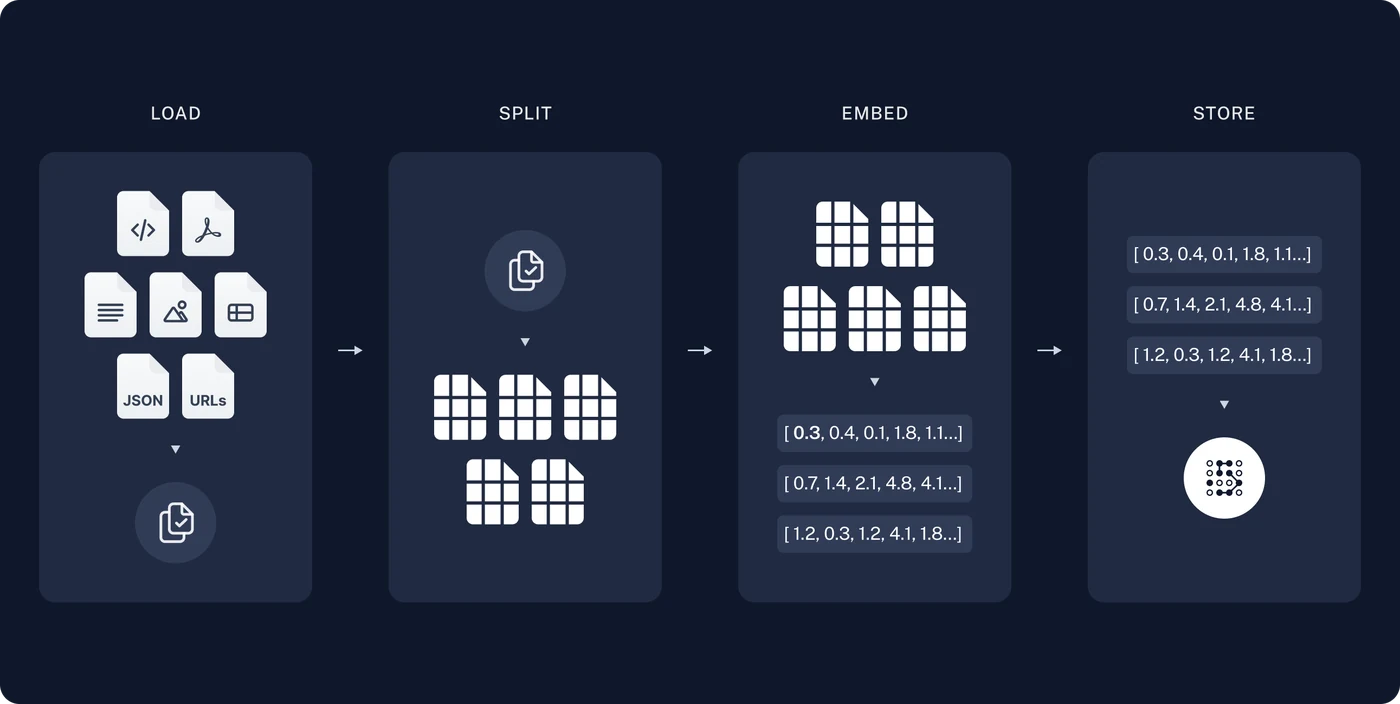
索引(Indexing):从数据源获取数据并建立索引的管道(pipeline)。这通常在离线状态下进行。
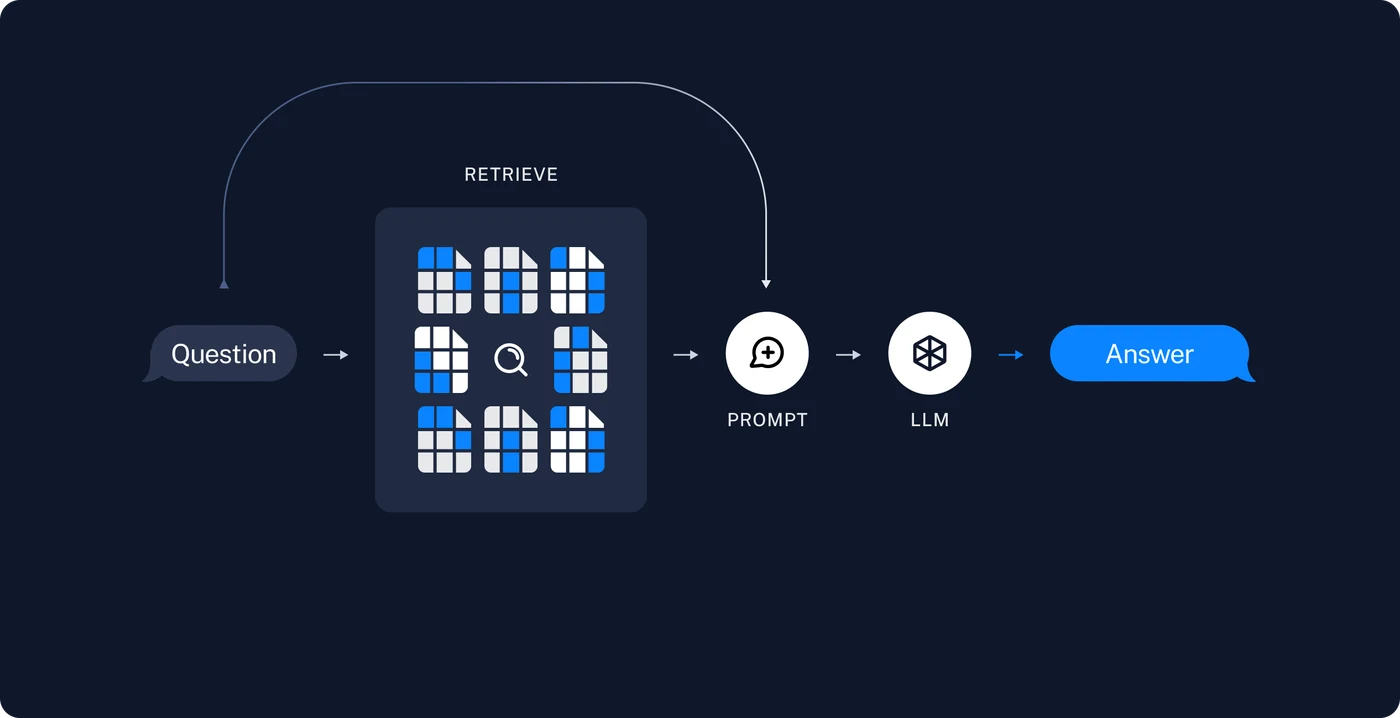
检索和生成(Retrieval and generation):实际的RAG链,在运行时接收用户查询,从索引中检索相关数据,然后将其传递给模型。
从原始数据到答案的最常见完整顺序如下:
索引(Indexing)
- 加载(Load):首先我们需要加载数据。这是通过文档加载器Document Loaders完成的。
- 分割(Split):文本分割器Text splitters将大型文档(Documents)分成更小的块(chunks)。这对于索引数据和将其传递给模型都很有用,因为大块数据更难搜索,而且不适合模型有限的上下文窗口。
- 存储(Store):我们需要一个地方来存储和索引我们的分割(splits),以便后续可以对其进行搜索。这通常使用向量存储VectorStore和嵌入模型Embeddings model来完成。
检索和生成(Retrieval and generation)
- 检索(Retrieve):给定用户输入,使用检索器Retriever从存储中检索相关的文本片段。
- 生成(Generate): ChatModel使用包含问题和检索到的数据的提示来生成答案。
2. 作用
在本质上,LLM(如 GPT,DeepSeek 等) 为人类和推断出的数据提供了基于自然语言的交互接口。广泛可用的大模型通常在大量公开可用的数据上进行的预训练,包括来自维基百科、邮件列表、书籍和源代码等。构建在 LLM 模型之上的应用程序通常需要使用私有或特定领域数据来增强这些模型。不幸的是,这些数据可能分布在不同的应用程序和数据存储中。它们可能存在于 API 之后、SOL 数据库中,或者存在在 PDF 文件以及幻灯片中。Llamalndex 应运而生。总体来说就是将特定领域数据和大模型相结合。
二、LlamaIndex 核心组件
LlamaIndex 提供的五大核心工具如下:
1. 数据连接器(Data Connectors)
数据连接器用于从各种数据源中摄取数据,并将其转换为统一的文档表示形式。支持的数据源包括本地文件、PDF、API、SQL 数据库、Notion、Google 文档等。
2. 数据索引(Data Indexes)
数据索引将数据组织成可查询的索引形式,支持多种索引类型:向量索引(Vector Store Index):基于向量相似度检索数据。列表索引(List Index):按顺序存储节点,支持关键字过滤。树形索引(Tree Index):构建层次化结构,支持从根节点到叶节点的查询。关键字表索引(Keyword Table Index):通过关键字映射快速检索节点。
3. 引擎(Engines)
提供对数据的自然语言访问,主要包括:查询引擎(Query Engines):用于问答,例如 RAG 流程中结合上下文和 LLM 生成答案。聊天引擎(Chat Engines):用于与数据进行多轮对话交互。
4. 数据代理(Data Agents)
数据代理是由大语言模型(LLM)驱动的知识工作者,通过工具增强,能够执行各种任务,如研究、数据提取等。代理可以使用 RAG 管道等多种工具来完成任务。
5. 应用集成(Application Integrations)
LlamaIndex 提供了丰富的应用集成选项,包括:向量数据库集成:如 Pinecone、Chroma、Weaviate、Milvus 等。应用框架集成:如 Streamlit、Chainlit。其他集成:如与 OpenAI API、Hugging Face Transformers、Azure OpenAI 等模型服务的对接.