
基于LlamaIndex开发AI法律助手
《基于LlamaIndex开发AI法律助手》共 0.5 万字,通篇围绕 向量、检索、数据库、上下文 展开,归在「框架与工具链」这一层。
适合要选技术栈、不想把别人踩过的坑重踩一遍的人
目录骨架(8 节)
- 一、 项目背景与需求设计
- 二、 数据收集与整理
- 三、 核心实现流程
- 五、测试
- 1. 配置与模型初始化
- 2. 向量存储与索引构建
- 3. 主程序逻辑
- 4. 代码
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.12.4
前言
一、 项目背景与需求设计
需求场景: 开发一个AI法律助手只能问答系统要求:
- 需要更新最新的法律条文 (更新频率>= 每月)
- 支持对法律条款的精确引用.
- 处理复杂的法律条款的关联查询.
选择 RAG 而非微调的原因:
- 法律条文存在一定的更新频率,微调模型难以快速同步最新信息。
- 需要精确引用条款原文,避免模型生成内容失真。
- 法律知识体系庞大,微调需要海量标注数据。
- RAG 机制天然支持条款溯源,符合法律场景需求。
二、 数据收集与整理
数据来源,去官网下载
https://www.gov.cn/banshi/2005-05/25/content_905.htm
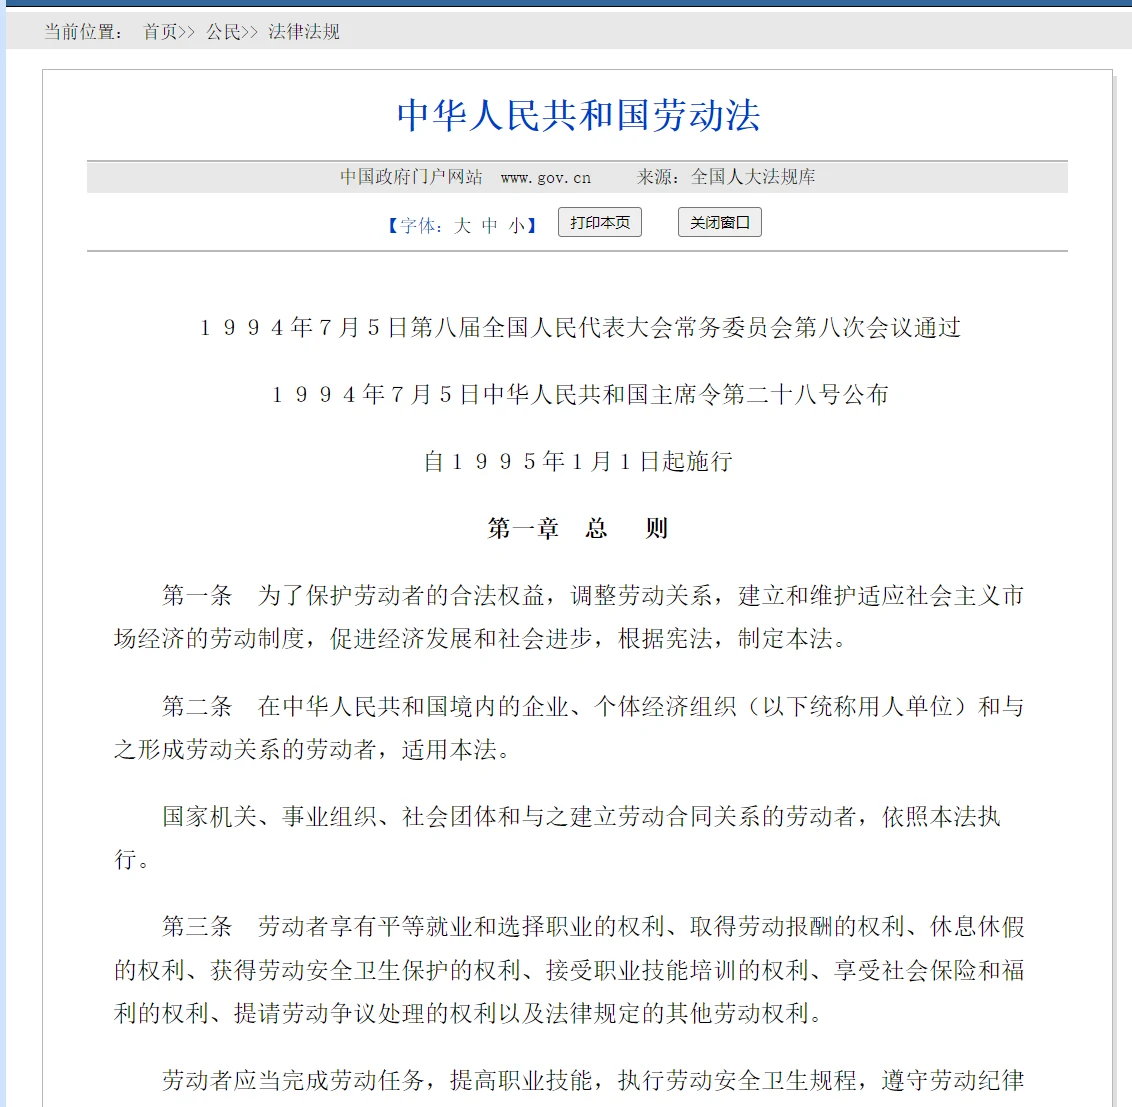
https://www.gov.cn/jrzg/2007-06/29/content_667720.htm
右键点击查看,可以看到我们所要信息都在标签 p 里面。
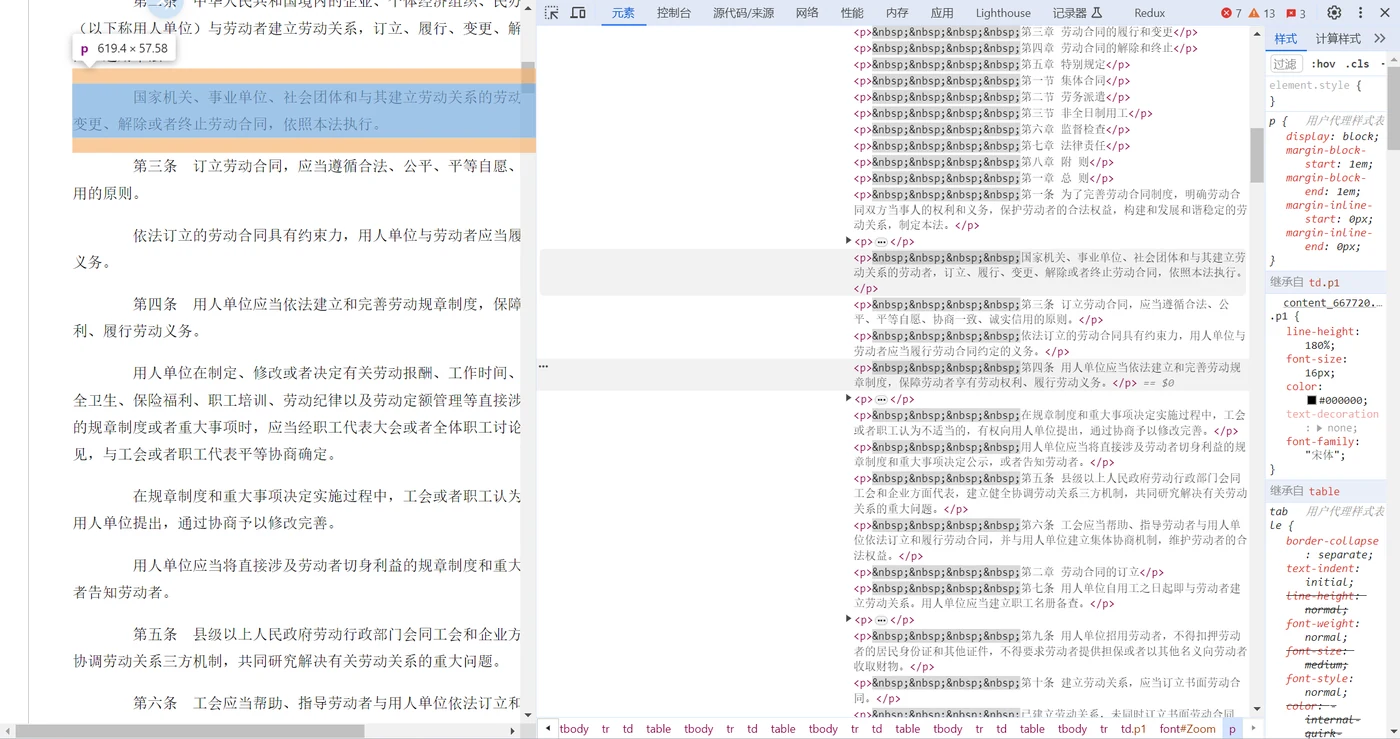
自动化解决办法通过爬虫和正则匹配下载和更新数据,不需要人为的再去定期查看网页是否有更新,再去同步信息。下载脚本
import json
import re
import requests
from bs4 import BeautifulSoup

def fetch_and_parse(url):
    # 请求网页
    response = requests.get(url)
    # 设置网页编码格式
    response.encoding = 'utf-8'
    # 解析网页内容
    soup = BeautifulSoup(response.text, 'html.parser')
    # 提取正文内容
    content = soup.find_all('p')
    # 初始化存储数据
    data = []
    # 提取文本并格式化
    for para in content:
        text = para.get_text(strip=True)
        if text:  # 只处理非空文本
            # 根据需求格式化内容
            data.append(text)
    # 将data列表转换为字符串
    data_str = '\n'.join(data)
    return data_str

def extract_law_articles(data_str):
    # 正则表达式,匹配每个条款号及其内容
    pattern = re.compile(r'第([一二三四五六七八九十零百]+)条.*?(?=\n第|$)', re.DOTALL)
    # 初始化字典来存储条款号和内容
    lawarticles = {}
    # 搜索所有匹配项
    for match in pattern.finditer(data_str):
        articlenumber = match.group(1)
        articlecontent = match.group(0).replace('第' + articlenumber + '条', '').strip()
        lawarticles[f"中华人民共和国劳动合同法 第{articlenumber}条"] = articlecontent
    # 转换字典为JSON字符串
    jsonstr = json.dumps(lawarticles, ensure_ascii=False, indent=4)
    return jsonstr

if __name__ == '__main__':
    # 请求页面
    url = "https://www.gov.cn/jrzg/2007-06/29/content_667720.htm"
    data_str = fetch_and_parse(url)
    jsonstr = extract_law_articles(data_str)
    print(jsonstr)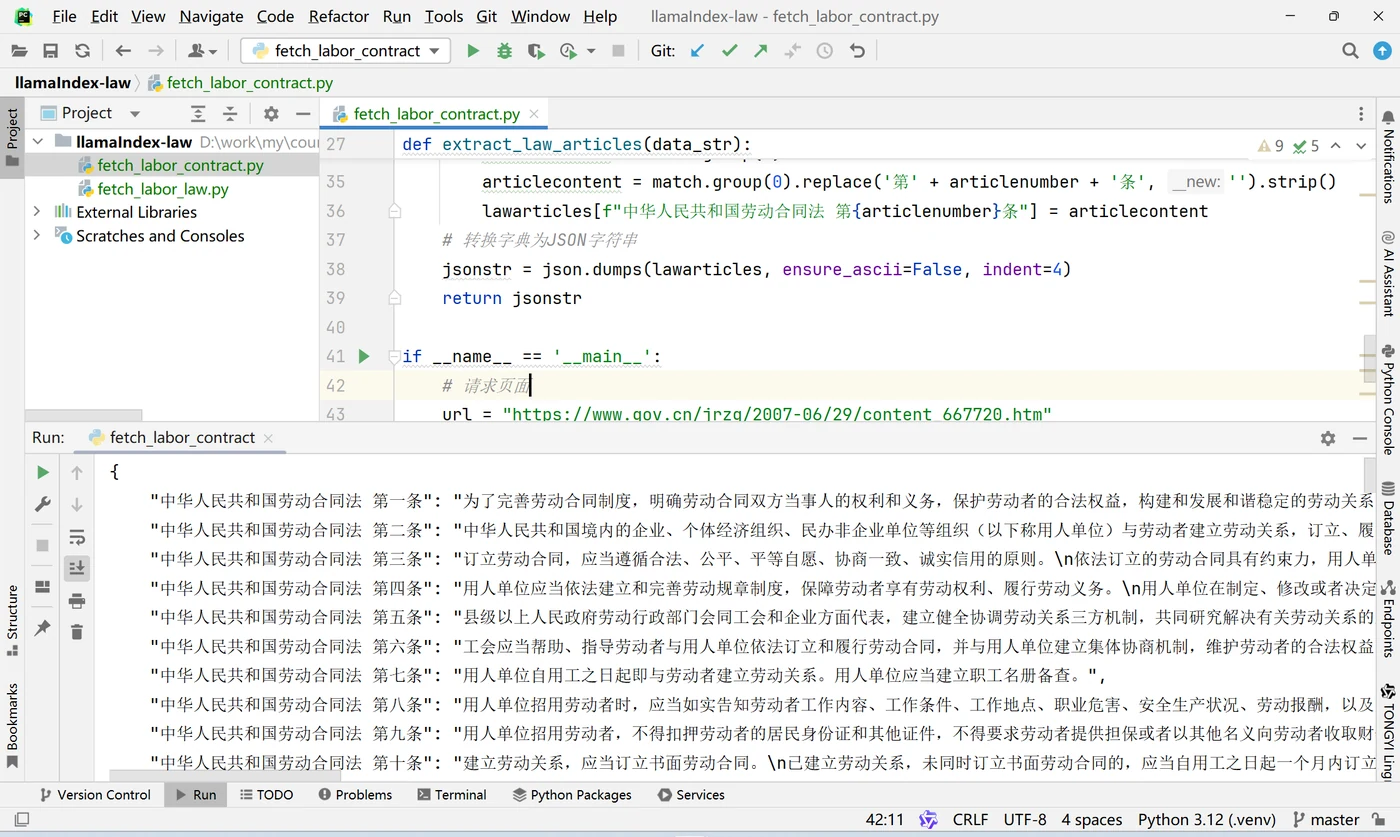
三、 核心实现流程
基于大语言模型(LLM)和向量检索(RAG)的法律智能助手,用于根据法律条文回答问题。以下是详细讲解:
1. 配置与模型初始化
1. 配置区
功能:定义了一个 Config 类,用于集中管理模型路径、数据目录、向量数据库目录、持久化目录、集合名称和检索结果数量(TOP_K)。关键点:EMBED_MODEL_PATH 和 LLM_MODEL_PATH 分别指定了用于嵌入(embedding)和生成回答的模型路径。DATA_DIR 存放法律条文的 JSON 文件。VECTOR_DB_DIR 和 PERSIST_DIR 分别用于存储向量数据库和持久化索引。COLLECTION_NAME 是向量数据库中的集合名称,用于存储法律条文的嵌入向量。
2. 模型初始化(init_models 函数)
功能:初始化嵌入模型(HuggingFaceEmbedding)和语言模型(HuggingFaceLLM),并验证模型是否正常加载。关键点:使用 HuggingFaceEmbedding 加载嵌入模型,用于将文本转换为向量。使用 HuggingFaceLLM 加载语言模型,用于生成回答。通过 test_embedding 验证嵌入模型的输出维度是否正确。将嵌入模型和语言模型设置到全局 Settings 中,供后续使用。