
一次搞定MySQL分库分表
《一次搞定MySQL分库分表》共 0.2 万字,通篇围绕 数据库、并发、缓存、场景 展开,归在「后端与系统架构」这一层。
适合给 AI 系统搭底座、要管得住的人
目录骨架(6 节)
- 一、数据库瓶颈
- 二、分库分表
- 三、分库分表工具
- 四、分库分表步骤
- 五、分库分表问题
- 六、分库分表总结
本次分享内容
- 数据库瓶颈
- 水平和垂直拆分库表
- 分库分表工具
- 分库分表步骤
- 分库分表问题
一、数据库瓶颈
不管是 IO 瓶颈,还是 CPU 瓶颈,最终都会导致数据库的活跃连接数增加,进而逼近甚至达到数据库可承载活跃连接数的阈值。在业务 Service 来看就是,可用数据库连接少甚至无连接可用。接下来就可以想象了吧(并发量、吞吐量、崩溃)。
1、IO 瓶颈
第一种:磁盘读 IO 瓶颈,热点数据太多,数据库缓存放不下,每次查询时会产生大量的 IO,降低查询速度 -> 分库和垂直分表。
第二种:网络 IO 瓶颈,请求的数据太多,网络带宽不够 -> 分库。
2、CPU 瓶颈
第一种:SQL 问题,如 SQL 中包含 join,group by,order by,非索引字段条件查询等,增加 CPU 运算的操作 -> SQL 优化,建立合适的索引,在业务 Service 层进行业务计算。
第二种:单表数据量太大,查询时扫描的行太多,SQL 效率低,增加 CPU 运算的操作 -> 水平分表。
二、分库分表
1、水平分库
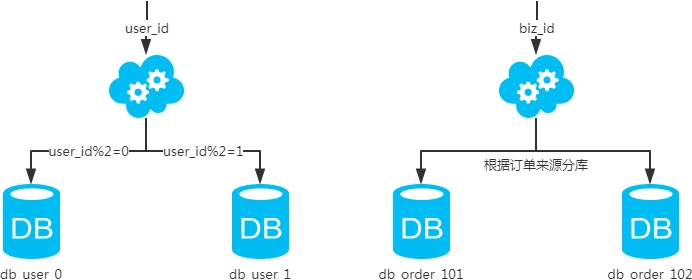
概念:
以字段为依据,按照一定策略(hash、range 等),将一个库中的数据拆分到多个库中。
结果:
- 每个库的结构都一样;
- 每个库的数据都不一样,没有交集;
- 所有库的并集是全量数据;
场景:
系统绝对并发量上来了,分表难以根本上解决问题,并且还没有明显的业务归属来垂直分库。
分析:
库多了,io 和 cpu 的压力自然可以成倍缓解。
2、水平分表
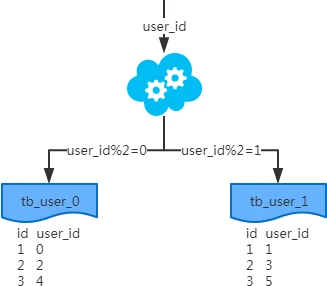
概念:
以字段为依据,按照一定策略(hash、range 等),将一个表中的数据拆分到多个表中。
结果:
- 每个表的结构都一样;
- 每个表的数据都不一样,没有交集;
- 所有表的并集是全量数据;
场景:
系统绝对并发量并没有上来,只是单表的数据量太多,影响了 SQL 效率,加重了 CPU 负担,以至于成为瓶颈。
分析:
表的数据量少了,单次 SQL 执行效率高,自然减轻了 CPU 的负担。
3、垂直分库
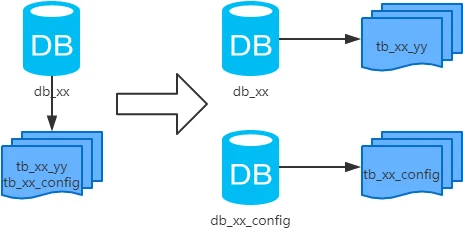
概念:
以表为依据,按照业务归属不同,将不同的表拆分到不同的库中。
结果:
- 每个库的结构都不一样;
- 每个库的数据也不一样,没有交集;
- 所有库的并集是全量数据;
场景:
系统绝对并发量上来了,并且可以抽象出单独的业务模块。
分析:
到这一步,基本上就可以服务化了。例如,随着业务的发展一些公用的配置表、字典表等越来越多,这时可以将这些表拆到单独的库中,甚至可以服务化。再有,随着业务的发展孵化出了一套业务模式,这时可以将相关的表拆到单独的库中,甚至可以服务化。
4、垂直分表
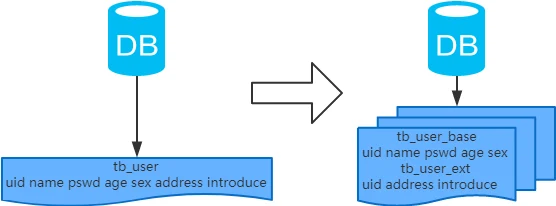
概念:
以字段为依据,按照字段的活跃性,将表中字段拆到不同的表(主表和扩展表)中。
结果:
- 每个表的结构都不一样;
- 每个表的数据也不一样,一般来说,每个表的字段至少有一列交集,一般是主键,用于关联数据;
- 所有表的并集是全量数据;
场景:
系统绝对并发量并没有上来,表的记录并不多,但是字段多,并且热点数据和非热点数据在一起,单行数据所需的存储空间较大。以至于数据库缓存的数据行减少,查询时会去读磁盘数据产生大量的随机读 IO,产生 IO 瓶颈。
分析:
可以用列表页和详情页来帮助理解。垂直分表的拆分原则是将热点数据(可能会冗余经常一起查询的数据)放在一起作为主表,非热点数据放在一起作为扩展表。这样更多的热点数据就能被缓存下来,进而减少了随机读 IO。拆了之后,要想获得全部数据就需要关联两个表来取数据。
但记住,千万别用 join,因为 join 不仅会增加 CPU 负担并且会讲两个表耦合在一起(必须在一个数据库实例上)。关联数据,应该在业务 Service 层做文章,分别获取主表和扩展表数据然后用关联字段关联得到全部数据。
三、分库分表工具
- Sharding-jdbc 这种 client 层方案的优点在于不用部署,运维成本低,不需要代理层的二次转发请求,性能很高,但是各个系统都需要耦合 Sharding-jdbc 的依赖,升级比较麻烦
- Mycat 这种 proxy 层方案的缺点在于需要部署,自己运维一套中间件,运维成本高,但是好处在于对于各个项目是透明的,如果遇到升级之类的都是自己中间件那里搞就行了
四、分库分表步骤
根据容量(当前容量和增长量)评估分库或分表个数 -> 选 key(均匀)-> 分表规则(hash 或 range 等)-> 执行(一般双写)-> 扩容问题(尽量减少数据的移动)。
假设系统目前有1亿用户:场景 10万写并发,100万读并发,60亿数据量设计时考虑极限情况,32库*32表~64个表,一共1000 ~ 2000张表