
有了虚拟线程,线程池还有必要存在吗
《有了虚拟线程,线程池还有必要存在吗》共 0.4 万字,通篇围绕 并发、上下文、吞吐、成本 展开,归在「后端与系统架构」这一层。
适合给 AI 系统搭底座、要管得住的人
目录骨架(8 节)
- 一. Java内部线程实现模式
- 二. 虚拟线程
- 三. 虚拟线程的使用
- 1.1 当前Java线程模型有什么问题吗?
- 1.2 一个IO密集型应用的例子
- 2.1 虚拟线程如何工作
- 2.2 虚拟线程和线程池的异同
- 什么情况需要保留线程池呢?
有了虚拟线程,线程池还有必要存在吗?
背景:
线程池可以重用固定数量的线程,避免了频繁创建和销毁线程的开销。然而,即使是线程池也无法完全解决上下文切换和资源消耗的问题,尤其是在高并发场景下。此外,大量的线程创建还可能导致OutOfMemoryError。
Java19引入了虚拟线程概念,java21新特性推出虚拟线程:
是轻量级线程(类似于 Go 中的 “协程(Goroutine)”),可以减少编写、维护和调度高吞吐量并发应用程序的工作量。
轻量级的线程在JVM的用户模式下被管理,而不是直接映射到操作系统的线程上。
当代码调用到阻塞操作时例如 IO、同步、Sleep等操作时,JVM 会自动把 Virtual Thread 从平台线程上卸载,平台线程就会去处理下一个虚拟线程,通过这种方式,提升了平台线程的利用率,让平台线程不再阻塞在等待上,从底层实现了少量平台线程就可以处理大量请求,提高了服务吞吐和 CPU 的利用率。
如图所示:
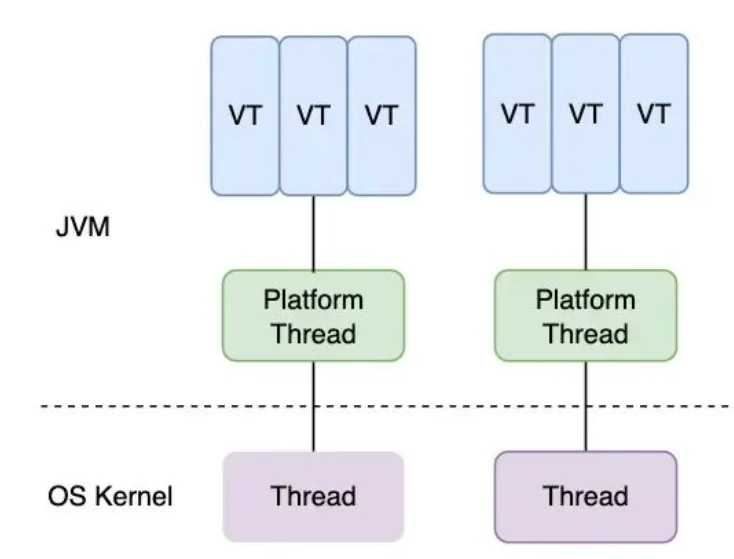
操作系统线程(OS Thread):由操作系统管理,是操作系统调度的基本单位。
平台线程(Platform Thread):传统方式使用的Java.Lang.Thread,都是一个平台线程,是 Java 对操作系统线程的包装,与操作系统是 1:1 映射。
虚拟线程(Virtual Thread):一种轻量级,由 JVM 管理的线程。对应的实例 java.lang.VirtualThread 这个类。
载体线程(Carrier Thread):指真正负责执行虚拟线程中任务的平台线程。一个虚拟线程装载到一个平台线程之后,那么这个平台线程就被称为虚拟线程的载体线程。
一. Java内部线程实现模式
绿色线程(Green Thread):远古时期,Java使用绿色线程模式。这个模式下,多线程的调度和管理有JVM完成。绿色线程模式才作用M:1线程映射模型。这里就有一个问题,Java不能够规模化管理这种线程,也就无法充分发挥硬件性能。同样的实现绿色线程也是一件非常有挑战性的事情,因为它需要非常底层的支持才能够良好运行。随后Java移除了绿色线程,转而使用本地线程。这使得Java的线程执行比绿色线程更慢。
平台线程(Platform Thread):从Java 1.2开始从绿色线程切换到了平台线程模式(有些人称之为本地线程(Native Thread))。在操作系统的帮助下,JVM 得以控制平台线程。平台线程的执行效率很高,但是开启和关闭他们的资源消耗较大。这就是为什么我们现在要使用线程池。这个模型遵循着 1:1 线程映射,即一个Java线程映射到一个内核线程。当一个Java线程被创建时,相应的一个对应的核心线程也会被创建,用来执行线程代码。自此之后,平台线程模型的做法就延续到了今天。
1.1 当前Java线程模型有什么问题吗?
只是对于操作系统内核线程的一个简单包装,真正的线程调度,还是由操作系统完成;
因为线程的创建和销毁都需要系统内核完成,涉及用户态切换,资源消耗较大;
本地线程需要保存他们的调用栈在内存中,大概2MB~20MB的预留空间。如果你有4GB内存,如果每个线程占用20MB内存,那么你就只能创建大概200个线程;
因为本地线程是一种系统资源,加载一个新的本地线程大概需要1毫秒;
上下文切换代价昂贵,需要一个到内核的系统调用;
上面这些强制性的限制会限制线程创建的数量,同时会导致性能下降和过度的内存消耗。因为我们不能创建更多的线程;
我们不能通过增加更多的线程来增应用规模,因为上下文切换和内存占用的代价高昂;
1.2 一个IO密集型应用的例子
考虑一台16GB内存的网络服务器。对于每个服务请求,都分配一个不同的线程。我们假设每个线程需要20MB内存空间,那么这台机器可以支持800个线程。当前,后端的API一般使用REST/SOAP调用方式,例如数据库操作和API信息转发这些IO密集型操作。由此可见,后端服务的主要是IO密集型而不是CPU密集型。
接着假设一下,一个IO操作需要100毫秒,请求执行(IO密集型)需要100毫秒,以及返回结果也需要100毫秒。同时,当每秒有800个请求时,线程数得到了最大容量。
让我们来计算一下单个请求的CPU占用时间
CPU时间 = 请求准备时间 + 返回结果准备时间
= 0.1ms + 0.1ms
= 0.2ms
对于800个请求呢?
800个线程的请求时间= 800 * 0.2ms
= 160ms
受限于我们的内存容量,我们只能创建800个请求,也就导致了我们CPU使用率并不高
CPU使用率=160ms / 1000ms
= 16%
那么如何才能使CPU的利用率到达90%呢?
16% = 800个线程
90% = X个线程
X = 4500
但是我们当前因为内存的限制不能创建那么多的线程,除非我们能突破这个限制,拥有90G内存。
90G的内存是一个比较离谱的数字,所以说创建本地线程很明显不能充分利用硬件资源。