
结合SpringBoot多线程应用最佳实践
《结合SpringBoot多线程应用最佳实践》共 0.7 万字,通篇围绕 数据库、Redis、场景、延迟 展开,归在「后端与系统架构」这一层。
适合给 AI 系统搭底座、要管得住的人
目录骨架(8 节)
- 一:多线程方案:使用线程池。
- 二:等待多线程执行完毕
- 三:如何排序:
- 一、JDK自带的延时队列
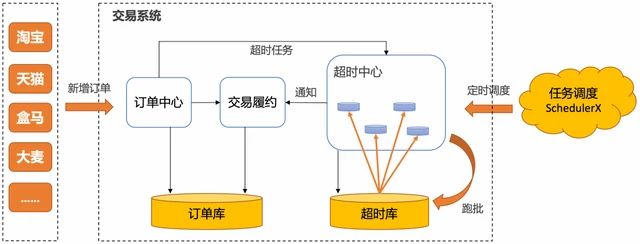
- 二、定时任务分布式批处理
- 
- 三、Redis的过期监听
- 四、RabbitMQ的延时消息
SpringBoot优雅开发的多线程应用
场景:
获取一次主要数据
遍历第1步的主数据,对每一个数据,都以它为条件获取次要数据
将前2步查到的数据组合起来,返回给前端
那么问题来了,如果单次调获取数据比较慢,那么获取多个数据时会很费时间。最好的解决方法就是使用多线程处理。
需求:
假设需要提供一个接口,获得多个订单的信息,按创建时间由近到远排序。这个订单信息在其他公司那里,他们只提供了查单个订单的接口,没有批量的接口。
数据库表结构
订单的字段:订单id、用户id、总金额、商品id、商品的数量、创建时间 等。
用户的字段:用户id、用户名字、用户的电话、注册时间 等。
商品的字段:商品id、商品名字 等。
业务流程
调第三方读出订单主要数据的前n行
用第1步的每个数据的用户id去调第三方获取用户的信息
将第2步获取到的用户信息整合到订单VO里。
说明
本处为了简单,用这种方法处理:
仅获取订单的id、用户id、用户名字。
使用模拟数据,不实际调用接口。用sleep()模拟对数据库的操作。
所有代码都在controller层处理。(实际业务中肯定要放到service中处理)。
思路汇总
一:多线程方案:使用线程池。
线程池回顾:
1.1 在线程池的实践中,我们一般要通过ThreadPoolExecutor的构造函数来声明线程池,避免使用Executors类创建线程池,否则会有OOM风险,原因如下:
FixedThreadPool 和 SingleThreadExecutor : 使用的是无界的 LinkedBlockingQueue,任务队列最大长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。CachedThreadPool :使用的是同步队列 SynchronousQueue, 允许创建的线程数量为 Integer.MAX_VALUE ,可能会创建大量线程,从而导致 OOM。ScheduledThreadPool 和 SingleThreadScheduledExecutor : 使用的无界的延迟阻塞队列DelayedWorkQueue,任务队列最大长度为 Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。
1.2 不同业务用不同的线程池 。配置线程池的时候要根据当前业务的情况对当前线程池进行配置,因为不同的业务的并发以及对资源的使用情况都不同,而且当多个业务使用同一个线程池时,可能会因为线程池使用不当导致死锁
1.3 监测线程池运行状态
1.4 给线程池命名
1.5 正确配置线程池参数。公式如下:
CPU 密集型任务(N+1): 这种任务消耗的主要是 CPU 资源,可以将线程数设置为 N(CPU 核心数)+1。比 CPU 核心数多出来的一个线程是为了防止线程偶发的缺页中断,或者其它原因导致的任务暂停而带来的影响。一旦任务暂停,CPU 就会处于空闲状态,而在这种情况下多出来的一个线程就可以充分利用 CPU 的空闲时间。I/O 密集型任务(2N): 这种任务应用起来,系统会用大部分的时间来处理 I/O 交互,而线程在处理 I/O 的时间段内不会占用 CPU 来处理,这时就可以将 CPU 交出给其它线程使用。因此在 I/O 密集型任务的应用中,我们可以多配置一些线程,具体的计算方法是 2N。
示范代码:
线程配置类 注意加上[@Configuration](/Configuration ) 和[@EnableAsync](/EnableAsync ) 里面配置executor核心参数。
package com.young.config;

import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import java.util.concurrent.Executors;
import java.util.concurrent.LinkedBlockingDeque;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;

@Configuration
@EnableAsync
public class ThreadPoolConfig {

    //在某个项目中看到的一个线程池创建方式
    @Bean
    @Qualifier(value = "threadPoolExecutor")
    public ThreadPoolExecutor threadPoolExecutor(){
        return new ThreadPoolExecutor(Runtime.getRuntime().availableProcessors(),
                (int)(Runtime.getRuntime().availableProcessors()/(1-0.9)),
                60, TimeUnit.SECONDS,
                new LinkedBlockingDeque<>(Runtime.getRuntime().availableProcessors()), Executors.defaultThreadFactory(),
                new ThreadPoolExecutor.CallerRunsPolicy());
    }