
训练、微调与数据图文讲义2804 字
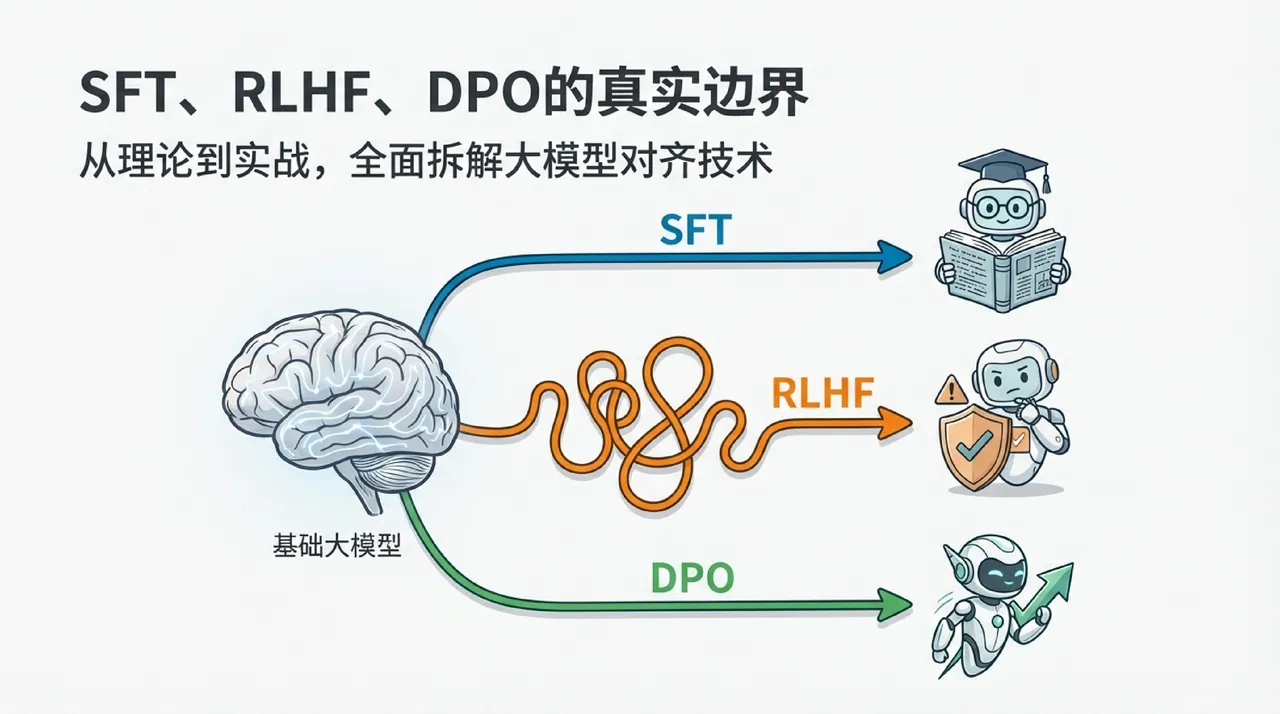
SFT、RLHF、DPO的真实边界
·全库 20 / 611
《SFT、RLHF、DPO的真实边界》共 20 页、0.3 万字,通篇围绕 SFT、RLHF、DPO、安全 展开,归在「训练、微调与数据」这一层。
覆盖SFTRLHFDPO安全成本对齐
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(8 节)
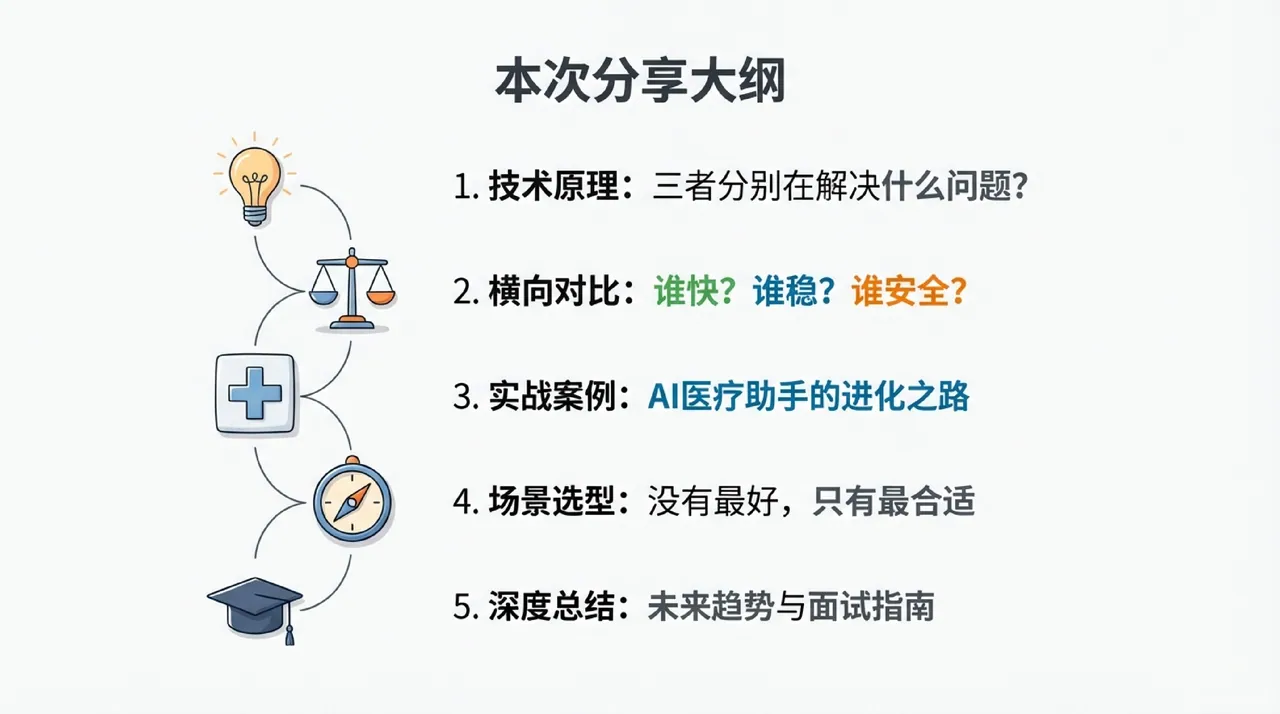
- SFT、RLHF、DPO 的真实边界
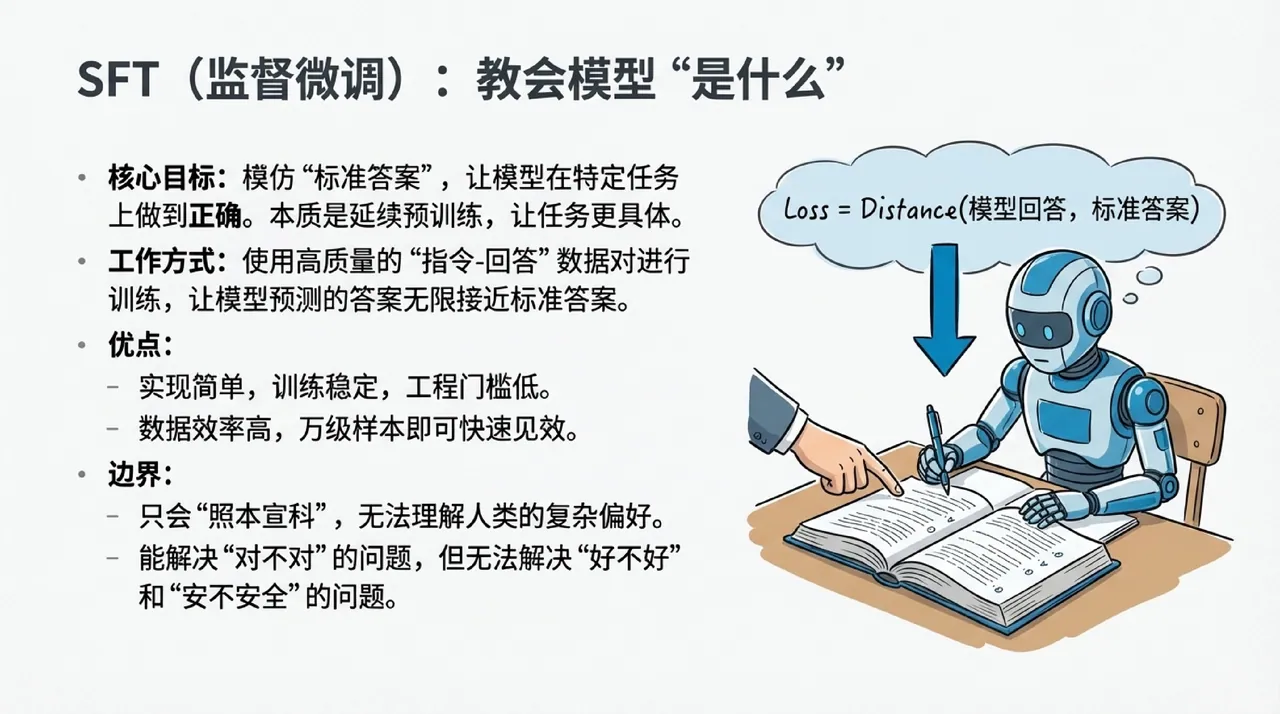
- SFT (监督微调):教会模型“是什么”
- RLHF (人类反馈强化学习):教会模型“好不好”
- DPO (直接偏好优化):更聪明地“择优录取”
- 原理小结:从“学会知识”到“学会做人”
- 横向对比一:训练稳定性与数据效率
- 横向对比二:安全性与伦理控制
- 横向对比三:成本与迭代速度
原 PDF 已逐页还原成图,共 20 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。
011 / 3
第 1 页
SFT、RLHF、DPO 的真实边界
022 / 3
第 2 页
本次分享大纲 1.技术原理:三者分别…
033 / 3
第 3 页