训练、微调与数据图文讲义1829 字

LoRA微调从原理到调参

·全库 62 / 611

《LoRA微调从原理到调参》共 14 页、0.2 万字,通篇围绕 LoRA、微调、预训练、部署 展开,归在「训练、微调与数据」这一层。

覆盖LoRA微调预训练部署数据集GPU

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(8 节)
  1. LORA 微调:从原理到调参
  2. 本“百科全书”
  3. 全量微调的“两大痛点”:资源与管理的噩梦
  4. 书”贴一张“补充说明”
  5. LORA 的三大核心优势
  6. 核心原理:权重更新的低秩近似
  7. 参数量如何实现万倍压缩?
  8. 理论支撑:奇异值分解(SVD)的启示

原 PDF 已逐页还原成图,共 14 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01LORA 微调:从原理到调参
  2. 02本次分享大纲:M“为什么”到“是什么…
  3. 03本“百科全书”
011 / 3
第 1 页:LORA 微调:从原理到调参
第 1 页

LORA 微调:从原理到调参

AI 大模型时代的“轻”功秘籍

022 / 3
第 2 页
第 2 页

本次分享大纲:M“为什么”到“是什么…

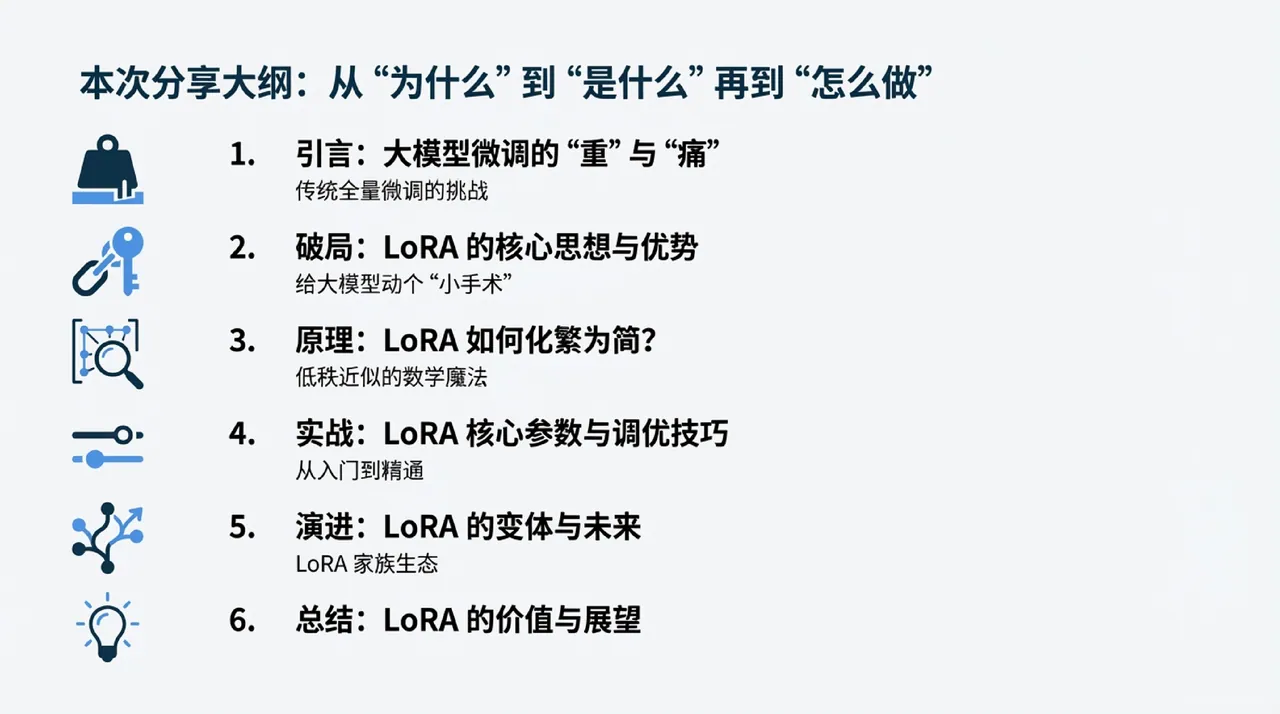
本次分享大纲:M“为什么”到“是什么”再到“怎么做”

1 .引言:大模型微调的“重”与“痛”

传统全量微调的挑战

2 .破局:LORA 的核心思想与优势

给大模型动个“小手术”

原理:LoRA 如何化繁为简? 3. 低秩近似的数学魔法

  1. 实战:LORA 核心参数与调优技巧

从入门到精通

  1. 演进:LORA 的变体与未来

LoRA 家族生态

  1. 总结:LORA 的价值与展望
033 / 3
第 3 页:本“百科全书”
第 3 页

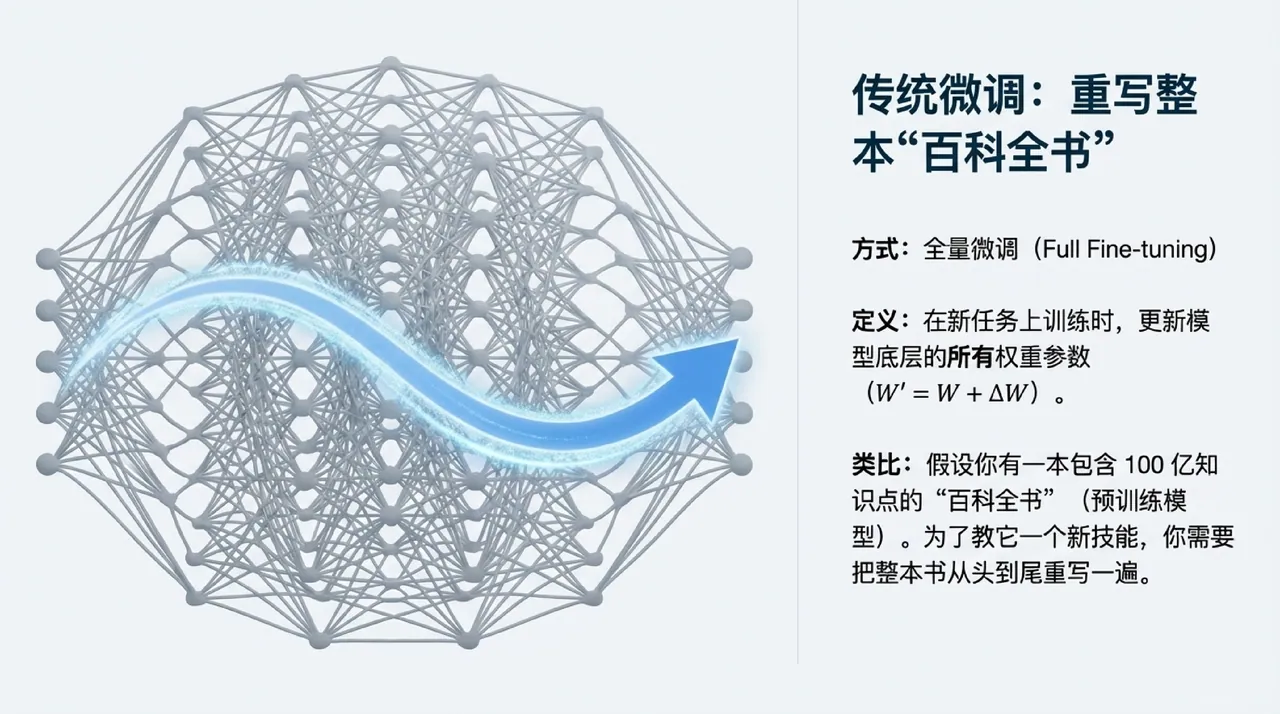
本“百科全书”

传统微调:重写整

方式:全量微调(Full Fine-tuning)

定义:在新任务上训练时,更新模 型底层的所有权重参数

类比:假设你有一本包含 100 亿知 识点的“百科全书”(预训练模 型)。为了教它一个新技能,你需要 把整本书从头到尾重写一遍。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求