模型架构与原理图文讲义1019 字

多头自注意力机制深度解析

·全库 28 / 611

《多头自注意力机制深度解析》共 20 页、0.1 万字,通篇围绕 Attention、embedding、上下文、Transformer 展开,归在「模型架构与原理」这一层。

覆盖Attentionembedding上下文Transformer向量医疗

适合要跟模型团队对话、得听懂他们在说什么的人

目录骨架(8 节)
  1. 多头自注意力机制深度解析
  2. |本质理解:超级线性组合体
  3. |宏观定位:Transformer 架构中的主角
  4. I 数据的三重奏:Query,Key,Value
  5. 线性投影:数据的不同'视阙'
  6. 为什么要'多头'(Multi-Head)?
  7. 独立的子空间学习
  8. 多头机制的工作流

原 PDF 已逐页还原成图,共 20 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01多头自注意力机制深度解析
  2. 02核心概念 Q、K、V 与多头设计原理
  3. 03计算(Calculation)
011 / 3
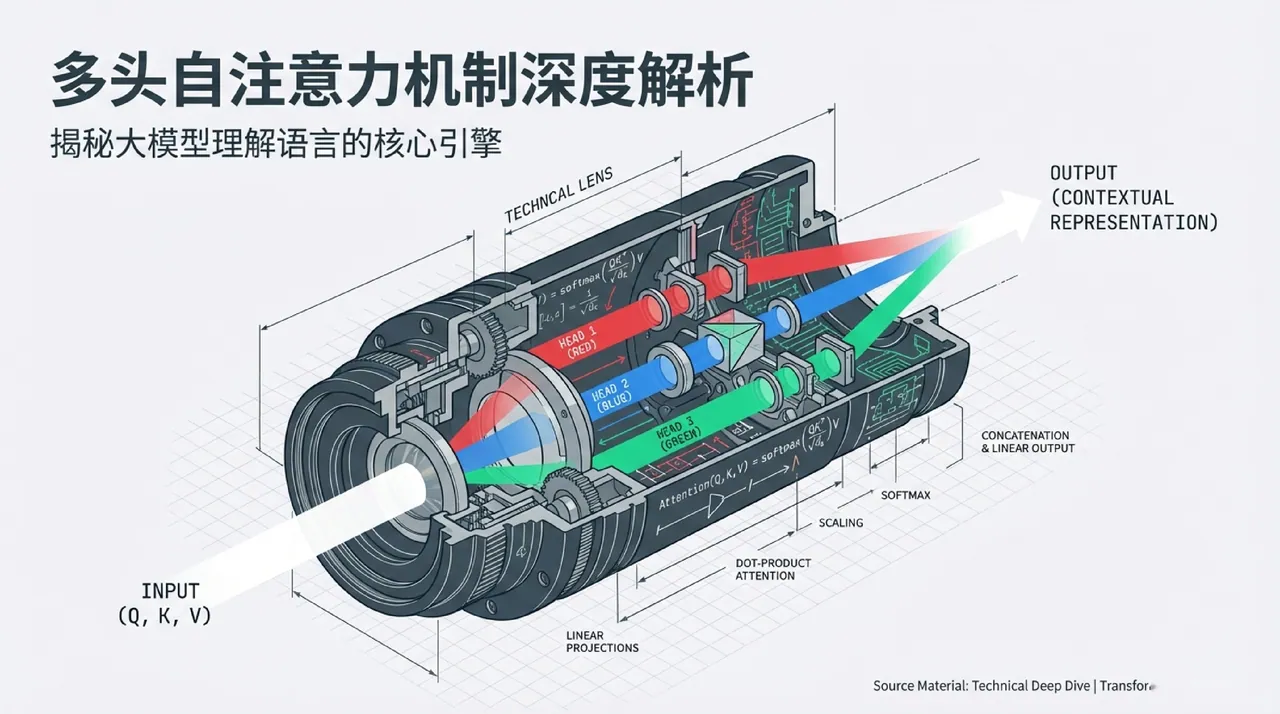
第 1 页:多头自注意力机制深度解析
第 1 页

多头自注意力机制深度解析

揭秘大模型理解语言的核心引擎

INPUT

OUTPUT (CONTEXTUAL REPRESENTATION)

CONCATENATION & LINEAR OUTPUT

SCALING

DOT-PRODUCT ATTENTION

Source Material: Technical Deep Dive Transfore

(RED) HEAD

LINEAR PROJECTIONS

022 / 3
第 2 页
第 2 页

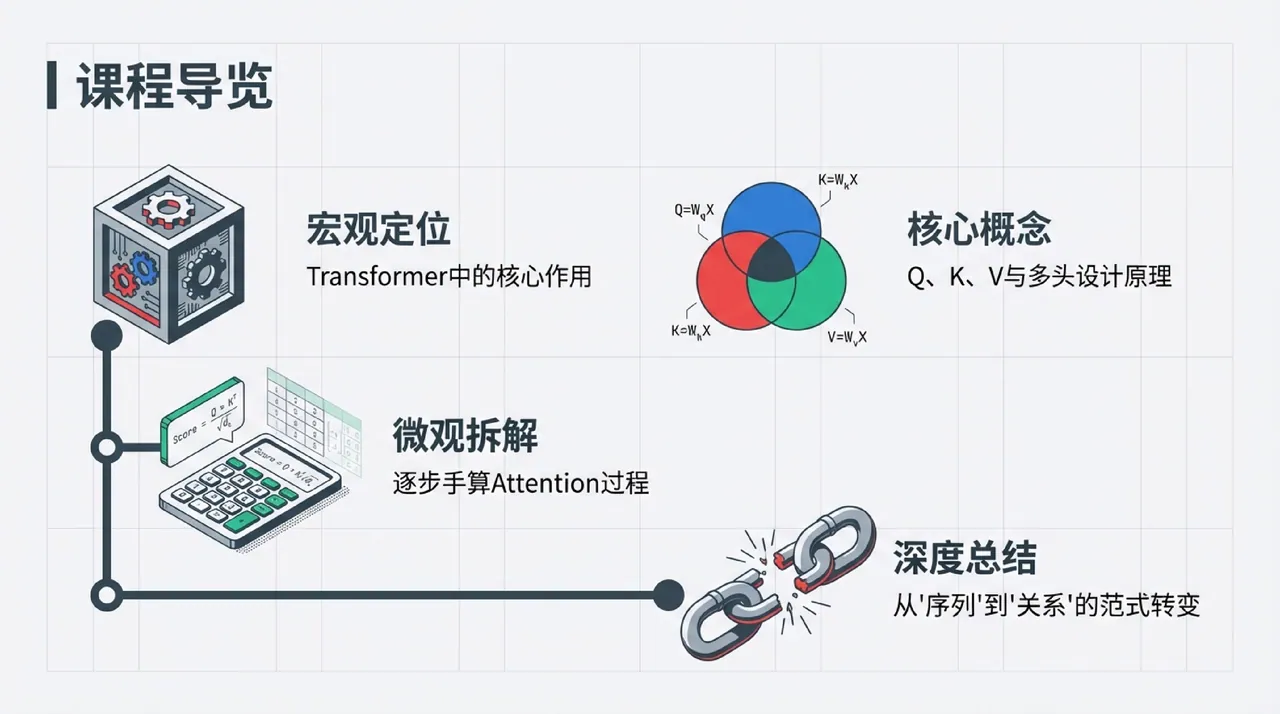
核心概念 Q、K、V 与多头设计原理

核心概念 Q、K、V 与多头设计原理

深度总结

从'序列到'关系'的范式转变

宏观定位 Transformer 中的核心作用

微观拆解

逐步手算 Attention 过程

033 / 3
第 3 页
第 3 页

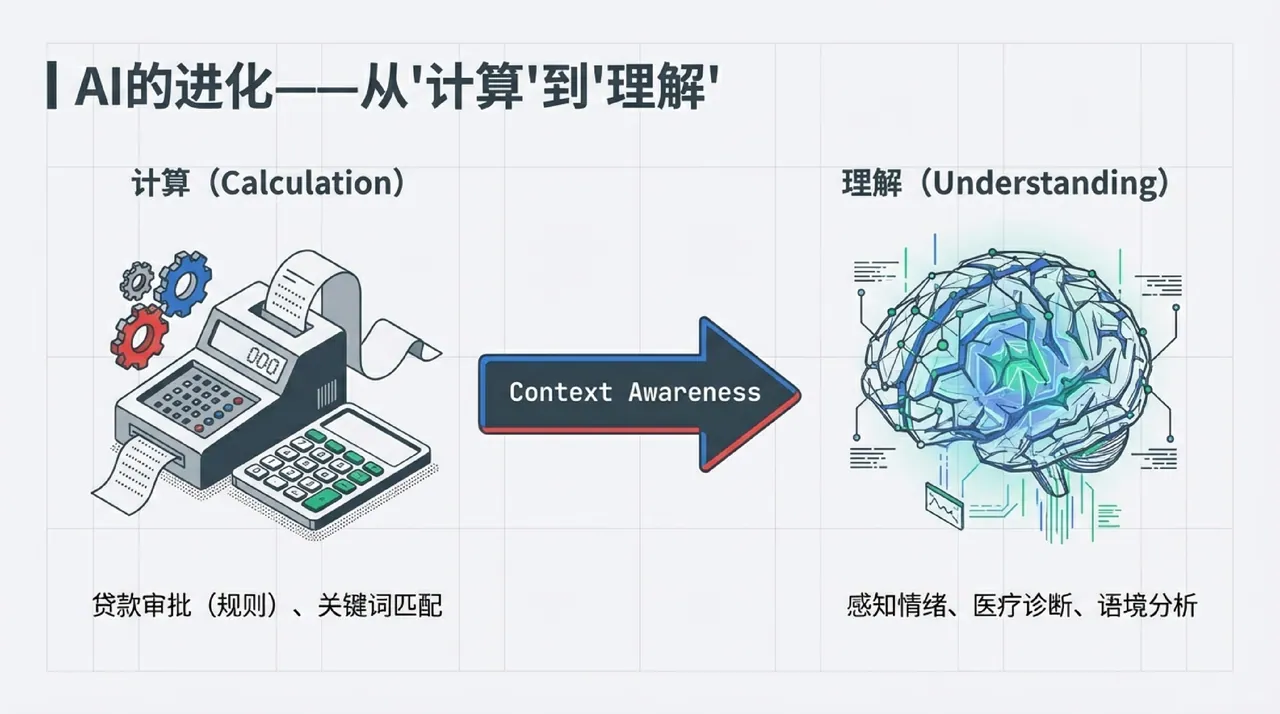
计算(Calculation)

计算(Calculation)

贷款审批(规则)、关键词匹配

理解(Understanding)

感知情绪、医疗诊断、语境分析

Context Awareness

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求