模型架构与原理图文讲义1812 字

多模态Vision Transformer

·全库 38 / 611

《多模态Vision Transformer》共 15 页、0.2 万字,通篇围绕 Transformer、架构、数据集、Attention 展开,归在「模型架构与原理」这一层。

覆盖Transformer架构数据集Attention向量预训练

适合要跟模型团队对话、得听懂他们在说什么的人

目录骨架(8 节)
  1. 多模态 Vision Transformer
  2. 探索之旅:从像素到语义
  3. 两条道路:CNN 与 Transformer 的设计哲学
  4. 第 1 步:从像素到向量(Patch Embedding)
  5. 第 2 步:注入上下文信息
  6. 第 3 步:进入核心-标准 Transformer 编码器
  7. 架构蓝图:ViT 完整流程
  8. ImageNet 上的 Top-1 准确率

原 PDF 已逐页还原成图,共 15 页,这里先放前 3 页,其中 3 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01多模态 Vision Transformer
  2. 02探索之旅:从像素到语义
  3. 03两条道路:CNN 与 Transformer 的设计哲学
011 / 3
第 1 页:多模态 Vision Transformer
第 1 页

多模态 Vision Transformer

当 Transformer 睁开双眼:深入解析 ViT 架构,开启视觉与语言融合的新纪元

022 / 3
第 2 页:探索之旅:从像素到语义
第 2 页

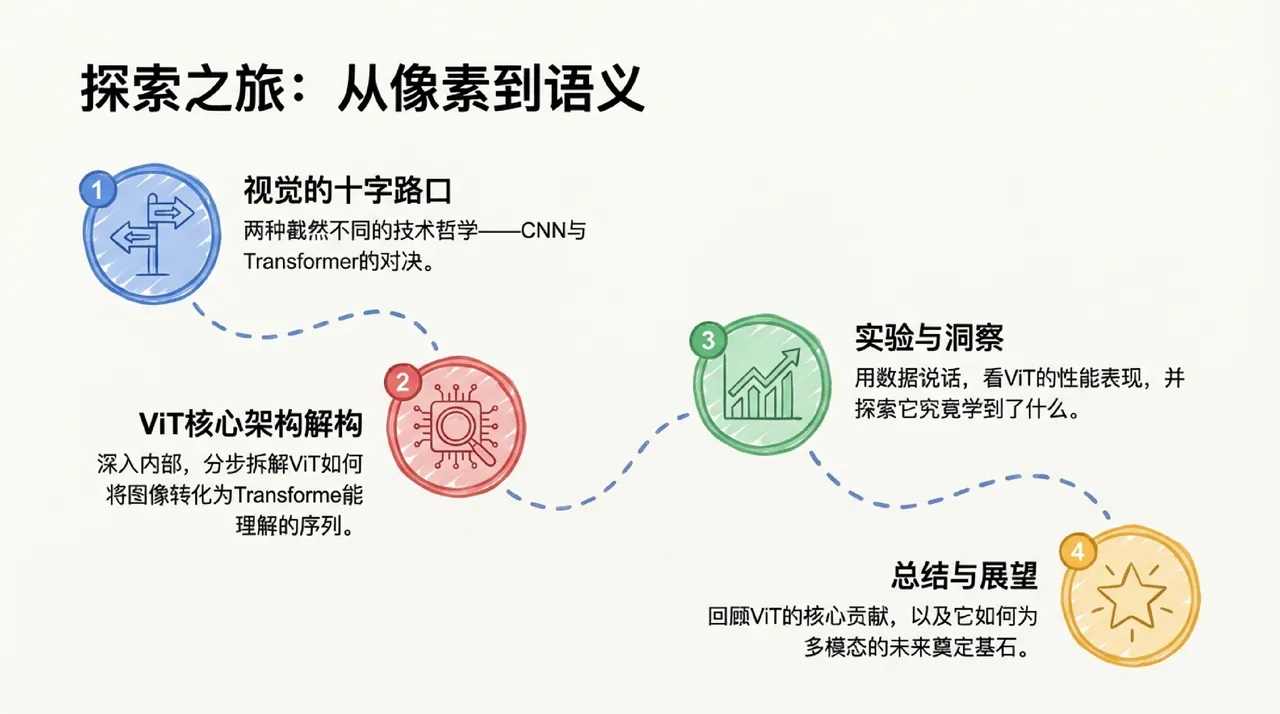
探索之旅:从像素到语义

视觉的十字路口 两种截然不同的技术哲学—CNN 与 Transformer 的对决。

ViT 核心架构解构 深入内部,分步拆解 ViT 如何 将图像转化为 Transforme 能 理解的序列。

实验与洞察 用数据说话,看 ViT 的性能表现,并 探索它究竟学到了什么。

总结与展望 回顾 ViT 的核心贡献,以及它如何为 多模态的未来奠定基石。

033 / 3
第 3 页:两条道路:CNN 与 Transformer 的设计哲学
第 3 页

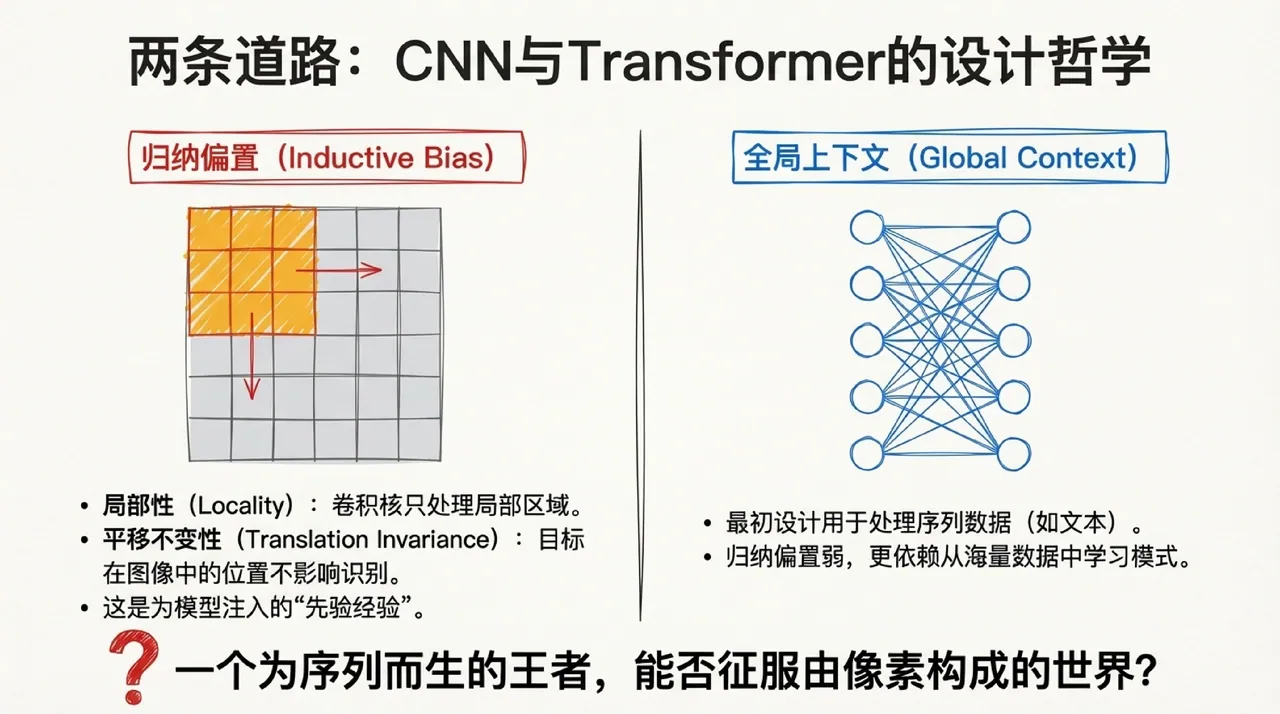
两条道路:CNN 与 Transformer 的设计哲学

全局上下文(Global Context)

  • 最初设计用于处理序列数据(如文本)。
  • 归纳偏置弱,更依赖从海量数据中学习模式。

归纳偏置(Inductive Bias)

  • 局部性(Locality):卷积核只处理局部区域。
  • 平移不变性(Translation Invariance):目标 在图像中的位置不影响识别。

•这是为模型注入的“先验经验”。

?一个为序列而生的王者,能否征服由像素构成的世界?

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求