模型架构与原理图文讲义1652 字

MoE架构深度拆解

·全库 45 / 611

《MoE架构深度拆解》共 14 页、0.2 万字,通篇围绕 MoE、Transformer、成本、算力 展开,归在「模型架构与原理」这一层。

覆盖MoETransformer成本算力Attention推理

适合要跟模型团队对话、得听懂他们在说什么的人

目录骨架(8 节)
  1. 大模型背后的秘密:MoE 架构深度拆解
  2. 一个 Token 的旅程:稀疏激活如何工作?
  3. 核心优势:用更少的计算,实现更强的性能
  4. Scaling Law 依然有效:专家越多,模型越“聪明”
  5. 各司其职:专家们真的“学有所长”吗?
  6. 路由策略对决:Token Choice vs.Expert Choice
  7. 进阶技巧:从共享专家到专家粒度
  8. 深度总结:一张图看懂 MoE 架构

原 PDF 已逐页还原成图,共 14 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01大模型背后的秘密:MoE 架构深度拆解
  2. 02甜蜜的烦恼:当“大力出奇迹”遇上算力…
  3. 03本次探索之旅:四步拆解 MoE
011 / 3
第 1 页:大模型背后的秘密:MoE 架构深度拆解
第 1 页

大模型背后的秘密:MoE 架构深度拆解

从 Mixtral 到 Gemini,揭示万亿参数模型高效运作的原理

022 / 3
第 2 页
第 2 页

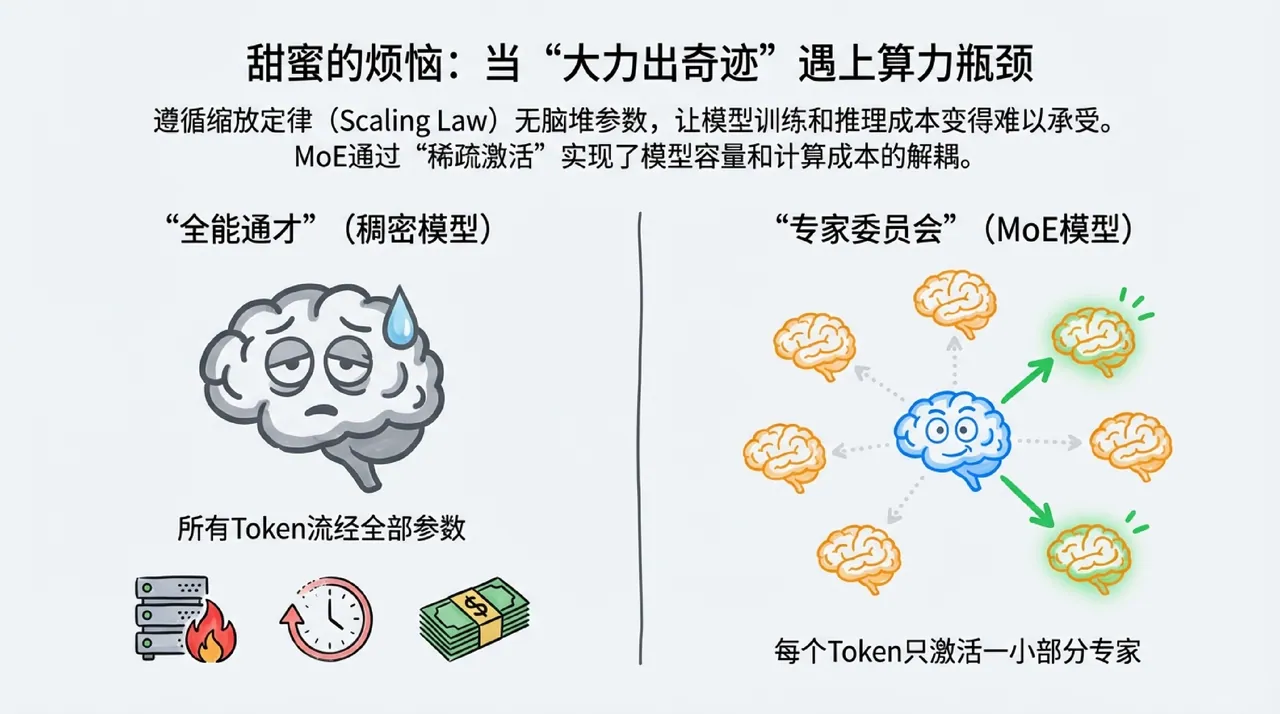
甜蜜的烦恼:当“大力出奇迹”遇上算力…

甜蜜的烦恼:当“大力出奇迹”遇上算力瓶颈

遵循缩放定律(Scaling Law)无脑堆参数,让模型训练和推理成本变得难以承受。 MoE 通过“稀疏激活”实现了模型容量和计算成本的解耦。 “全能通才”(稠密模型)

所有 Token 流经全部参数

“专家委员会"

每个 Token 只激活一小部分专家

(MoE 模型)

033 / 3
第 3 页
第 3 页

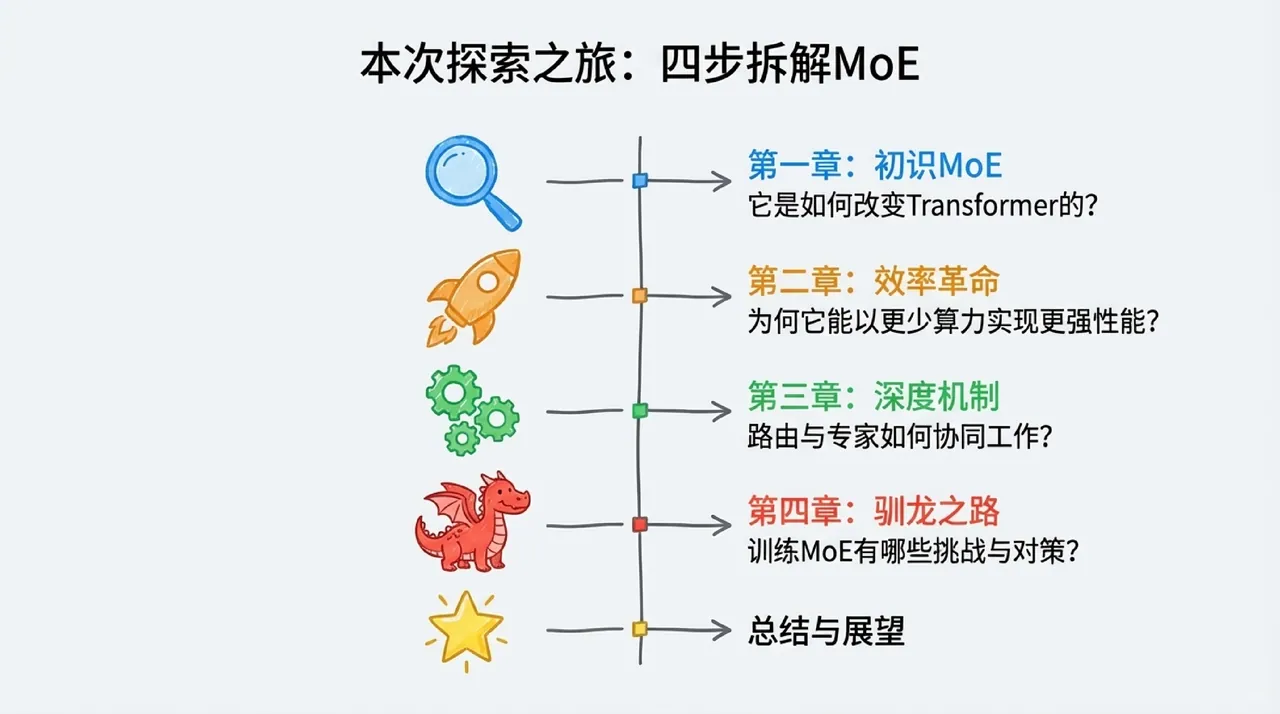
本次探索之旅:四步拆解 MoE

本次探索之旅:四步拆解 MoE

第一章:初识 MoE 它是如何改变 Transformer 的? 第二章:效率革命 为何它能以更少算力实现更强性能? 第三章:深度机制 路由与专家如何协同工作? 第四章:驯龙之路 训练 MoE 有哪些挑战与对策? 总结与展望

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求