模型架构与原理图文讲义2100 字

混合专家模型MoE

·全库 78 / 611

《混合专家模型MoE》共 14 页、0.2 万字,通篇围绕 MoE、微调、推理、Transformer 展开,归在「模型架构与原理」这一层。

覆盖MoE微调推理Transformer显存架构

适合要跟模型团队对话、得听懂他们在说什么的人

目录骨架(8 节)
  1. 混合专家模型(MoE):稀疏的力量,解锁万亿参数时代
  2. 密集模型的“天花板”:所有参数处理所有输入
  3. 解决方案:稀疏化与条件计算
  4. MoE 核心理念:一个拥有专业部门的大型组织
  5. MoE 架构解析:嵌入 Transformer 的专家层
  6. MoE 的演进之路:从学术概念到行业标准
  7. 训练挑战:如何避免专家“偏科”?
  8. MoE 的并行计算策略

原 PDF 已逐页还原成图,共 14 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01混合专家模型(MoE):稀疏的力量,解锁万亿参数时代
  2. 02议程:从核心理念到工程实践
  3. 03密集模型的“天花板”:所有参数处理所有输入
011 / 3
第 1 页:混合专家模型(MoE):稀疏的力量,解锁万亿参数时代
第 1 页

混合专家模型(MoE):稀疏的力量,解锁万亿参数时代

深入解析下一代大模型的架构基石

022 / 3
第 2 页
第 2 页

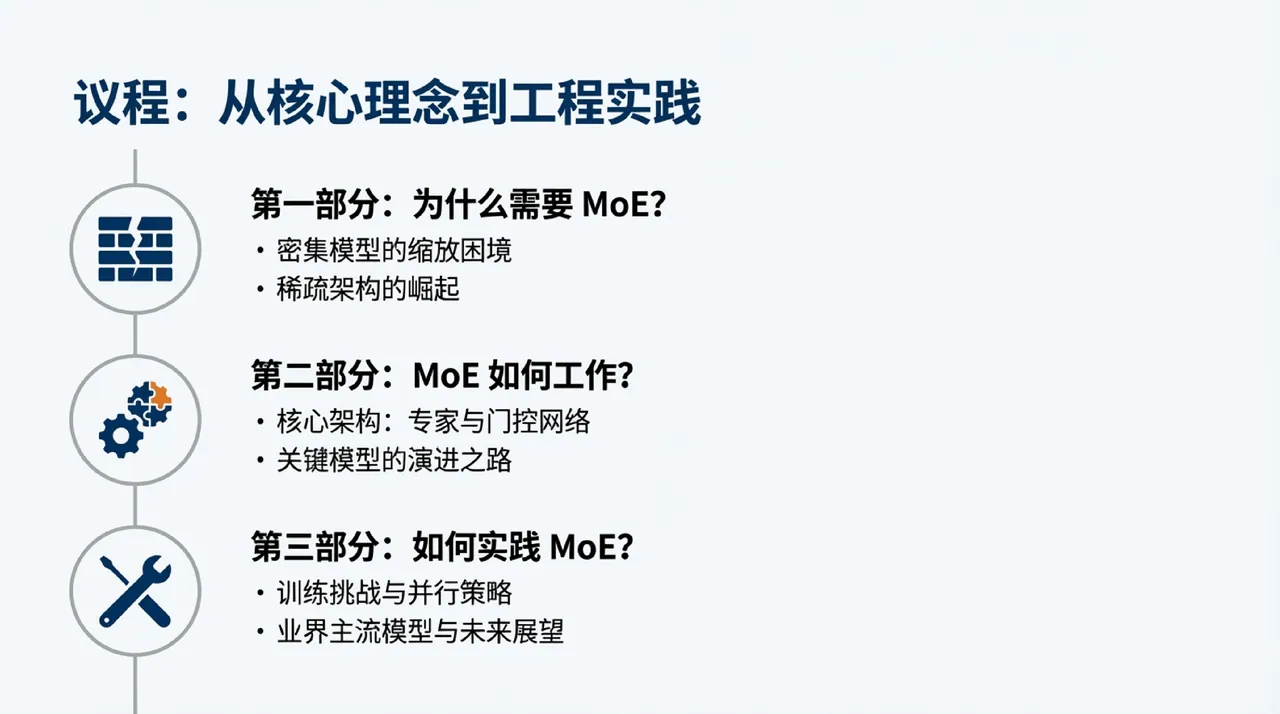
议程:从核心理念到工程实践

议程:从核心理念到工程实践

  • 第一部分:为什么需要 MoE?
  • 密集模型的缩放困境
  • 稀疏架构的崛起
  • 第二部分:MoE 如何工作?
  • 核心架构:专家与门控网络
  • 关键模型的演进之路

第三部分:如何实践 MoE?

  • 训练挑战与并行策略
  • 业界主流模型与未来展望
033 / 3
第 3 页:密集模型的“天花板”:所有参数处理所有输入
第 3 页

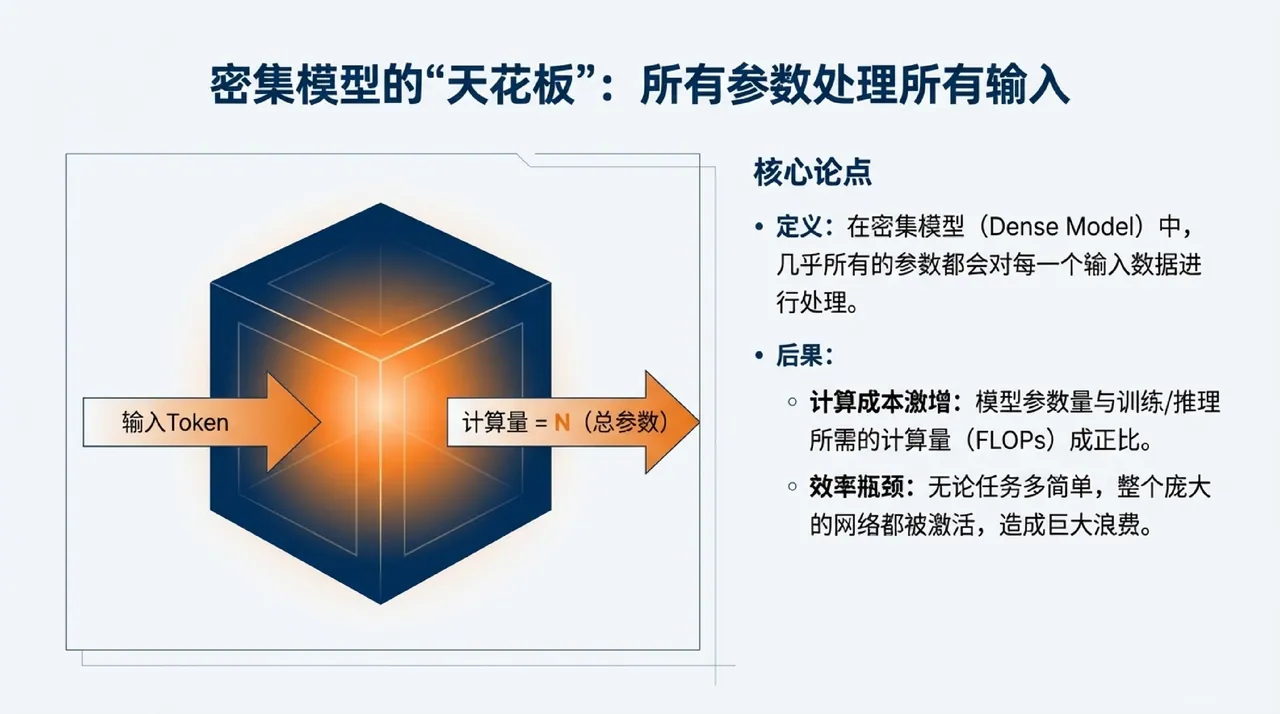
密集模型的“天花板”:所有参数处理所有输入

核心论点 •定义:在密集模型(Dense Model)中, 几乎所有的参数都会对每一个输入数据进 行处理。

•计算成本激增:模型参数量与训练/推理 所需的计算量(FLOPs)成正比。 。效率瓶颈:无论任务多简单,整个庞大 的网络都被激活,造成巨大浪费。

计算量=N (总参数)

输入 Token

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求