训练、微调与数据图文讲义1674 字

模型微调数据集创建工具Easy dataset

·全库 88 / 611

《模型微调数据集创建工具Easy dataset》共 12 页、0.2 万字,通篇围绕 数据集、微调、部署、Docker 展开,归在「训练、微调与数据」这一层。

覆盖数据集微调部署Docker安全多模态

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(8 节)
  1. 模型微调数据集创建工具:Easy dataset
  2. 本次分享大纲
  3. 微调的成败,七分靠数据
  4. 现有公开数据集平台:巨人的肩膀与未及之地
  5. 为专业微调而生:Easy dataset 核心架构
  6. 实战演练 1/4:环境准备- 一键本地化部署
  7. 实战演练 2/4:知识处理一从源文档到结构化文本
  8. 实战演练 2/4:知识处理-智能分析与领域洞察

原 PDF 已逐页还原成图,共 12 页,这里先放前 3 页,其中 3 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01模型微调数据集创建工具:Easy dataset
  2. 02本次分享大纲
  3. 03微调的成败,七分靠数据
011 / 3
第 1 页:模型微调数据集创建工具:Easy dataset
第 1 页

模型微调数据集创建工具:Easy dataset

轻松将任何文档,转化为高质量微调数据

022 / 3
第 2 页:本次分享大纲
第 2 页

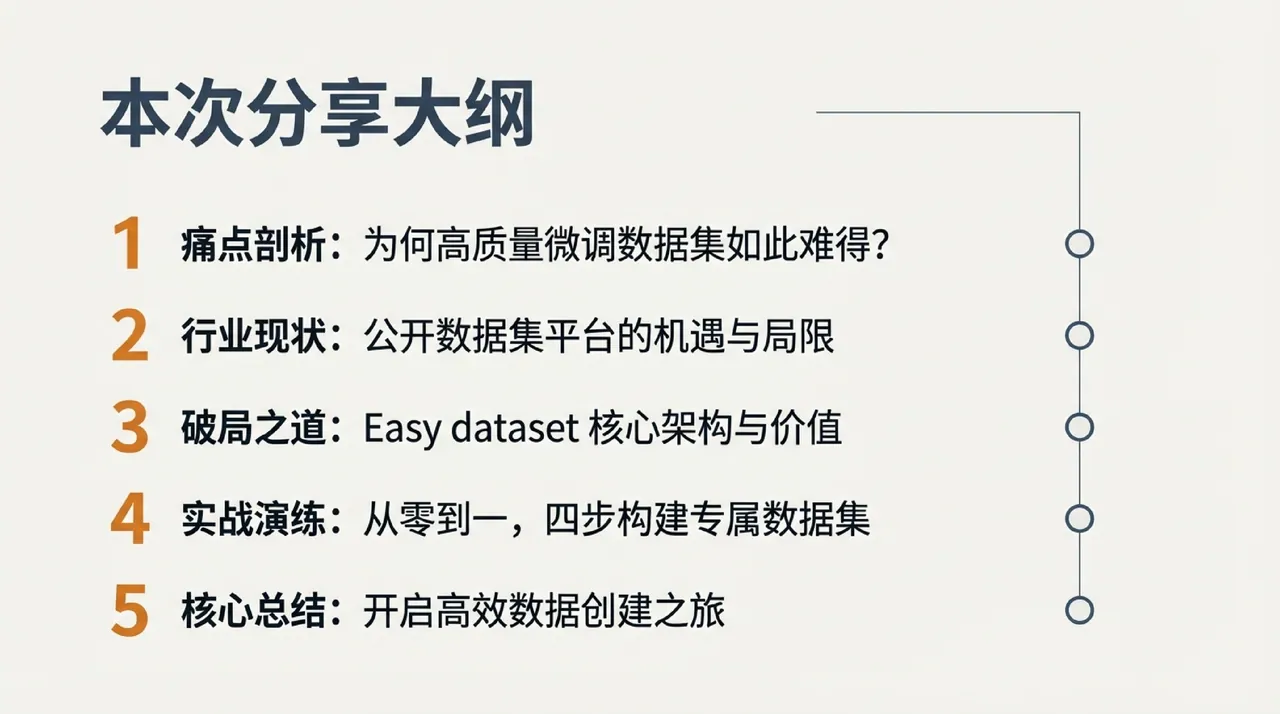
本次分享大纲

痛点剖析:为何高质量微调数据集如此难得?

行业现状:公开数据集平台的机遇与局限 破局之道:Easy dataset 核心架构与价值 实战演练:从零到一,四步构建专属数据集 核心总结:开启高效数据创建之旅

033 / 3
第 3 页:微调的成败,七分靠数据
第 3 页

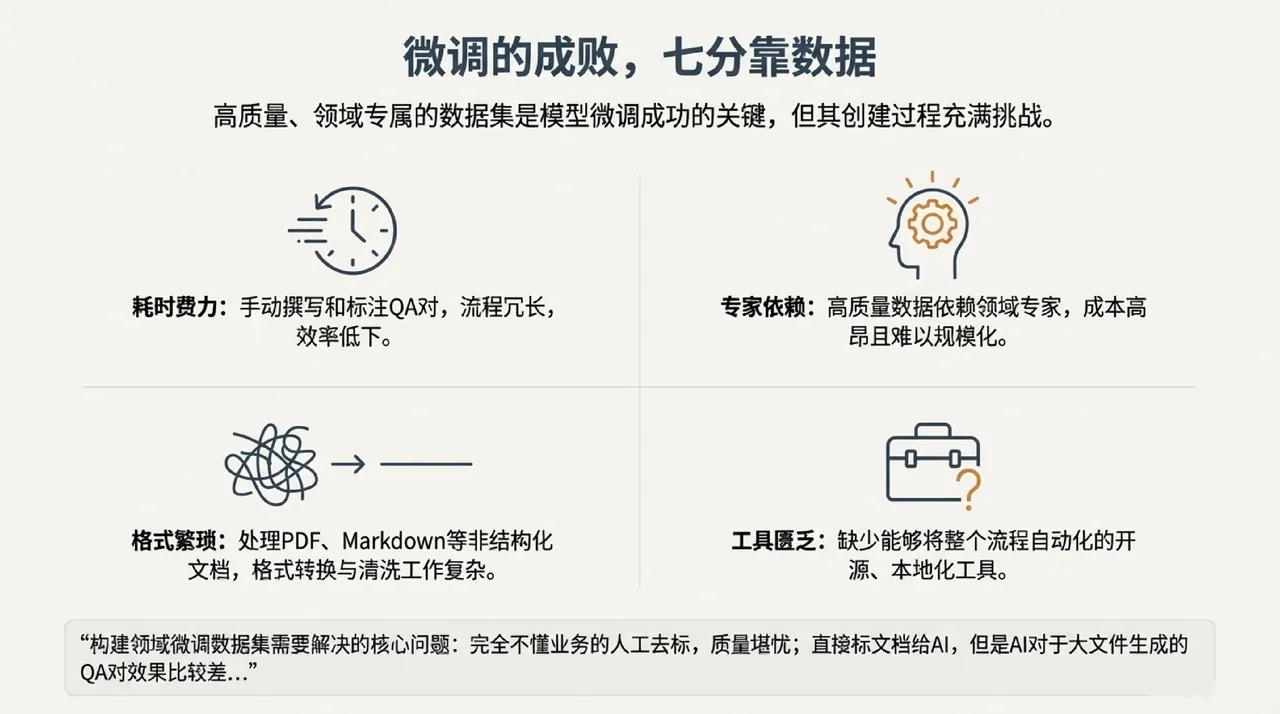
微调的成败,七分靠数据

高质量、领域专属的数据集是模型微调成功的关键,但其创建过程充满挑战。

耗时费力:手动撰写和标注 QA 对,流程冗长, 效率低下。

格式繁琐:处理 PDF、Markdown 等非结构化 文档,格式转换与清洗工作复杂。 “构建领域微调数据集需要解決的核心问题:完全不懂业务的人工去标,质量堪忧;直接标文档给 AI,但是 AI 对于大文件生成的 QA 对效果比较差….”

专家依赖:高质量数据依赖领域专家,成本高

工具匮乏:缺少能够将整个流程自动化的开

昂且难以规模化。

源、本地化工具。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求