
训练、微调与数据图文讲义1219 字
为什么说Al大模型微调中最不需要关注的就是GPU
·全库 94 / 611
《为什么说Al大模型微调中最不需要关注的就是GPU》共 15 页、0.1 万字,通篇围绕 微调、GPU、算力、评估 展开,归在「训练、微调与数据」这一层。
覆盖微调GPU算力评估成本场景
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(8 节)
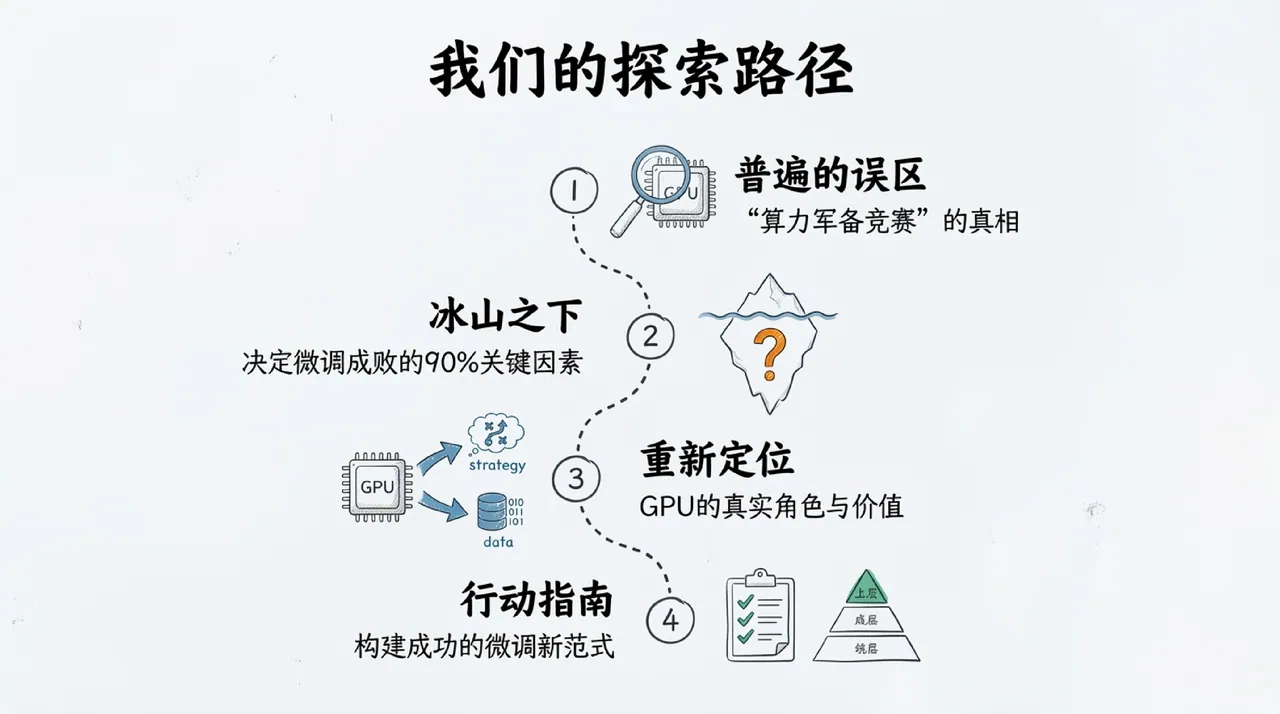
- 我们的探索路径
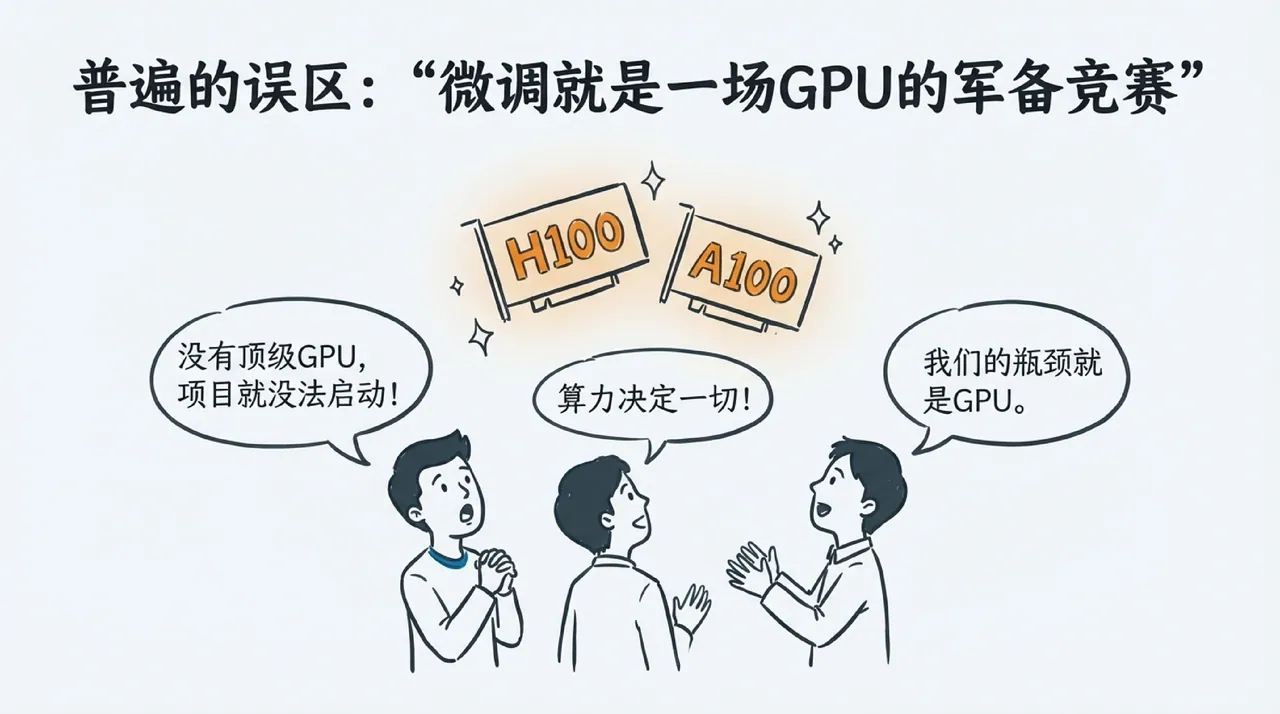
- 普遍的误区:“微调就是一场 GPU 的军备竞赛”
- 核心隐喻:微调的成功,如同驾驭一座冰山
- 水下基石 ①:数据质量是模型能力的上限
- “80%的工作在这里”:高质量指令集的诞生过程
- 水下基石②:错误的航向,再快的船也无法到达目的地
- 水下基石③:选择比努力更重要——技术选型决定资源需求
- 水下基石④:没有可靠的评估,微调就是在黑暗中赌博
原 PDF 已逐页还原成图,共 15 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。
011 / 3
第 1 页
为什么说 最不需要
022 / 3
第 2 页
我们的探索路径
033 / 3
第 3 页