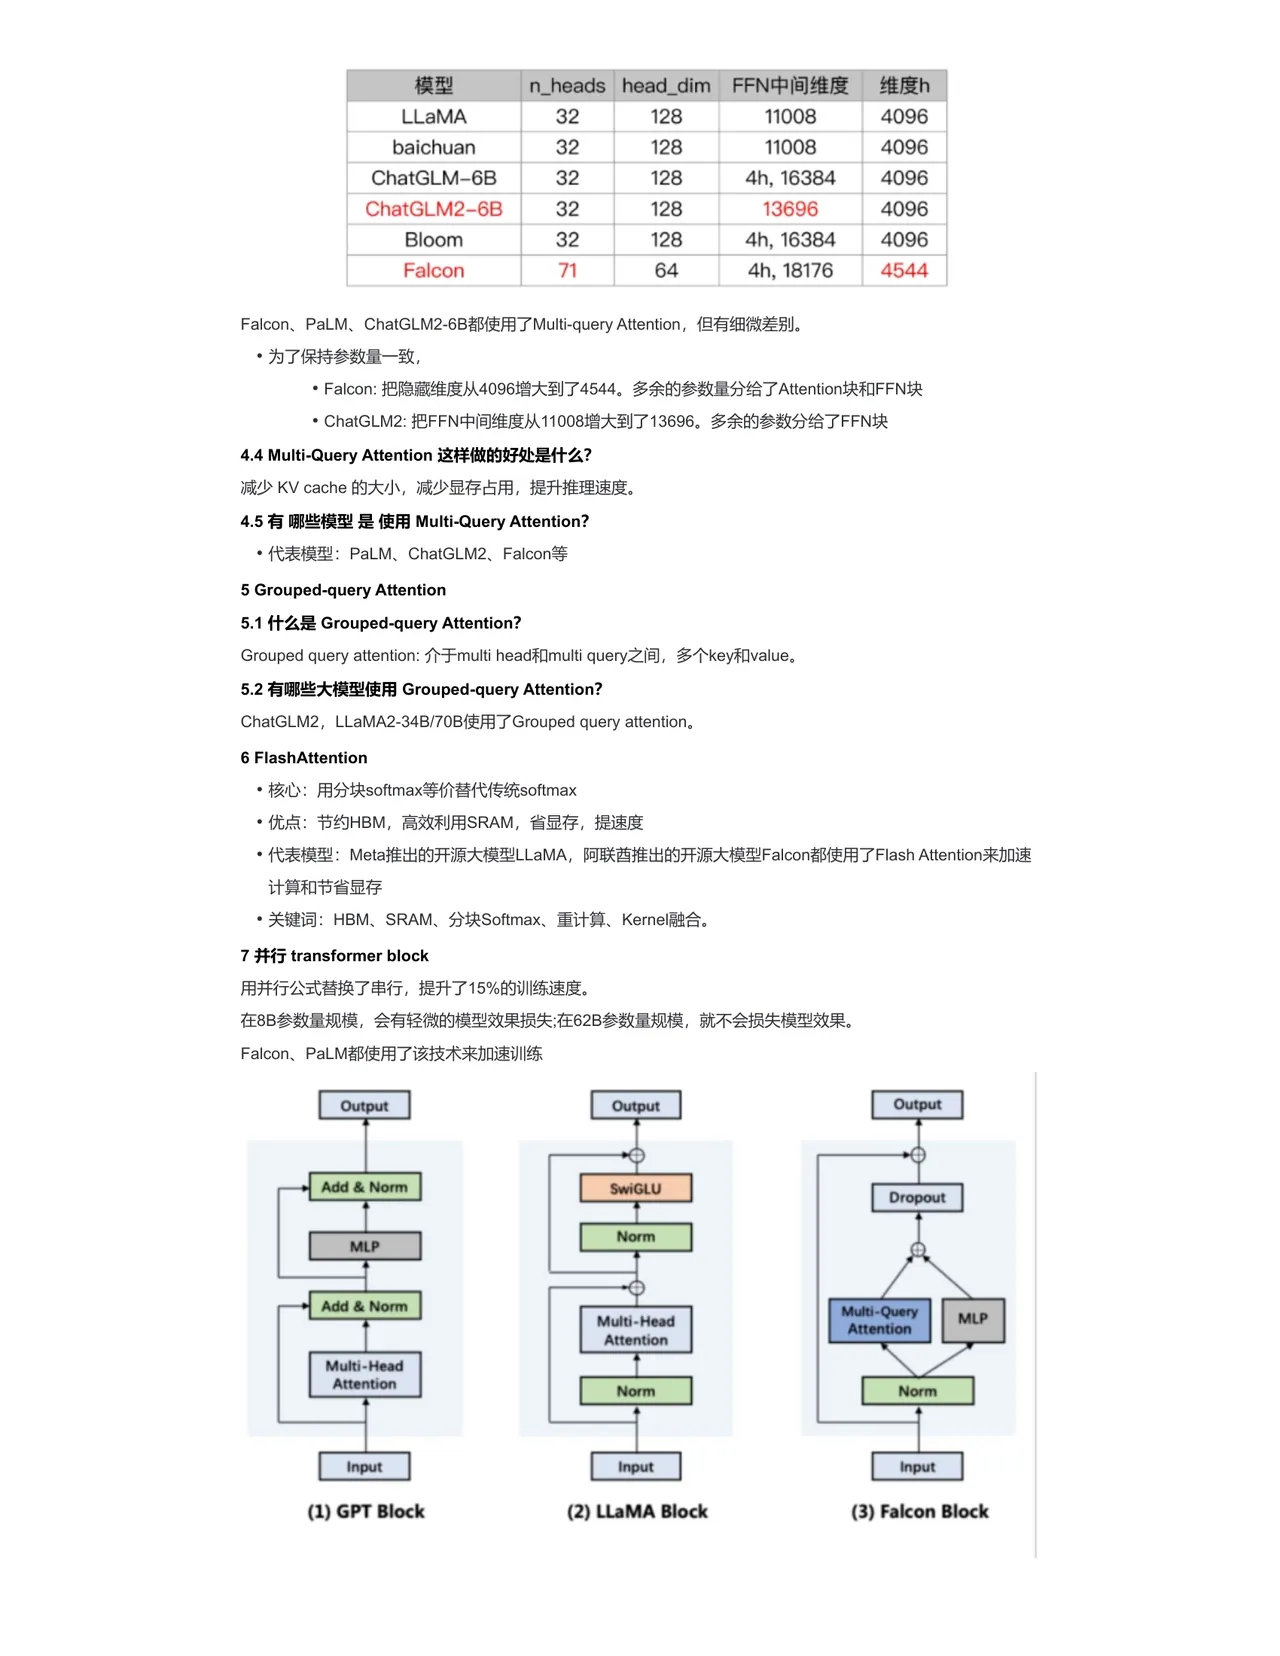
FFN 中间维度 n_heads head_dim 维度 h 11008 4096 4096 11008 4096 4096 13696
4h, 16384 4096 4544 4h, 18176
Output Output
SwiGLU Dropout
Multi-Query MLP Multi-Head Attention
Norm
Input Input
(2)LLaMA Block (3)Falcon Block
模型 LLaMA baichuan ChatGLM-6B ChatGLM2-6B Bloom Falcon
- Falcon、PaLM.ChatGLM2-6B 都使用了 Multi-query Attention,但有细微差别。
- 为了保持参数量一致,
- Falcon:把隐藏维度从 4096 增大到了 4544。多余的参数量分给了 Attention 块和 FFN 块
- ChatGLM2:把 FFN 中间维度从 11008 增大到了 13696。多余的参数分给了 FFN 块 4.4 Multi-Query Attention 这样做的好处是什么? 减少 KV cache 的大小,减少显存占用,提升推理速度。 4.5 有哪些模型是使用 Multi-Query Attention?
- 代表模型:PaLM、ChatGLM2、Falcon 等 5 Grouped-query Attention 5.1 什么是 Grouped-query Attention? Grouped query attention:介于 multi head 和 multi query 之间,多个 key 和 value。 5.2 有哪些大模型使用 Grouped-query Attention? ChatGLM2, LLaMA2-34B/70B 使用了 Grouped query attention。
6 FlashAttention •核心:用分块 softmax 等价替代传统 softmax
- 优点:节约 HBM,高效利用 SRAM,省显存,提速度
- 代表模型:Meta 推出的开源大模型 LLaMA,阿联酋推出的开源大模型 Falcon 都使用了 Flash Attention 来加速 计算和节省显存
- 关键词:HBM、SRAM、分块 Softmax、重计算、Kernel 融合。 7 并行 transformer block
用并行公式替换了串行,提升了 15%的训练速度。 在 8B 参数量规模,会有轻微的模型效果损失;在 62B 参数量规模,就不会损失模型效果。 Falcon、PaLM 都使用了该技术来加速训练
Output
Add & Norm
Add & Norm
Multi-Head Attention
Input
(1)GPT Block