对齐、评估与多模态面试题图文讲义833 字

强化学习自然语言应用面试题

·全库 128 / 611

《强化学习自然语言应用面试题》共 4 页、0.1 万字,通篇围绕 Agent、PPO、向量 展开,归在「对齐、评估与多模态」这一层。

覆盖AgentPPO向量

适合要给模型效果打分、判断它够不够用的人

目录骨架(4 节)
  1. 2.1 介绍一下强化学习中优化方法 Value-based?
  2. Environment
  3. Action a
  4. 2.2 介绍一下强化学习中贝尔曼方程?

原 PDF 已逐页还原成图,共 4 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01强化学习在自然语言处理下的应用篇
  2. 02状态(States):对于世界状态的…
  3. 032.1 介绍一下强化学习中优化方法 Value-based?
011 / 3
第 1 页
第 1 页

强化学习在自然语言处理下的应用篇

  • 强化学习在自然语言处理下的应用篇
  • 一、强化学习基础面
  • 1.1 介绍一下强化学习?
  • 1.2 介绍一下强化学习的状态(States)和观测(Observations)?
  • 1.3 强化学习有哪些动作空间(Action Spaces),他们之间的区别是什么?
  • 1.4 强化学习有哪些 Policy 策略?
  • 1.5 介绍一下强化学习的轨迹?
  • 1.6 介绍一下强化学习的奖赏函数?
  • 1.7 介绍一下强化学习问题?
  • 二、RL 发展路径(至 PPO)
  • 2.1 介绍一下强化学习中优化方法 Value-based?
  • 2.2 介绍一下强化学习中贝尔曼方程?
  • 2.3 介绍一下强化学习中优势函数 Advantage Functions?

一、强化学习基础面 1.1 介绍一下强化学习?

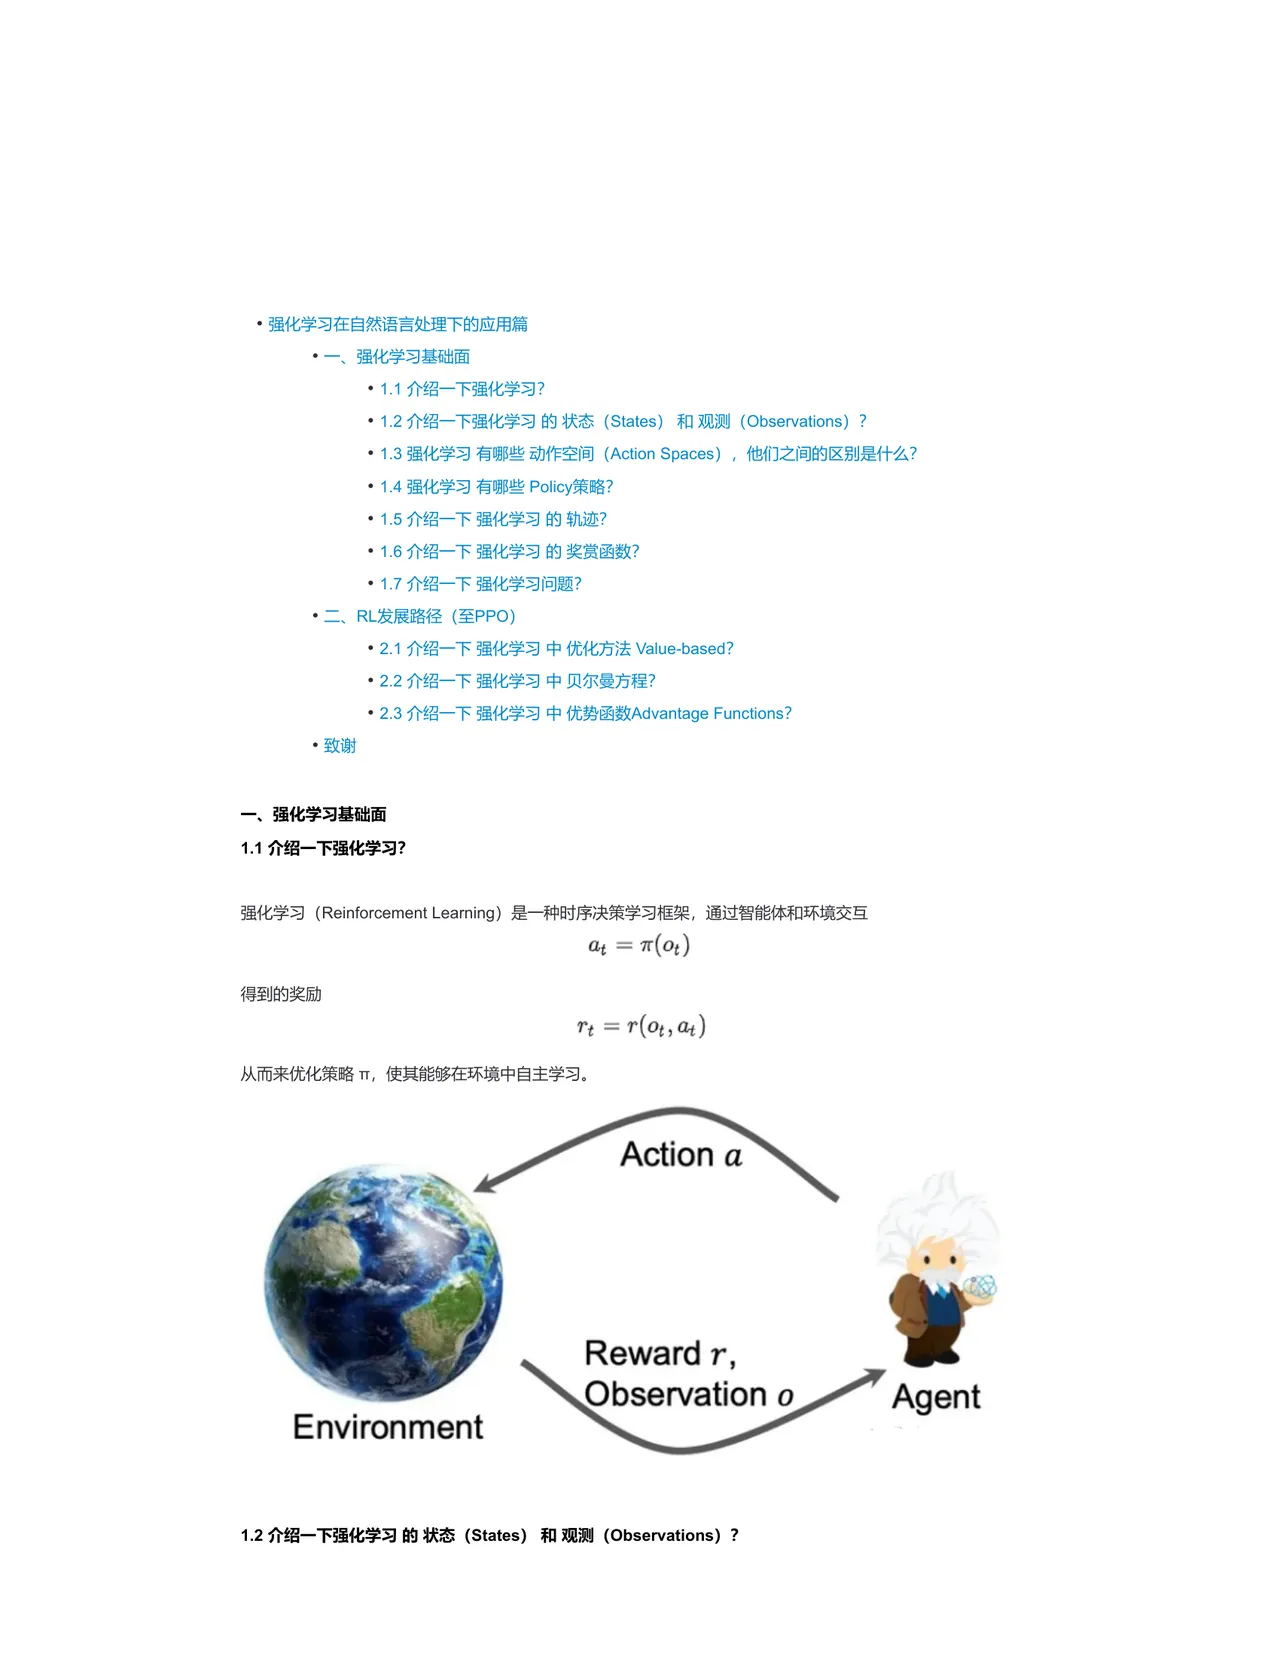
强化学习(Reinforcement Learning)是一种时序决策学习框架,通过智能体和环境交互

得到的奖励

从而来优化策略 T,使其能够在环境中自主学习。

Environment

1.2 介绍一下强化学习的状态(States)和观测(Observations)?

Action a

Reward r, Observation o

Agent

022 / 3
第 2 页
第 2 页

状态(States):对于世界状态的…

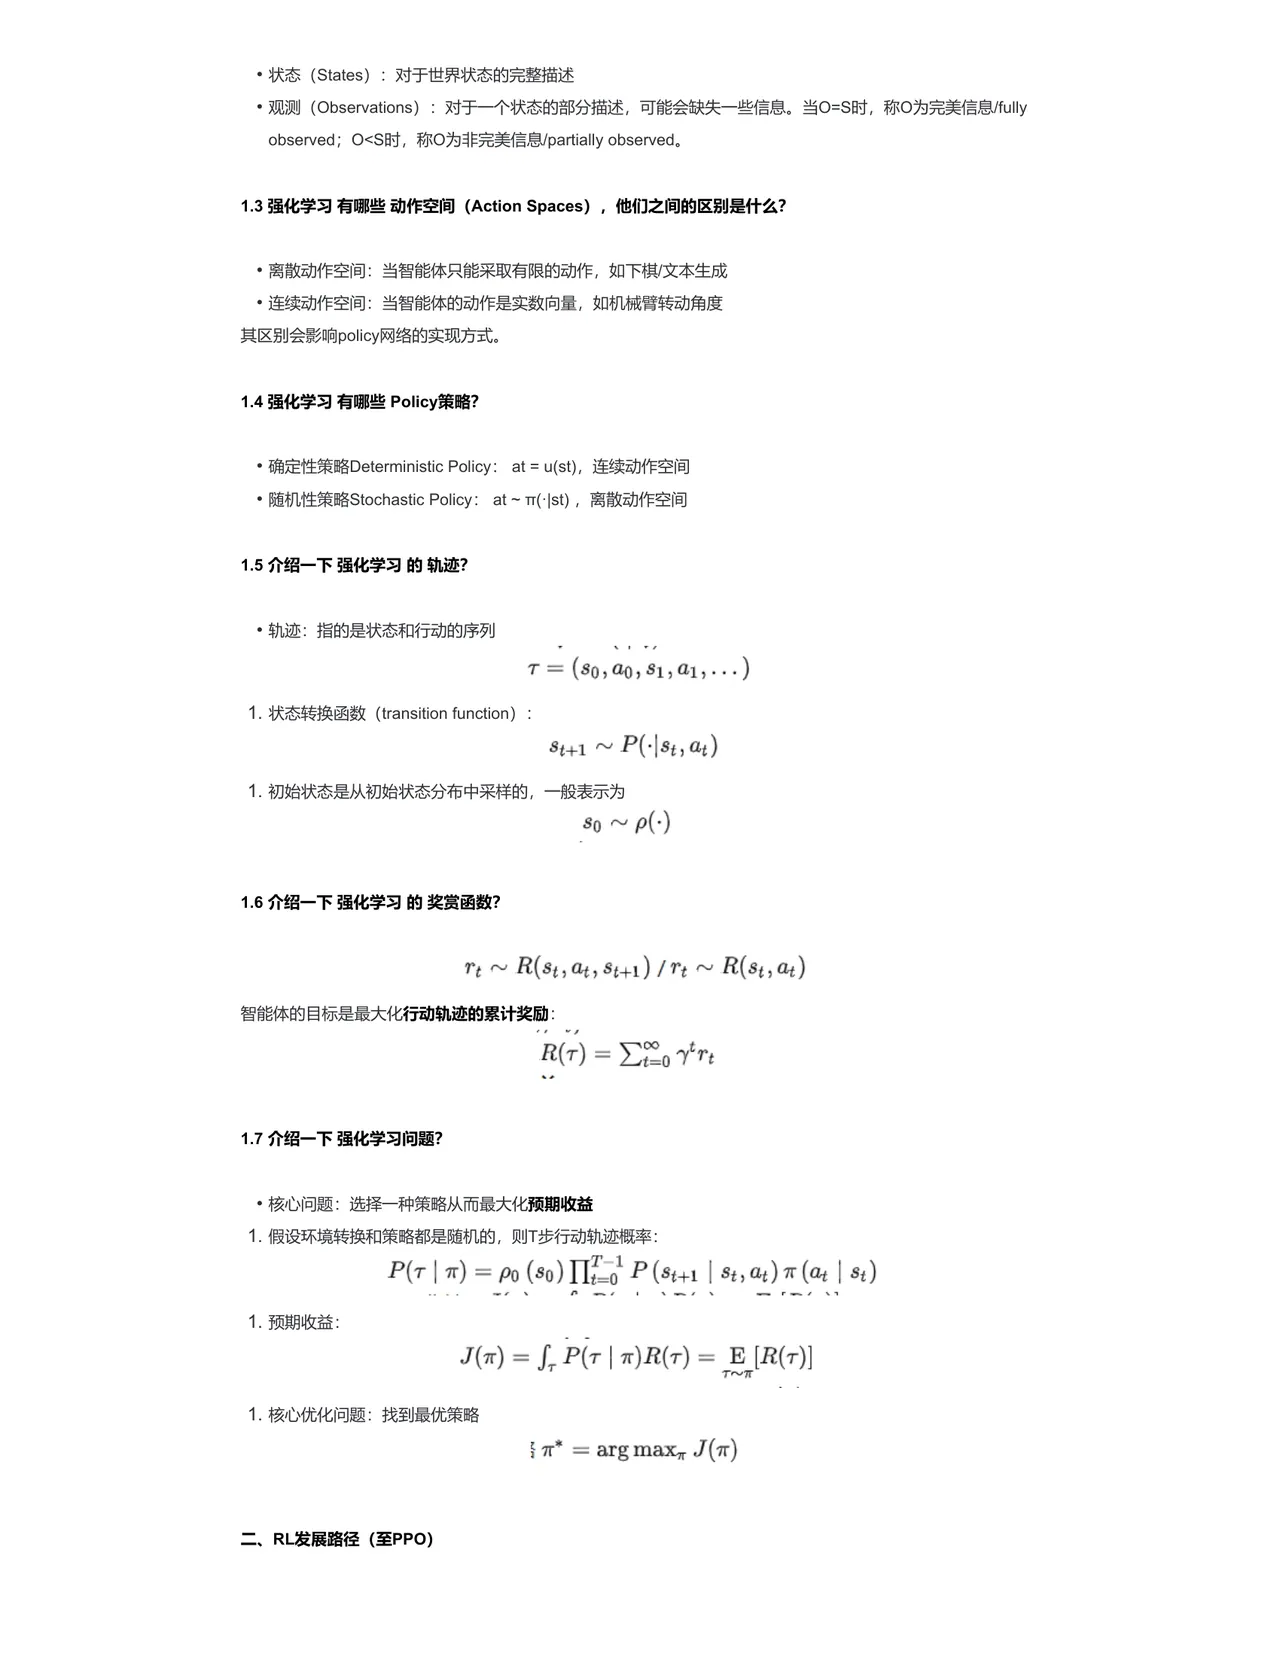
  • 状态(States):对于世界状态的完整描述
  • 观测(Observations):对于一个状态的部分描述,可能会缺失一些信息。当 O=S 时,称 O 为完美信息/fully observed; O<S 时,称 O 为非完美信息/partially observed。

1.3 强化学习有哪些动作空间(Action Spaces),他们之间的区别是什么?

  • 离散动作空间:当智能体只能采取有限的动作,如下棋/文本生成
  • 连续动作空间:当智能体的动作是实数向量,如机械臂转动角度 其区别会影响 policy 网络的实现方式。

1.4 强化学习有哪些 Policy 策略?

• 随机性策略 Stochastic Policy:at~T (Ist),离散动作空间

1.5 介绍一下强化学习的轨迹?

•轨迹:指的是状态和行动的序列

1.状态转换函数(transition function):

  1. 初始状态是从初始状态分布中采样的,一般表示为

1.6 介绍一下强化学习的奖赏函数?

智能体的目标是最大化行动轨迹的累计奖励:

1.7 介绍一下强化学习问题?

• 核心问题:选择一种策略从而最大化预期收益 1.假设环境转换和策略都是随机的,则 T 步行动轨迹概率:

1.预期收益:

1.核心优化问题:找到最优策略

二、RL 发展路径(至 PPO)

033 / 3
第 3 页:2.1 介绍一下强化学习中优化方法 Value-based?
第 3 页

2.1 介绍一下强化学习中优化方法 Value-based?

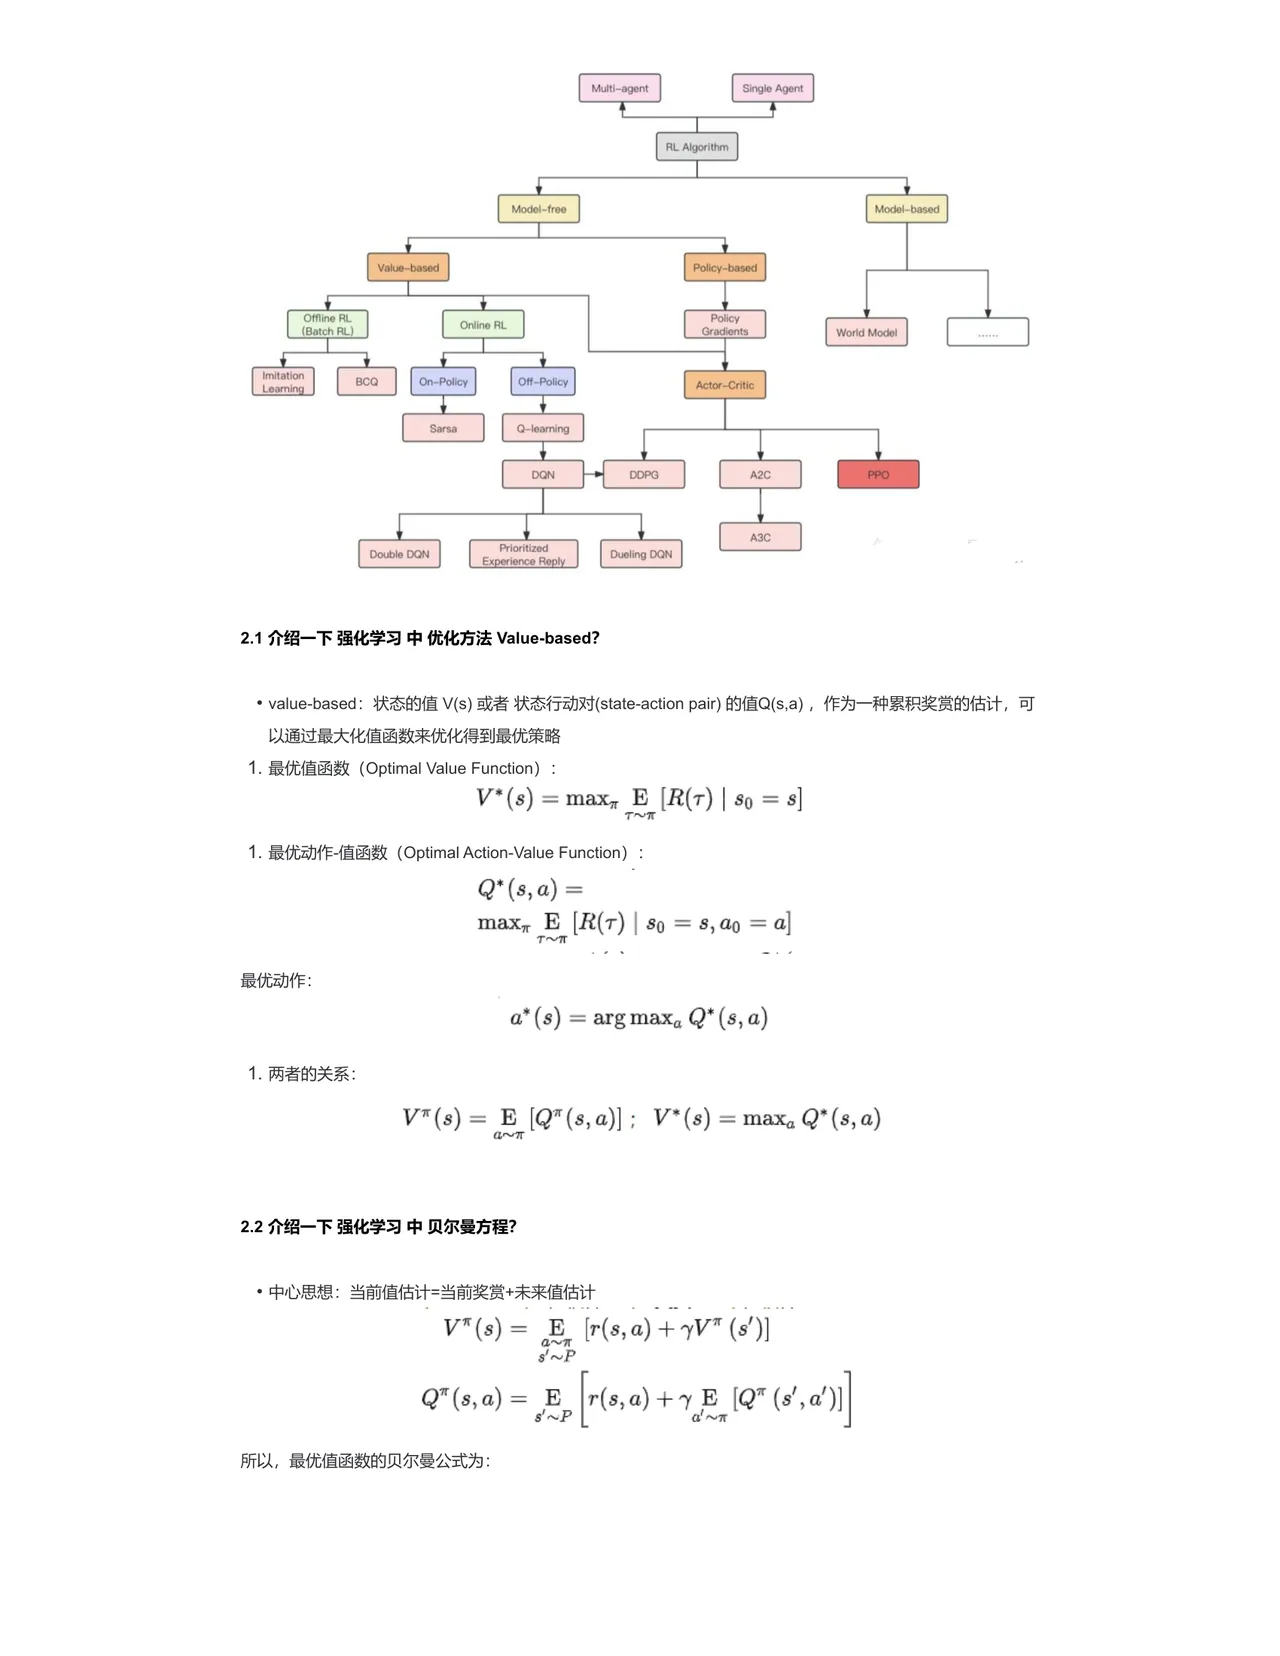
Single Agent Multi-agent

RL Algorithm

Model-based Model-free

Value-based Policy-based

Offline RL Policy Online RL Gradients World Mode Imitation Off-Policy BCQ On-Policy Actor-Critic Sarsa A2C DQN PPO

A3C Prioritized Dueling DQN Double DQN Experience Reply|

• value-based:状态的值 V (s)或者状态行动对(state-action pair)的值 Q (S,a),作为一种累积奖赏的估计,可 以通过最大化值函数来优化得到最优策略 1. 最优值函数(Optimal Value Function):

  1. 最优动作-值函数(Optimal Action-Value Function):

T~T

最优动作:

  1. 两者的关系:

2.2 介绍一下强化学习中贝尔曼方程?

•中心思想:当前值估计=当前奖赏+未来值估计

所以,最优值函数的贝尔曼公式为:

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求