
大模型激活函数面试题
《大模型激活函数面试题》共 0.0 万字,通篇围绕 Transformer、Attention、重排、OCR 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(3 节)
- 第 1 页
- 第 2 页
- ChatGLM2-
原件是 2 页图文讲义(PDF 不再随站提供)。下面按页还原:左目录选页,中间原页图,右侧是 OCR 识别并按版面重排的文字,可能有错字,以图为准。
第 1 页
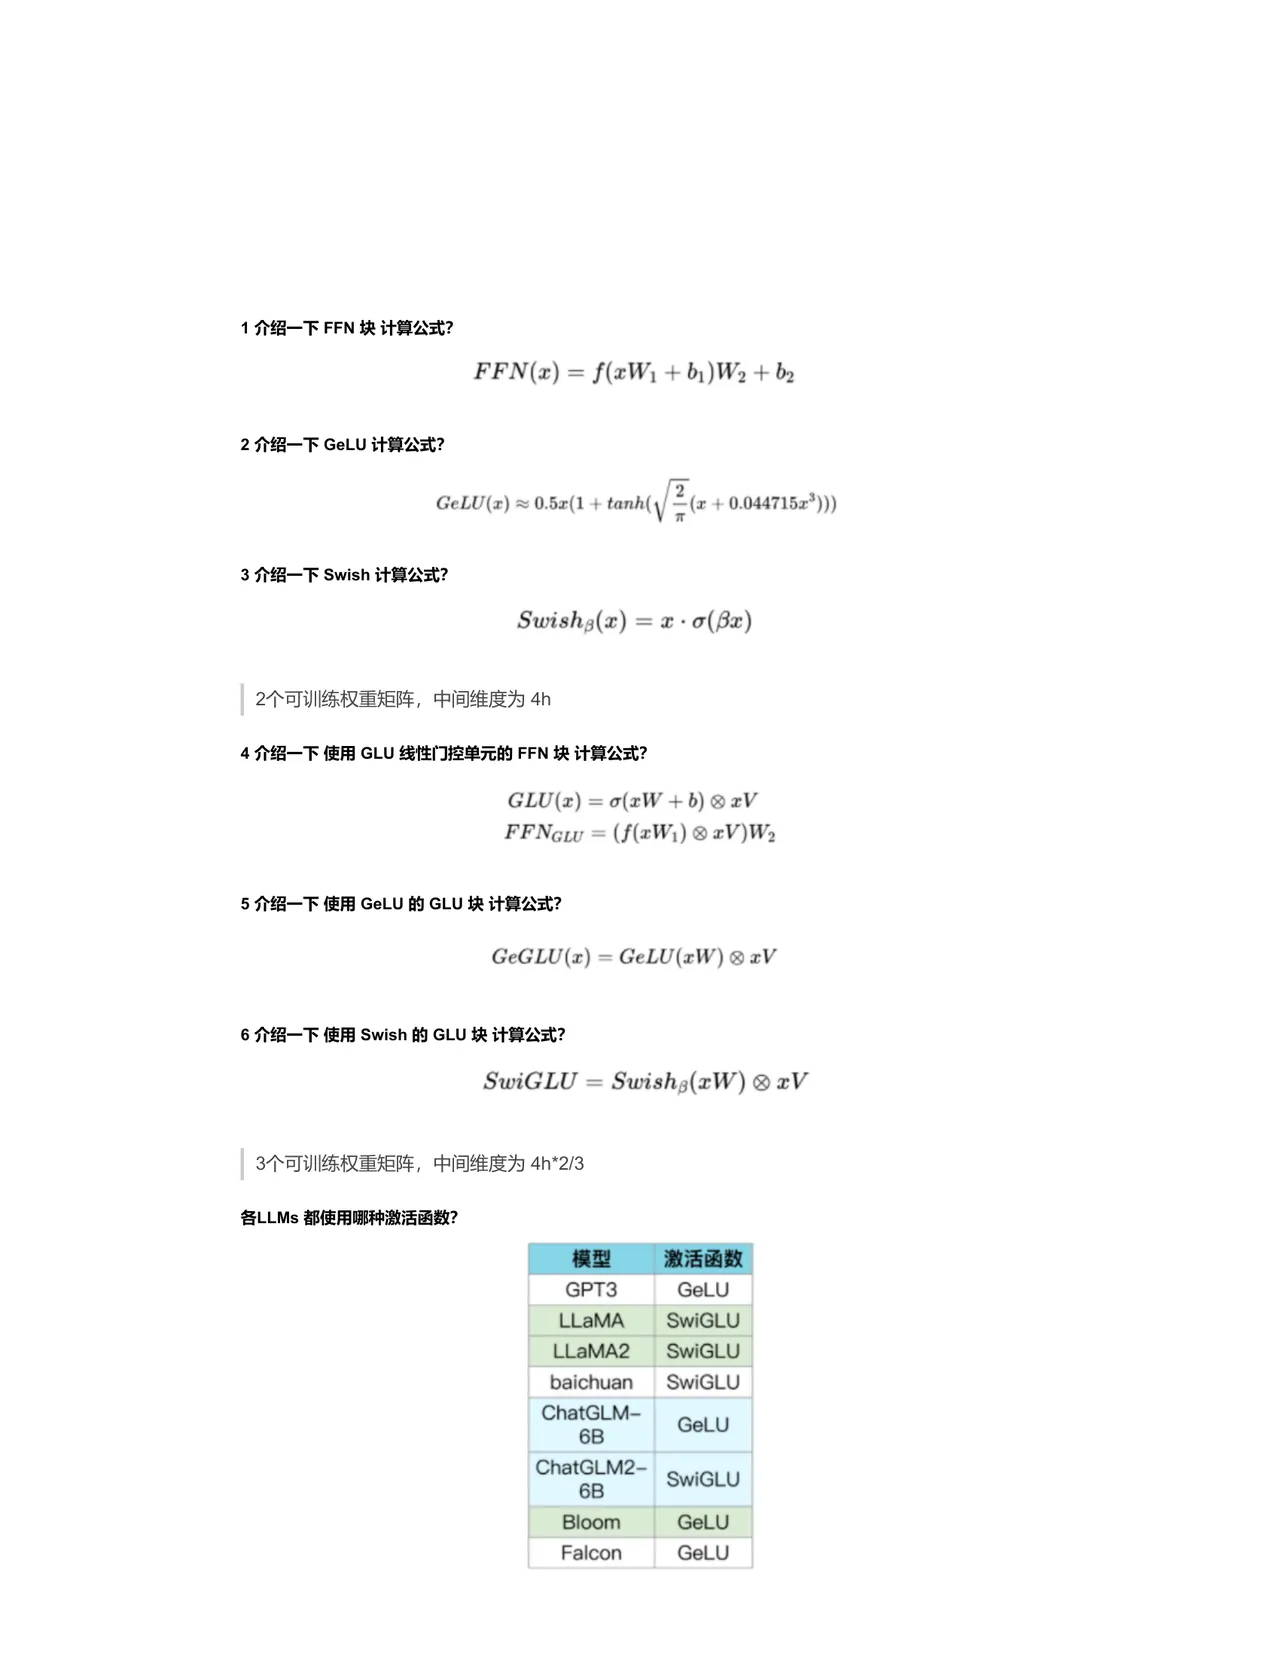
1 介绍一下 FFN 块计算公式?
2 介绍一下 GeLU 计算公式?
3 介绍一下 Swish 计算公式?
2 个可训练权重矩阵,中间维度为 4h 4 介绍一下使用 GLU 线性门控单元的 FFN 块计算公式?
5 介绍一下使用 GeLU 的 GLU 块计算公式?
6 介绍一下使用 Swish 的 GLU 块计算公式?
3 个可训练权重矩阵,中间维度为 4h*2/3 各 LLMs 都使用哪种激活函数?
激活函数 模型 GeLU GPT3 LLaMA LLaMA2 SwiGLU baichuan ChatGLM- GeLU 6B
ChatGLM2-
SwiGLU 6B
Bloom
GeLU Falcon GeLU
第 2 页
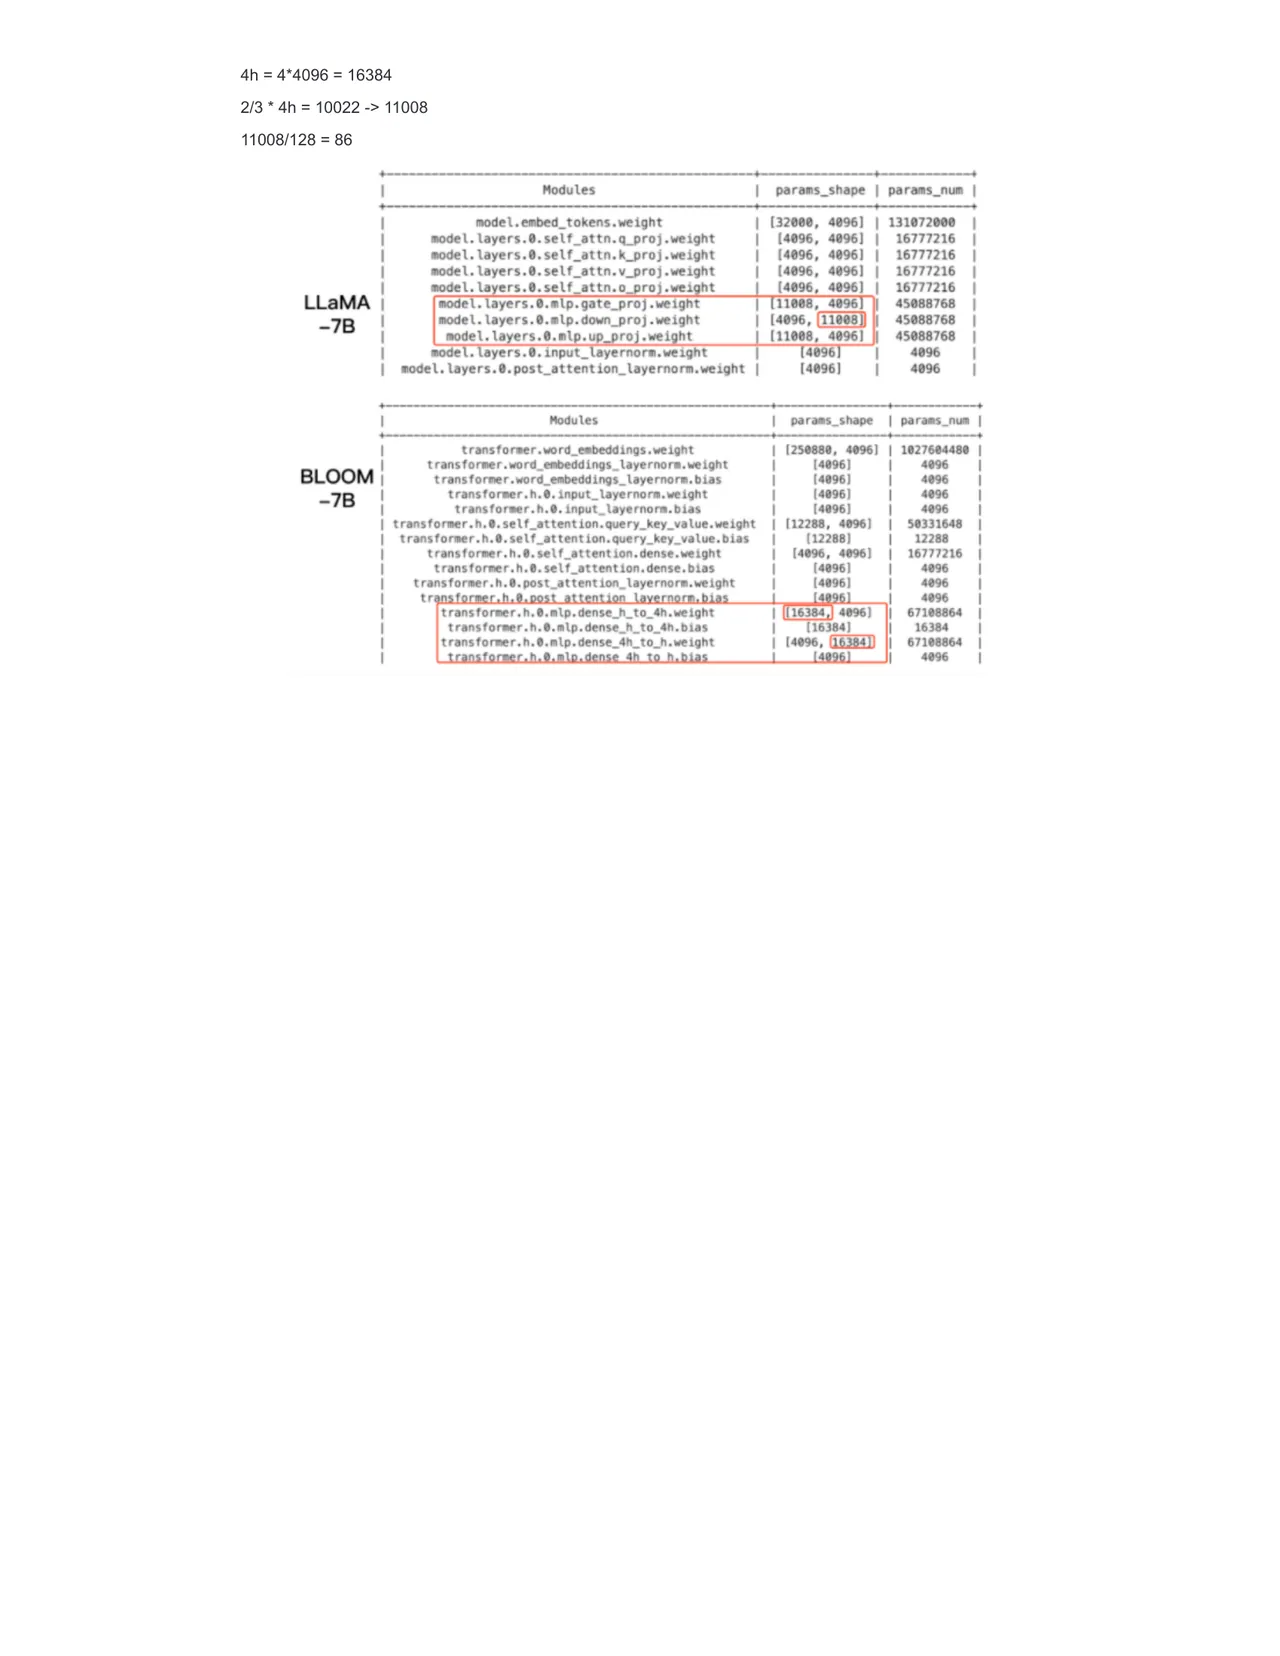
4h = 44096 = 16384 2/34h = 10022 -> 11008 11008/128 =86
Modules model.embed_tokens.weight model.layers.0.self_attn.q_proj.weight model.layers.0.self_attn.k_proj.weight model. layers.0.self_attn.v_proj.weight mode L.layers.0.self_attn.o_proj.weight
LLaMA model.layers.0.mlp.gate_proj.weight/ model.layers.0.mlp.down_proj.weight| model. layers.0.mlp.up_proj.weight mode l. layers.0. input_layernorm.weight model. layers.0.post_attention_layernorm.weight
Modules| transformer.word_embeddings.weight transformer.word_embeddings_layernorm.weight
BLOOM transformer.word_embeddings_layernorm.bias transformer.h.0.input_layernorm.weight
-7B
transformer.h.0.input_layernorm.bias transformer.h.0.self_attention.query_key_value.weight transformer.h.0.self_attention.query_key_value.bias transformer.h.0.self_attent ion.dense.weight transformer.h.@.self_attention.dense.bias transformer.h.0.post_attention_layernorm.weight transformer.h.9.0ost attention layernorm.bias, transformer.h.0.mlp.dense_h_to_4h.weight transformer.h.0.mlp.dense_h_to_4h.bias|
transformer.h.0.mlp.dense_4h_to_h.weight
transformer.h.0.mlp.dense 4h to h.bias,
params_num params_shape 131072000 [ 32000,4096 ] 16777216
[ 4096,4096 ] 16777216 16777216 16777216 4096 ] 45088768 [ 11008, 4096 ] 45088768 【11008,4096 ] 45088768 [ 4096 ] 4096 [ 4096 ] 4096
params_shape params_num 1027604480 [ 4096 ]| [ 4096 ]| [ 12288,4096 ] [ 4096,4096 ] [ 4096 ]