
大模型强化学习PPO面试题
《大模型强化学习PPO面试题》共 0.1 万字,通篇围绕 PPO、RLHF、prompt、上下文 展开,归在「对齐、评估与多模态」这一层。
适合要给模型效果打分、判断它够不够用的人
目录骨架(2 节)
- 第 1 页
- 第 2 页
原件是 2 页图文讲义(PDF 不再随站提供)。下面按页还原:左目录选页,中间原页图,右侧是 OCR 识别并按版面重排的文字,可能有错字,以图为准。
第 1 页
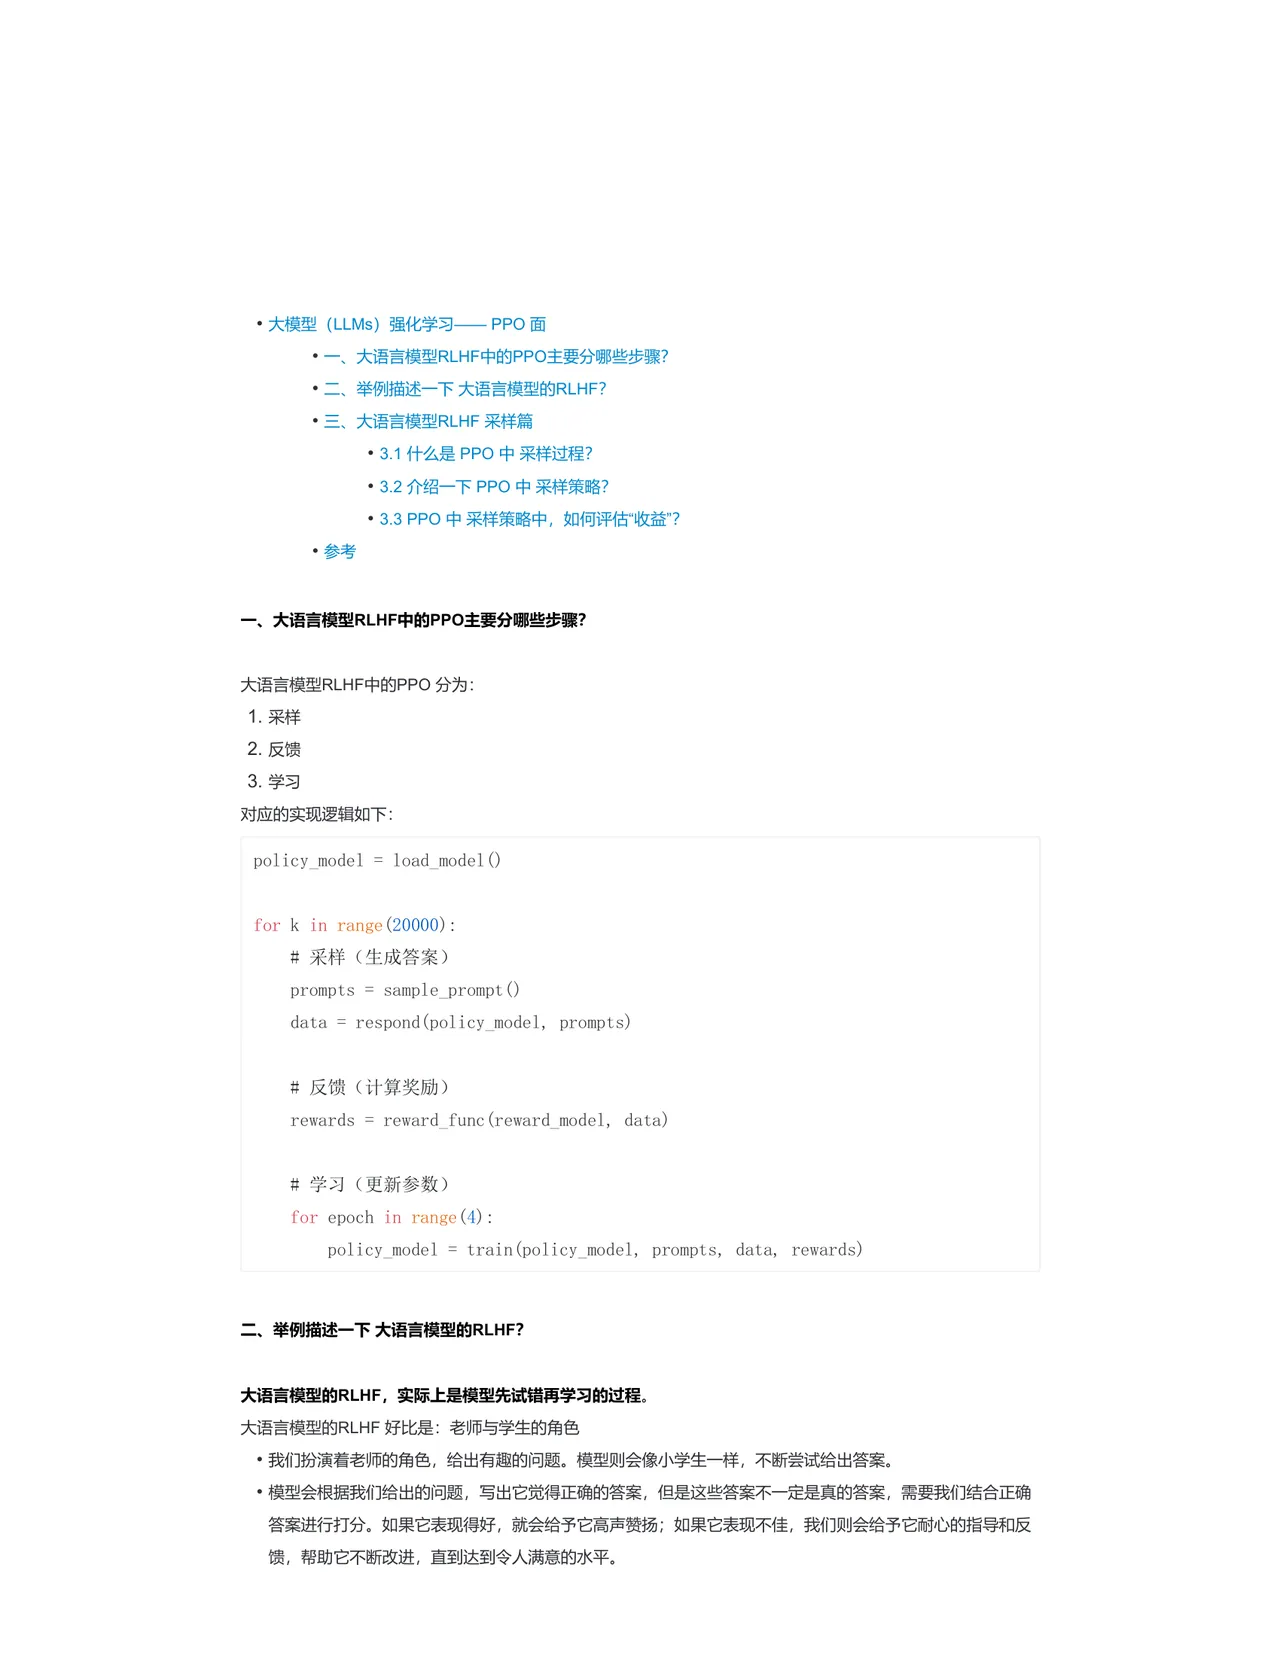
- 大模型(LLMS)强化学习——PPO 面
- 一、大语言模型 RLHF 中的 PPO 主要分哪些步骤?
- 二、举例描述一下大语言模型的 RLHF?
- 三、大语言模型 RLHF 采样篇
- 3.1 什么是 PPO 中采样过程?
- 3.2 介绍一下 PPO 中采样策略?
- 3.3 PPO 中采样策略中,如何评估“收益”?
一、大语言模型 RLHF 中的 PPO 主要分哪些步骤? 大语言模型 RLHF 中的 PPO 分为: 1. 采样
对应的实现逻辑如下: policy_model = load_model (
for k in range (20000):
prompts = sample prompt () data = respond (policy_model, prompts)
rewards = reward_func (reward_model, data)
#学习(更新参数) for epoch in range (4): policy_model = train (policy_model, prompts, data, rewards)
二、举例描述一下大语言模型的 RLHF?
大语言模型的 RLHF,实际上是模型先试错再学习的过程。 大语言模型的 RLHF 好比是:老师与学生的角色 。我们扮演着老师的角色,给出有趣的问题。模型则会像小学生一样,不断尝试给出答案。 •模型会根据我们给出的问题,写出它觉得正确的答案,但是这些答案不一定是真的答案,需要我们结合正确 答案进行打分。如果它表现得好,就会给予它高声赞扬;如果它表现不佳,我们则会给予它耐心的指导和反 馈,帮助它不断改进,直到达到令人满意的水平。
第 2 页
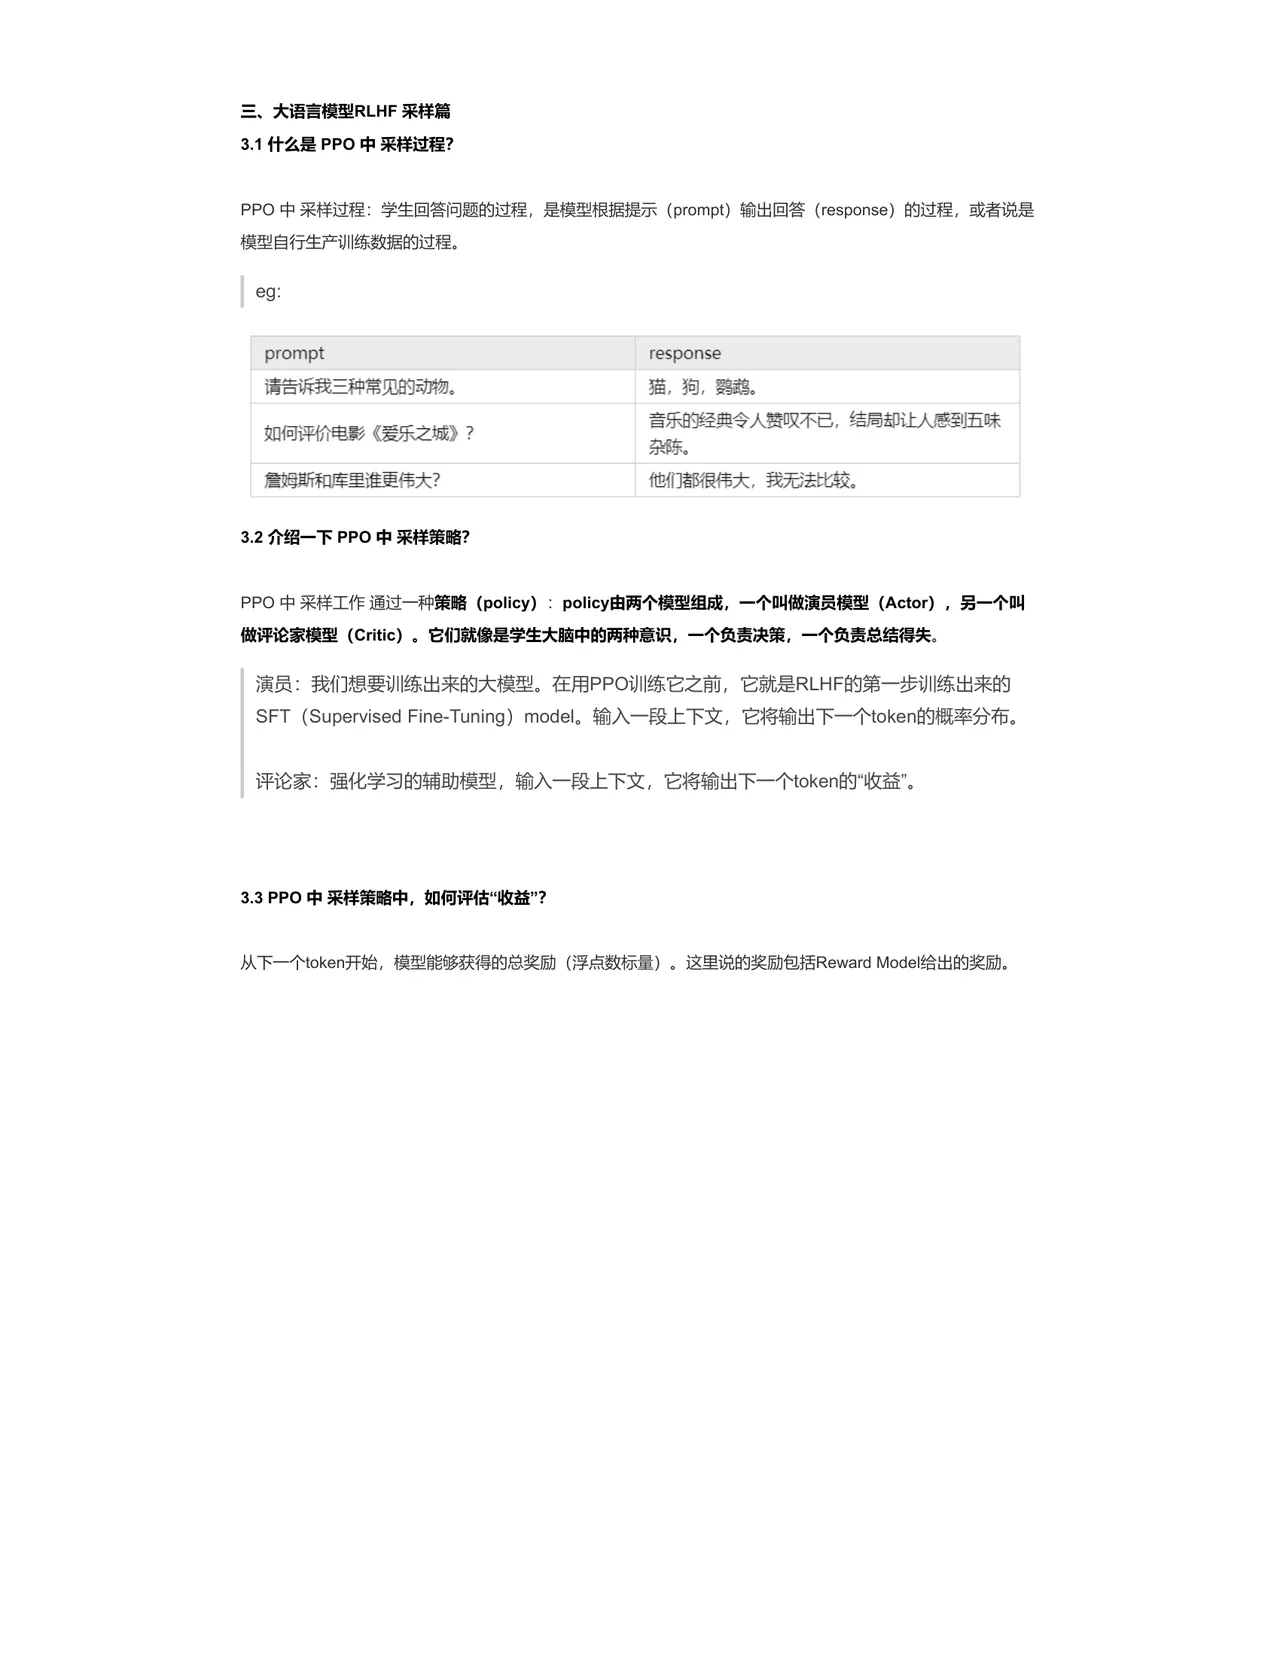
三、大语言模型 RLHF 采样篇 3.1 什么是 PPO 中采样过程?
PPO 中采样过程:学生回答问题的过程,是模型根据提示(prompt)输出回答(response)的过程,或者说是 模型自行生产训练数据的过程。 eg:
prompt 请告诉我三种常见的动物。 如何评价电影《爱乐之城》? 詹姆斯和库里谁更伟大? 3.2 介绍一下 PPO 中采样策略?
PPO 中采样工作通过一种策略(policy):policy 由两个模型组成,一个叫做潢员模型(Actor),另一个叫 做评论家模型(Critic)。它们就像是学生大脑中的两种意识,一个负责决策,一个负责总结得失。 演员:我们想要训练出来的大模型。在用 PPO 训练它之前,它就是 RLHF 的第一步训练出来的 SFT (Supervised Fine-Tuning)model。输入一段上下文,它将输出下一个 token 的概率分布。
评论家:强化学习的辅助模型,输入一段上下文,它将输出下一个 token 的“收益”。
3.3 PPO 中采样策略中,如何评估“收益”?
从下一个 token 开始,模型能够获得的总奖励(浮点数标量)。这里说的奖励包括 Reward Model 给出的奖励。
response
猫,狗,鹦鹉。 音乐的经典令人赞叹不已,结局都让人感到五味 杂陈。 他们都很伟大,我无法比较。