模型架构与原理面试题图文讲义768 字

Transformers操作面试题

·全库 131 / 611

《Transformers操作面试题》共 3 页、0.1 万字,通篇围绕 向量、预训练、embedding、Transformer 展开,归在「模型架构与原理」这一层。

覆盖向量预训练embeddingTransformerAttention

适合要跟模型团队对话、得听懂他们在说什么的人

目录骨架(2 节)
  1. 1. 如何利用 transformers 加载 Bert 模型?
  2. 3. BERT 获取最后一层或每一层网络的向量输出

原 PDF 已逐页还原成图,共 3 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 011. 如何利用 transformers 加载 Bert 模型?
  2. 02接下来就可以把第一个 token 也…
  3. 03outputs. pooLer_ou…
011 / 3
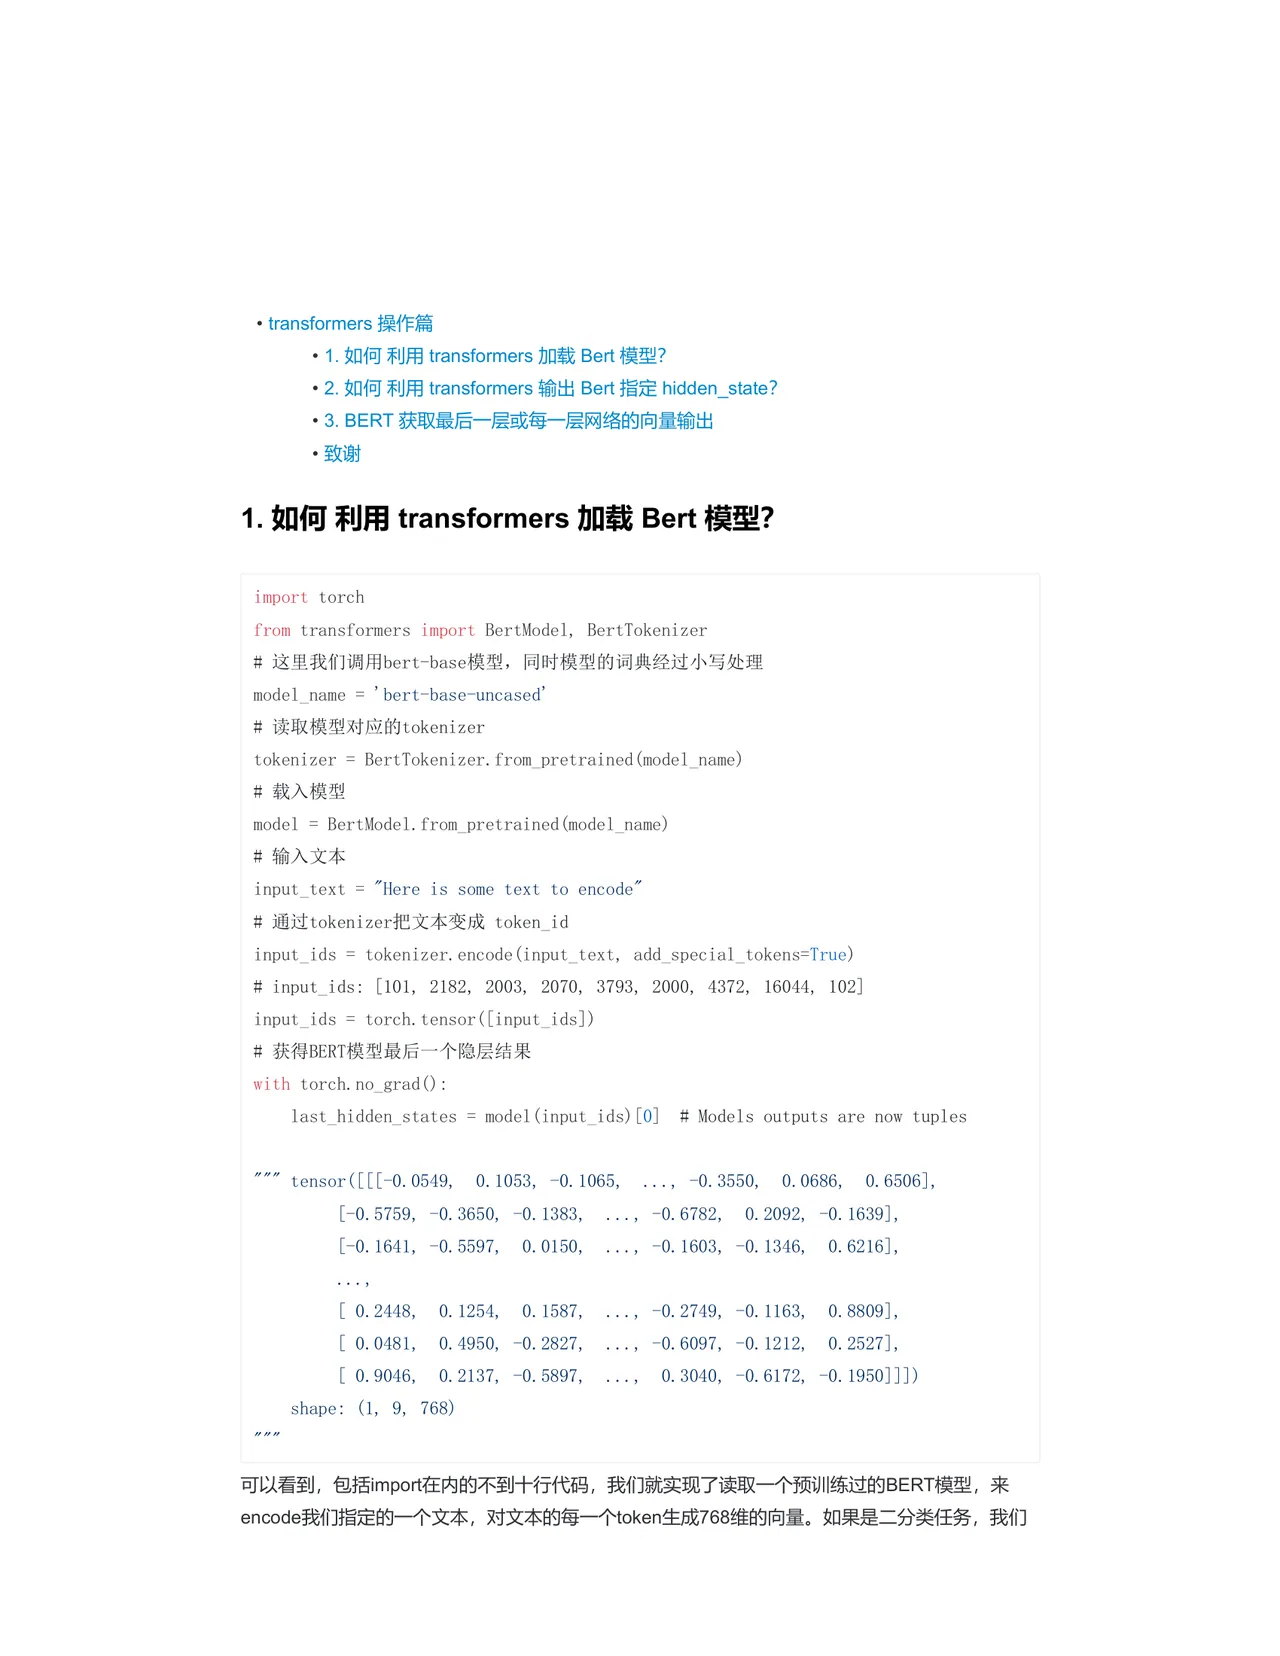
第 1 页:1. 如何利用 transformers 加载 Bert 模型?
第 1 页

1. 如何利用 transformers 加载 Bert 模型?

  • transformers 操作篇
  • 1. 如何利用 transformers 加载 Bert 模型?
  • 2. 如何利用 transformers 输出 Bert 指定 hidden_state?
  • 3. BERT 获取最后一层或每一层网络的向量输出

import torch from transformers import BertModel, BertTokenizer #这里我们调用 bert-base 模型,同时模型的词典经过小写处理 model name = 'bert-base-uncased' # 读取模型对应的 tokenizer tokenizer = BertTokenizer.from_pretrained (model_name)

model = BertModel.from pretrained (model_name)

input_text = "Here is some text to encode" # 通过 tokenizer 把文本变成 token_id input_ids = tokenizer.encode (input_text, add_special_tokens=True)

input_ids = torch.tensor ([ input_ids ]) # 获得 BERT 模型最后一个隐层结果

with torch.no_ gradO:

last_hidden_states = model (input_ids)[ 0 ] # Models outputs are now tuples

可以看到,包括 import 在内的不到十行代码,我们就实现了读取一个预训练过的 BERT 模型,来 encode 我们指定的一个文本,对文本的每一个 token 生成 768 维的向量。如果是二分类任务,我们

022 / 3
第 2 页
第 2 页

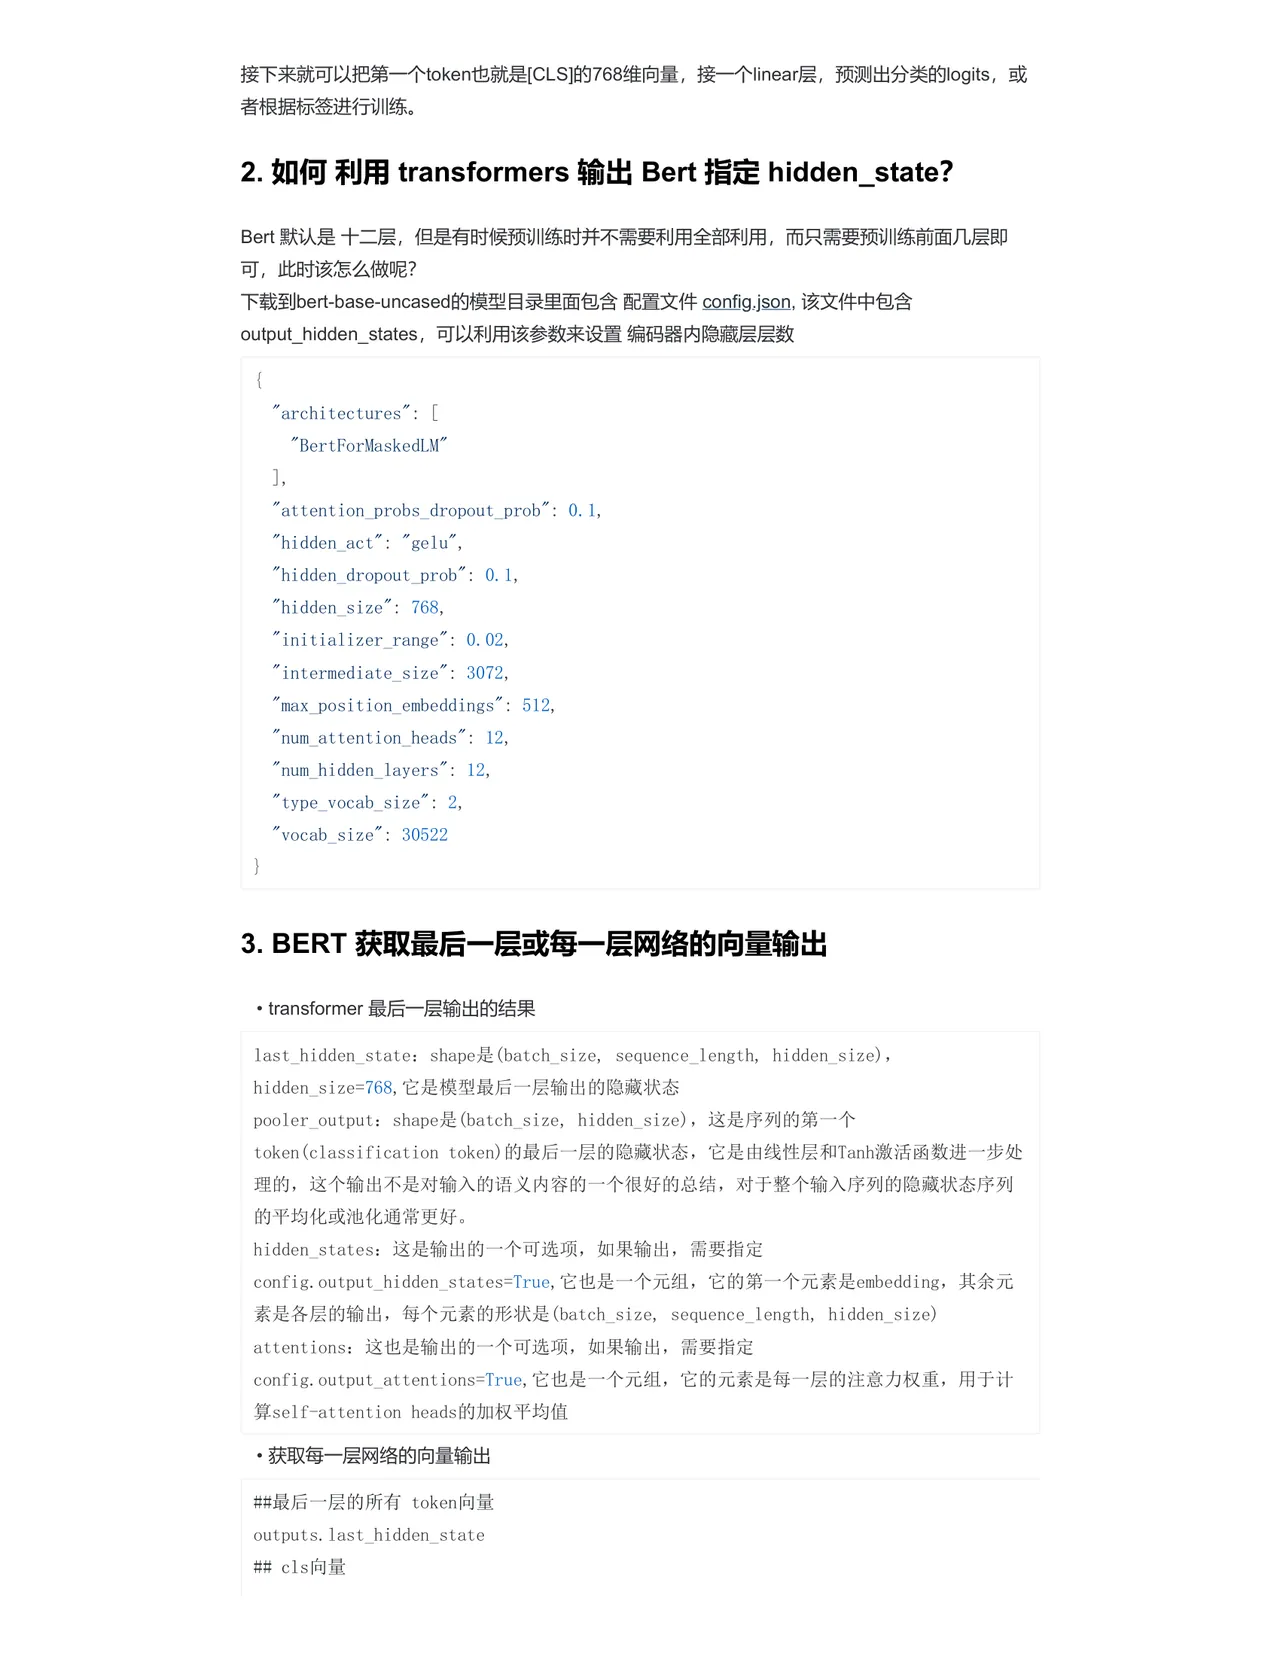
接下来就可以把第一个 token 也…

接下来就可以把第一个 token 也就是[ CLS ]的 768 维向量,接一个 linear 层,预测出分类的 logits,或 者根据标签进行训练。

Bert 默认是十二层,但是有时候预训练时并不需要利用全部利用,而只需要预训练前面几层即 可,此时该怎么做呢? 下载到 bert-base-uncased 的模型目录里面包含配置文件 config.json,该文件中包含 output_hidden_states,可以利用该参数来设置编码器内隐藏层层数

“architectures”:[ "BertForMaskedLM"

“attention_probs_dropout_prob”:0. 1,

"initializer_range":0.02, "intermediate_size":3072, "max_position_embeddings":512, “num_attention_heads":12, “num_hidden_layers”:12,

3. BERT 获取最后一层或每一层网络的向量输出

  • transformer 最后一层输出的结果 last_hidden_state: shape 是(batch_size, sequence_length, hidden_size=768,它是模型最后一层输出的隐藏状态 pooler_output: shape 是(batch_size, hidden_size),这是序列的第一个 token (classification token)的最后一层的隐藏状态,它是由线性层和 Tanh 激活函数进一步处 理的,这个输出不是对输入的语义内容的一个很好的总结,对于整个输入序列的隐藏状态序列 的平均化或池化通常更好。 hidden_states:这是输出的一个可选项,如果输出,需要指定 config.output_hidden_states=True,它也是一个元组,它的第一个元素是 embedding,其余元 素是各层的输出,每个元素的形状是(batch_size, sequence_length, hidden_size) attentions:这也是输出的一个可选项,如果输出,需要指定 config.output_attentions=True,它也是一个元组,它的元素是每一层的注意力权重,用于计 算 self-attention heads 的加权平均值
  • 获取每一层网络的向量输出 ##最后一层的所有 token 向量 outputs. last_hidden_state ##cls 向量

hidden_size),

033 / 3
第 3 页
第 3 页

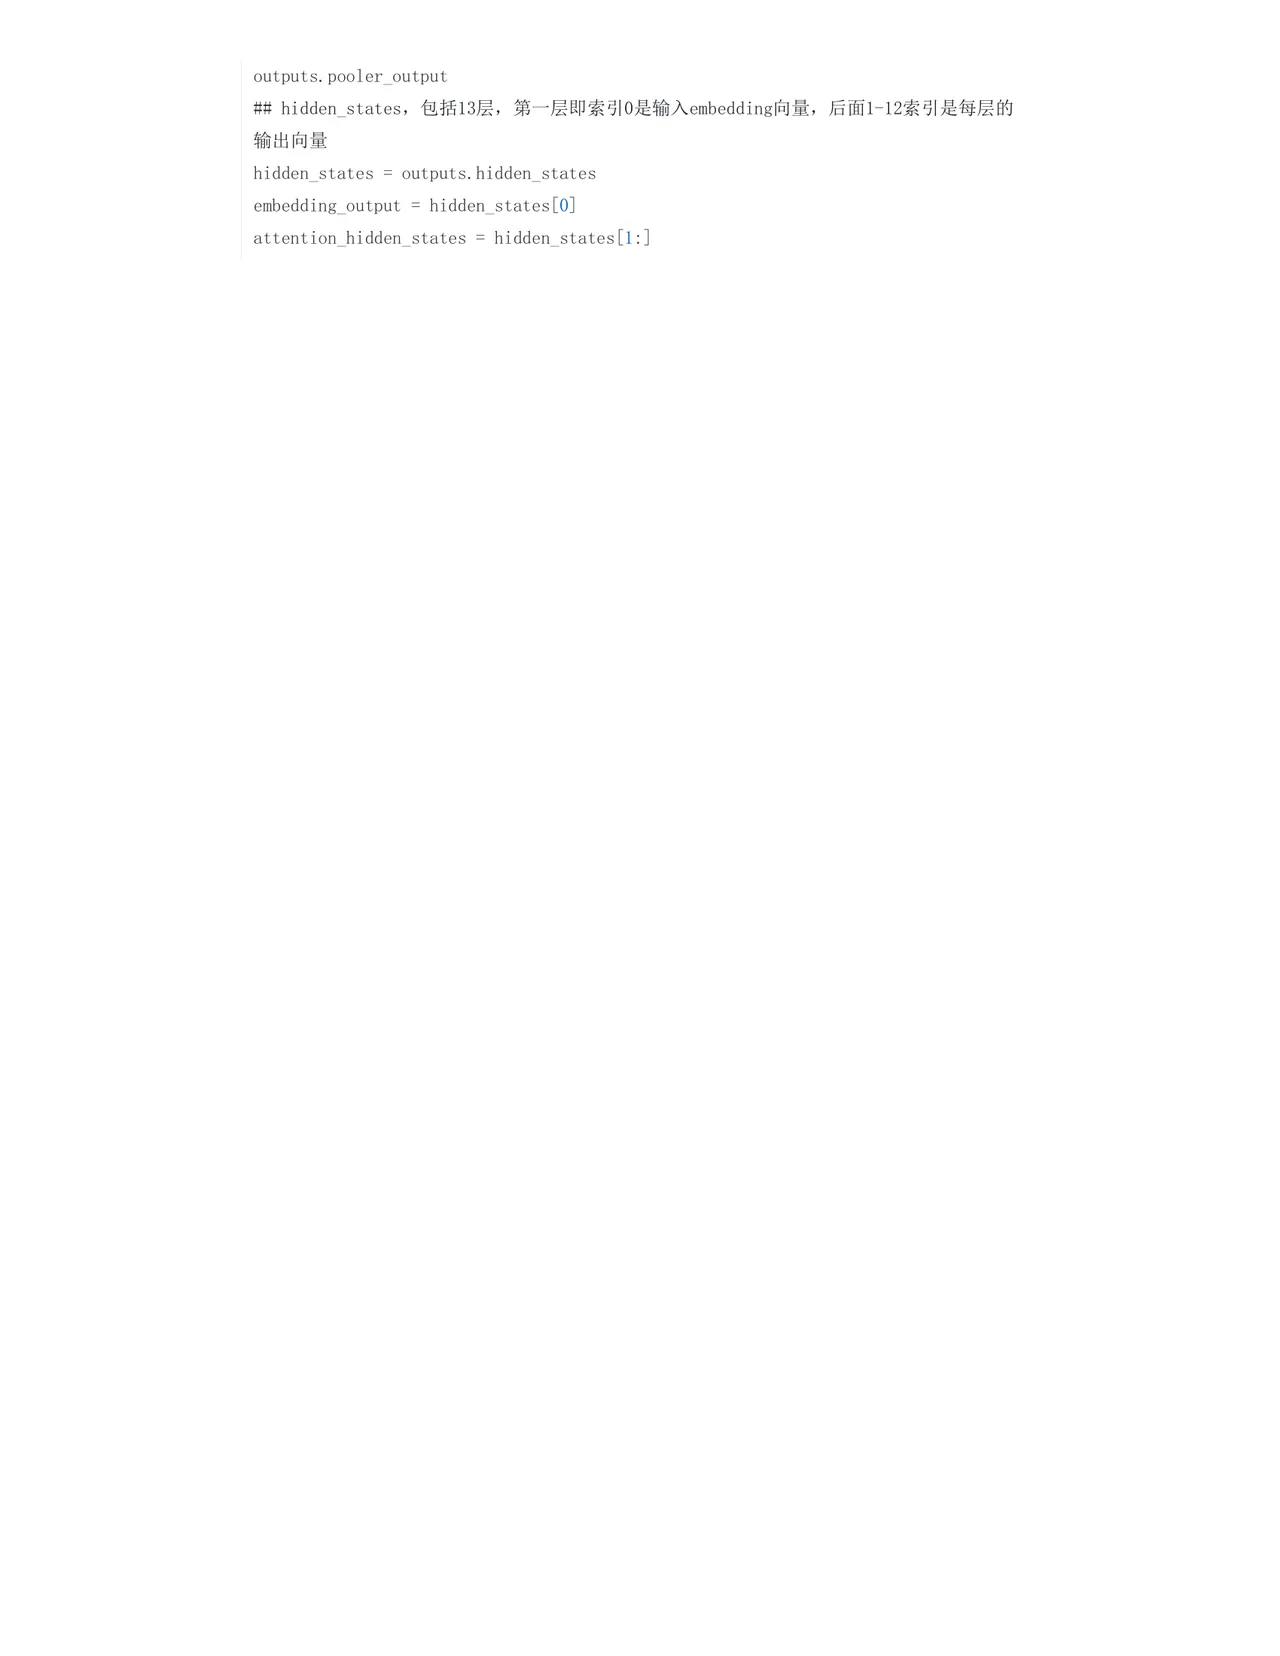
outputs. pooLer_ou…

outputs. pooLer_output ## hidden_states,包括 13 层,第一层即索引 0 是输入 embedding 向量,后面 1-12 索引是每层的 输出向量 hidden_states = outputs.hidden_states embedding_output = hidden_statesL0 ] attention_hidden_states = hidden_states [ 1:]

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求