
编码器和解码器面试题
《编码器和解码器面试题》共 0.7 万字,通篇围绕 向量、Transformer、Attention、embedding 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 常见面试题
- 1. **Transformer的整体结构**
- 2. **编码器****介绍**
- 3. **解码器介绍**
- 4 **Transformer模型总结**
- 2.1 **Input****Embedding: 怎么给Token进行编码?**
- 2.2 **Self-Attention层:细说自注意力机制**
- 2.3 **图解多头自注意力机制**
常见面试题
- Transformer的整体结构
- 编码器结构:Self-Attention层 + 前馈神经网络层
- 解码器结构:带掩码的Self-Attention层 + Self-Attention 层+一个前馈神经网络
- 编码器介绍
- Input Embedding: 怎么给Token进行编码?
- Self-Attention层:细说自注意力机制
- 图解多头自注意力机制
- 总结:自注意力层中发生了什么?
- 解码器介绍
- 解码器的第一层:带掩码的多头自注意力层
- 解码器的第二层:多头编码器-解码器注意力层
- 解码器的最后:下一词预测
- Transformer模型总结
- 模型可以去调的超参数
- 模型整体的前向传播步骤
- Transformer的牛逼之处
- Transformer的评价
#多年以后,面对AGI时,NLP从业者们会想起Google带他们去看变形金刚的那个遥远的下午。
#你说的对,但「Transformer」是谷歌自主研发的一款全新开放世界冒险游戏,中间忘了,总之就是被AGI选中的人要导引多头注意力之力,逐步发掘「大力出奇迹」的真相。
说来,为什么发布Transformer的文章名字叫Attention Is All You Need 呢?这是因为,在seq2seq把Attention机制发扬光大后,NLP领域的模型的主流架构是递归神经网络(一般是LSTM)+注意力机制,后者起到一个辅助作用。然而,LSTM再怎么样都不过是一个变种RNN,难以并行训练、发挥GPU的优势这件事让他们训练效率很慢,自然不存在大力出奇迹造出一个超级大的语言模型的可能性。
Transformer模型非常非常的激进,他直接抛弃了作为模型主体的RNN,只保留了注意力机制。这就是这个标题的由来。不得不说搞NLP的研究者们还是很笨蛋的,Attention is All You Need这篇文章牛逼了之后,大家纷纷蹭热度发文XX is All You Need,发表的论文只要采取了这个格式的标题,就很容易上热榜🤯。拒绝蹭热度从我做起!
 你就是那个解决了RNN串行训练的效率问题,在深度学习领域横扫千军的Transformer?(Google团队好像本来是想取变压器的意向。但是大家看到这词儿想到的都是变形金刚……) | 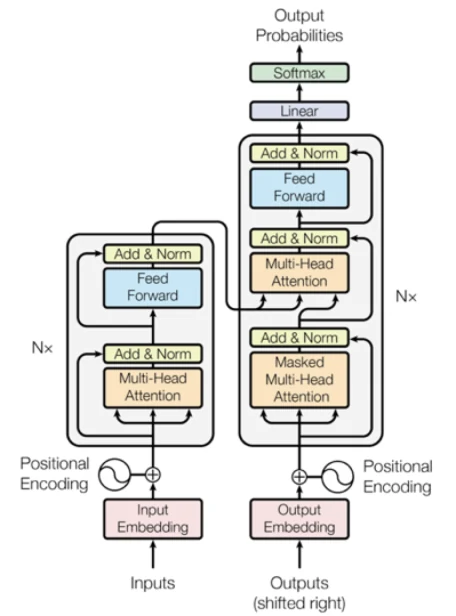 不好意思,打扰了,是这张!模型架构乍一看有点难懂,但是没关系,我们后面会把它给讲清楚的! |
|---|
1. Transformer的整体结构
上面那张图展示的就是Transformer的整体结构了,但乍一看会太过复杂。让我们先看下面这张图:
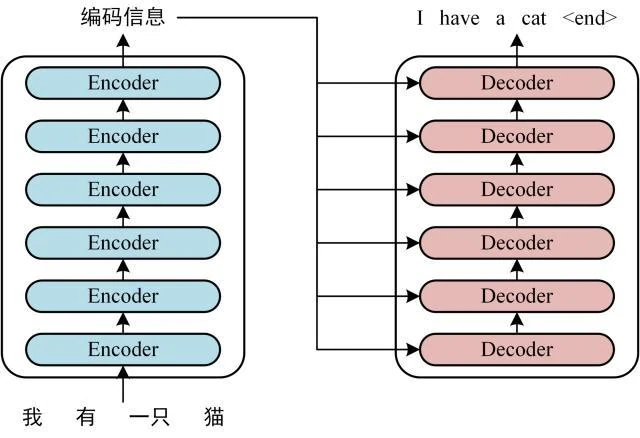
在万恶之源Attention Is All You Need 之中,原版的Transformer有六个编码器和六个解码器,是一个比较深的网络结构。可以看到,最开始的时候,Transformer主要用于神经翻译任务,所以这里先用神经翻译任务举例子。后面我们会看到对Transformer的一些魔改(Encoder-Only or Decoder-Only),从而将其用于文本生成(GPT)或者各种其他下游任务( BERT)。
1.1 编码器结构:Self-Attention层 +前馈神经网络层
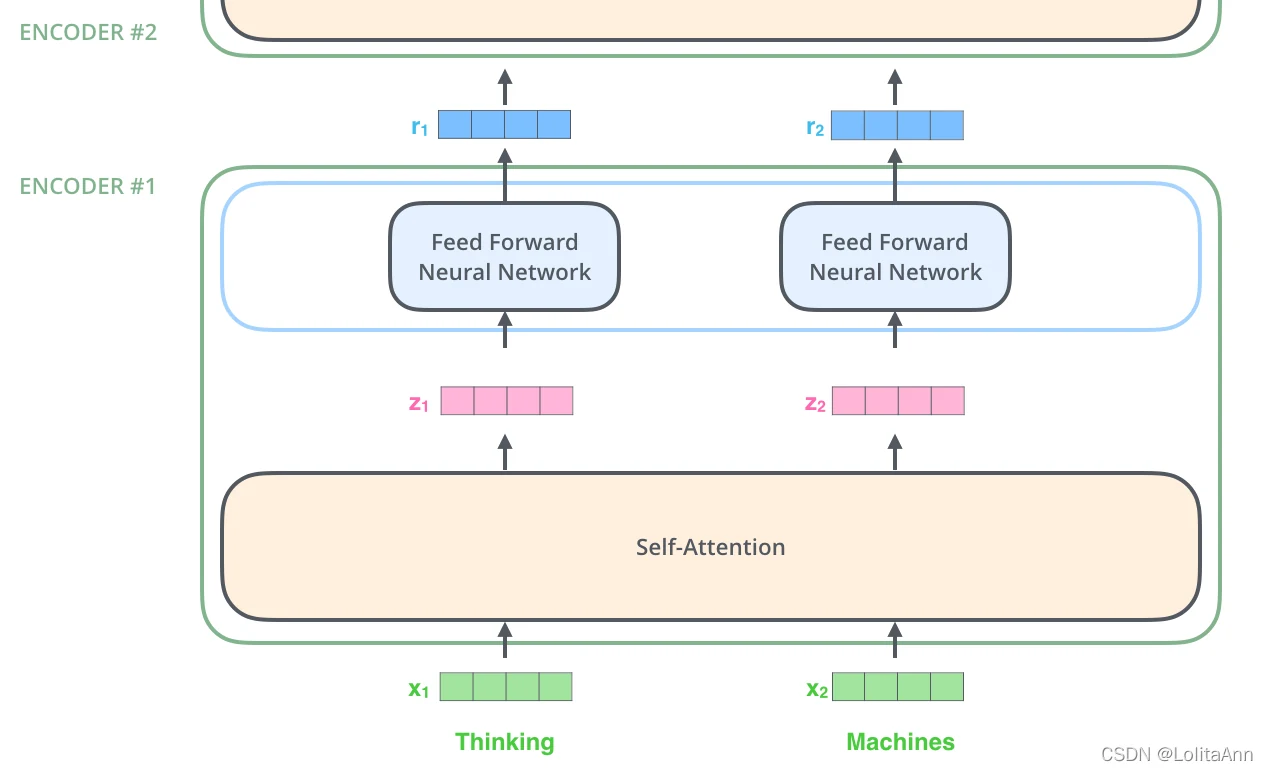
| 6个编码器组件的结构是相同的,但是他们之间的权重是不共享的,每个编码器都可以分为2个子层。 编码器的输入()首先会进入一个自注意力层,这个注意力层的作用是:当要编码某个特定的词汇的时候,它会帮助编码器关注句子中的其他词汇。之后会进行详细讲解。 自注意力层的输出()会传递给一个前馈神经网络,每个编码器组件都是在相同的位置使用结构相同(每个Encoder中的FFNN结构相同但参数不同)的前馈神经网络。 |
|---|
1.2 解码器结构:带掩码的Self-Attention层 + Self-Attention 层+一个前馈神经网络
解码器组件也含有前面编码器中提到的两个层,区别在于这两个层之间还夹了一个注意力层,多出来的这个自注意力层的连接了编码器输出的隐状态,起到了和seq2seq中的attention一样的作用。
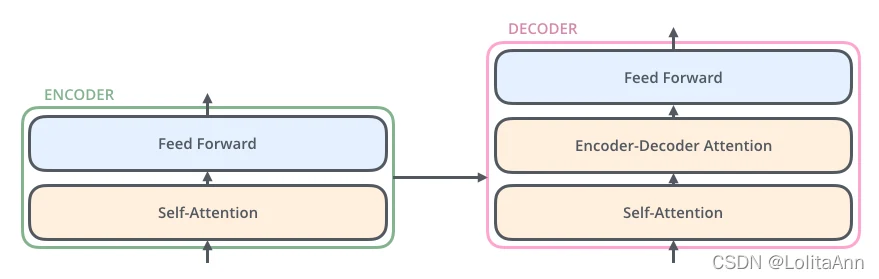
在解码器中,第一个Self-Attention和编码器的第一个自注意力层也是不同的。它是一个带掩码的自注意力层,带掩码的意思就是,对于一个总共有N个单词的词序列,在翻译到第K个单词时候,这个自注意力层只能注意到第1到第K个单词,而注意不到第K+1到第N个单词。后面我们会用一张图很清晰的展示什么是带掩码。