
神经网络训练面试题
《神经网络训练面试题》共 0.8 万字,通篇围绕 向量、数据集、面试、评估 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 常见面试题
- 神经网络的训练
- 万能逼近定理:MLP可以拟合任何函数
- MLP总结
- 前向传播(Forward Propagation)
- 梯度下降(Gradient Descent)
- 模型更新的频率与超参数
- 反向传播(Backpropagation,BP)
常见面试题
- 神经网络的训练
- 前向传播(Forward Propagation)
- 梯度下降(Gradient Descent)
- 模型更新的频率与超参数
- 反向传播(Backpropagation,BP)
- 万能逼近定理:MLP可以拟合任何函数
- MLP总结
神经网络的训练
前向传播(Forward Propagation)
介绍完神经网络的大致结构,我们就已经对前向传播这件事有一定的了解了!一张图片变成784维向量输入给神经网络的输入层的784个神经元们,而后接下来的第一层隐层根据它的78416个权重和16个偏置,产生了16个新的输出,送给了下一个隐层;下一个隐层则继续根据1616个权重和16个偏置,输出16个标量给输出层。最后,输出层在根据自己的1016个权重和10个偏置,输出10个数字。在神经网络的设计中,我们往往希望输出层输出的是一个概率分布函数,每个值都为正,而总和为1(这就是一个Softmax层可以做的!*);然后对于值最大的一个神经元对应的内容(在上面的例子中是数字),就是我们的输出。这就是前向传播!
前向传播(Forward Propagation)是一种在神经网络中进行信息传递的过程,它是神经网络训练的第一步。在前向传播中,输入数据通过神经网络的多个层(包括输入层、隐藏层和输出层)按照预定的权重和偏置进行计算,从输入层传递到输出层,最终得到神经网络的预测结果。
梯度下降(Gradient Descent)
我们已经搞懂了模型是怎么从输入到产生输出的,但我们真正要解决的机器学习问题在于,怎么让机器自己找到这13002个参数,实现学习的过程?
损失函数(Loss Function)
首先,我们需要去评估模型的表现有多坏。
损失函数(Loss Function),也称为目标函数、成本函数或目标损失函数,是在监督式学习中用来度量模型预测值与真实标签之间差异的函数。
损失函数通常被定义为一个标量值,用于衡量模型的预测值与真实标签之间的误差或损失程度。一个常见的表示损失函数的公式为:
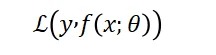
<嗯,这个符号一出现,就是损失函数的意思!>
损失函数有很多种,例如:
- 平方损失函数(Quadratic Loss Function):预测值与真实值的差的平方的二分之一。这个函数不适用于分类问题,而适用于预测的输出值是一个实数值的任务中,所以整体而言我们不会和他打太多交道(但是在强化学习的TD算法里,我们会遇到它!!)
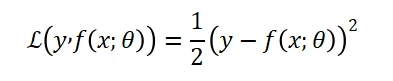
- 交叉熵损失函数(Cross-Entropy Loss Function):
交叉熵损失函数(Cross-Entropy Loss Function)是一种用于测量两个概率分布之间差异的数学函数,常常用于分类任务中,特别是在神经网络中作为损失函数。(我们后面讲的语言模型的损失函数几乎都是交叉熵损失函数!)
数学上,我们考虑模型的输出向量为一个概率分布函数的情况,定义为的输出向量的第C维。一般而言,我们希望正确的输出向量是一个one-hot向量,除了正确的标签对应的元素为1外,所有其他元素都是0.那么,
交叉熵损失函数定义如下:
语言模型里,我们经常去依据前文的信息去预测下一个单词会是什么;神经网络最后输出的其实也是一个所有词的概率分布。此时,交叉熵损失函数可以帮助我们度量模型预测的概率分布与我们真正想要的概率分布之间的差异。
不过现在讲这些可能有点太早,我们还是先关注最简单的分类问题。
我们利用模型去判断一张手写的图片是什么数字(0,1,2,3,4,5,6,7,8,9)。假设对于一个手写的数字7,我们希望模型输出的向量就是:
=[0,0,0,0,0,0,0,1,0,0]
<假设样本的标签是离散的,共有C个;那么我们可以用一个C维的one-hot向量来表示样本标签,这里C=10。假设正确的样本标签为K,那么只有第K维(这里是7)元素是1,其他都是0>
而模型实际输出的可能是:
=[0.1,0.2,0,0.1,0,0.3,0,0.1,0,0.2]
那么,交叉熵函数为:
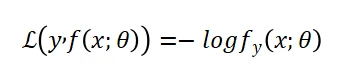
<想不到吧,就这么简单!就是模型理应输出1的那一维向量的元素的负对数>
识别的越准,LOSS就会越小。
损失函数的input是什么呢?要想清楚这个问题!
- 在MNIST数据集中,损失函数的输入是13002个参数,即前面提到过的模型参数。
- 损失函数的输出是一个实数。
- 损失函数的大小取决于模型对训练数据的综合表现。
梯度下降 Gradient Descent
在确定了训练集(MNIST数据集,有60000张训练集图片和10000张测试集图片)、确定了模型并确定了损失函数后,我们要做的其实就是让损失函数最小化了!