
入门与全局认知4187 字
有监督和无监督学习的区别
·全库 183 / 611
《有监督和无监督学习的区别》共 0.4 万字,通篇围绕 标注、语音、数据集、embedding 展开,归在「入门与全局认知」这一层。
覆盖标注语音数据集embedding向量预训练
适合刚接手 AI 项目、需要先把全局图景拼起来的人
目录骨架(7 节)
- 人工智能概念与分支
- 机器学习
- 机器学习的分类:根据学习范式分类
- 有监督学习 Supervised Learning
- 无监督学习 Unsupervised Learning
- Tik Tok推荐算法:一个有监督学习与无监督学习并用的例子
- 自监督学习 Self-supervised Learning
目录 · 3 节
人工智能概念与分支
- 人工智能(Artificial Intelligence)是让各类机器载体上模拟并拥有类似生物的智能,让机器可以进行感知、学习、识别、推理等行为的计算机科学技术。
- 人工智能是计算机科学的分支,涉及领域包括计算机视觉(Computer Vision,CV)、自然语言处理(Natural Language Processing,NLP)、语音识别(Voice Recognition)、语音生成(Text to Speech,TTS)、知识图谱(Knowledge Graph)等。本文档系大语言模型入门材料,因此主要关注NLP领域的技术。
- 从学术角度来看,人工智能有三大学派:符号主义(Symbolicism)、联结主义(Connectionism)、行为主义(Actionism)。
- 机器学习是人工智能的核心,现在最前沿的AI技术的主流算法都是基于神经网络和强化学习。
| 学派分类 | 符号主义 | 连结主义 | 行为主义 |
|---|---|---|---|
| 思想起源 | 数理逻辑:基于统计方法,通过建模预测让机器通过计算来模拟人的智能,实现识别、预测等任务 | 仿生学:生物智能是由神经网络产生的,可以通过人工方式构造神经网络,训练神经网络产生智能。 | 生物的智能来自对外界的复杂环境进行感知和适应,通过与环境和其他生物之间的相互作用,产生更强的智能。 |
| 代表算法 | 朴素贝叶斯,逻辑回归,决策树,支持向量机 | 神经网络 Neural Network | 强化学习 Reinforcement Learning |
机器学习
- 机器学习(Machine Learning,ML)是实现人工智能的核心方法,是从有限的观测数据中“学习”(or“猜测”)出一个具有一般性的规律,并利用这些规律对未知数据进行预测的方法。
- 传统的机器学习主要关注如何学习一个预测模型,一般需要首先将数据表示为一组特征(Feature),特征的表示形式可以是连续的数值/离散的符号等形式。而后将这些特征输入到预测模型,并输出预测结果。这类机器学习可以看作是浅层学习(Shallow Learning),其重要特点是不涉及特征学习,其特征主要靠人工经验或者特征转换方法来提取。
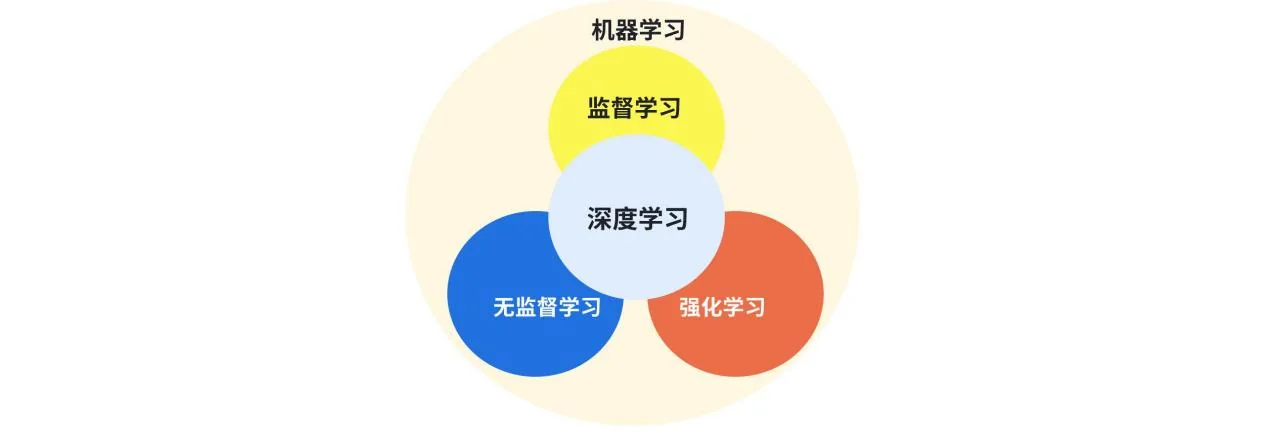
机器学习的分类:根据学习范式分类
根据学习范式的不同,机器学习可分为有监督学习、无监督学习、自监督学习和强化学习
有监督学习 Supervised Learning
有监督学习的基本定义
- 有监督学习(Supervised Learning):是机器学习中一种常见的学习范式,其基本思想是利用带有标签的训练数据来训练模型,从而使其能够从输入数据中学习到输入与输出之间的映射关系,然后可以利用这个映射关系对新的未标签数据进行预测。 <是不是很像人通过刷题的学习过程?用带了标准答案的习题集去刷题,如果做错了就根据错误的原因反思改进。当新的题目到来时,便可根据过去刷题的经验来去写新的题目。>
- 有监督学习的训练集要包括输入(特征)和输出(目标),其中,输出是人工标注的。
- 有监督学习的例子:训练一个模型用于识别一个公司的财务报表是否有财务舞弊:有1000份财务报表,每份报表上体现了资产负债率、现金流量等关键数据,我们用X指代。报表有500份舞弊的和500份没有舞弊的。
- 那么,我们就有一个1000个样本的训练数据集;X是每个训练样本的输入或者特征;该样本是否舞弊则是由人工标注的输出或者目标。对于每一份输入的训练数据,都是有一个确定的预期输出结果的,因此称为“有监督”。我们可以称这样的训练样本为“带标签的输入、输出对”。
- 利用这个训练数据集,我们对算法进行训练。整体而言,训练出了一个函数f(X),他“学习”了训练集中f(X1) = 舞弊,f(X2) = 正常,f(X3)=正常,f(X4) = 舞弊, ……,f(X1000)=舞弊的信息。当我们给出一份新的报表时,他也可以帮我们判断这个报表是舞弊的还是正常的了。
- 有监督学习的步骤如下:
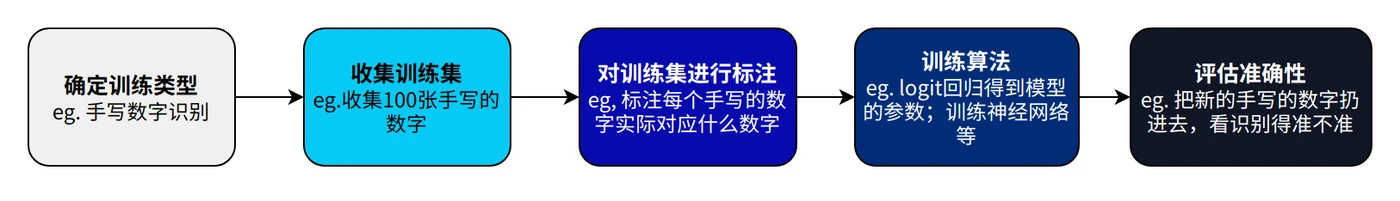
有监督学习的典型应用
| 分类(Classification):预测输入样本属于哪个类别或者类别的概率分布。典型的例子包括垃圾邮件分类、图像分类等。 回归(Regression):预测输入样本的数值输出,通常是连续的实数值。典型的例子包括房价预测、股票价格预测等。 目标检测(Object Detection):在图像或者视频中检测出目标物体的位置和类别。例如自动驾驶中识别出道路上的车辆、行人、交通标志等;或者人脸识别中判断出哪一部分是人脸。 序列生成(Sequence Generation):根据输入的序列生成输出的序列,如机器翻译、音乐生成等。 序列标注(Sequence Labeling):序列标注是一种常见的机器学习任务,其中输入数据通常是序列数据,例如文本、语音、生物信息学等。有监督学习可以对输入的序列中的每个元素进行标签预测,如命名实体识别(Named Entity Recognition,NER,指自然语言处理中,能从文本中提取如人名、地名、组织名、日期、时间、金额等具有特定意义的实体或实体类别)、语音识别(Speech Recognition)等。 |
|---|