
浅层学习和深度学习面试题
《浅层学习和深度学习面试题》共 0.3 万字,通篇围绕 向量、面试、embedding、推理 展开,归在「入门与全局认知」这一层。
适合刚接手 AI 项目、需要先把全局图景拼起来的人
目录骨架(8 节)
- 常见面试题
- 浅层学习(Shallow Learning)
- 深度学习(Deep Learning)
- 表示/表征(Representation)
- 局部表示 Local Representation
- 分布式表示(Distributed Representation)
- 表征学习(Representation Learning)
- 深度学习的定义
常见面试题
- 浅层学习的基本定义
- 特征与特征工程
- 深度学习 表示/表征/局部表示
- 分布式表示与表征学习
- 深度学习的定义
- 端到端学习
浅层学习(Shallow Learning)
机器学习的分类:根据网络的深度和复杂性分类
浅层学习通常指的是使用较少层次、较简单结构的机器学习模型,例如传统的线性回归、逻辑回归、决策树、支持向量机等。这些模型通常只有一层或者很少的层,且每一层的特征表示较为简单和浅显,不具备较强的抽象能力。
浅层学习的基本定义
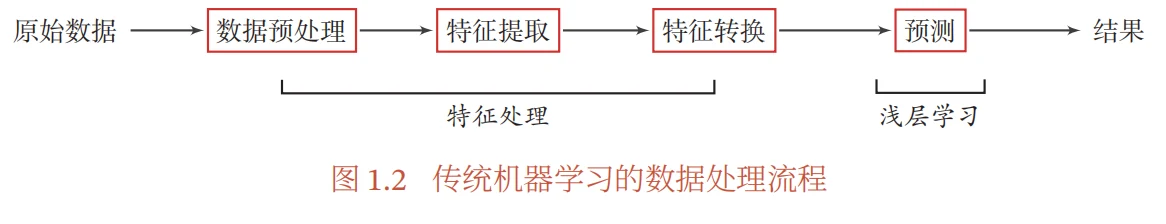
图源邱锡鹏《神经网络与深度学习》,下同
- 浅层学习(Shallow Learning),也称为表面学习或者传统学习,是一种机器学习方法,其主要通过构建浅层的、较简单的模型来进行模式识别、分类、回归等任务。
- 浅层学习方法通常包括传统的统计学习方法,如逻辑回归(Logistic Regression)、决策树(Decision Tree)、支持向量机(Support Vector Machine)、朴素贝叶斯(Naive Bayes)等,以及一些非线性模型,如K近邻(K-Nearest Neighbors)和随机森林(Random Forests)等。这些方法通常基于人工设计的特征(即特征工程),通过对特征进行处理和选择来构建模型,并利用这些模型进行预测和分类。
- 相对于深度学习(Deep Learning)而言,浅层学习通常采用较简单的模型架构和较少的层次结构,不涉及复杂的深层神经网络结构。
#浅层学习最大的特点就是特征是人工设计的,通过特征工程,去依据原始数据,决定模型的输入。
特征(Feature)
- 特征(Feature),是指从原始数据中提取出的、用于表示样本的属性或信息。(eg. 想起有监督学习任务里我们提到的财务舞弊识别的例子了吗?一份财务报表有一堆信息,机器是看不懂的。我们可能会利用财务报表,计算出资产负债率、流动比率指标,作为浮点数输入给机器。那么资产负债率和流动比率就是我们选出来的财务报表的特征!)
- 在机器学习模型中,特征被用作模型的输入,用于表示样本的不同属性,从而帮助模型进行学习和预测。因此,首先要将数据表现为一组特征,而后才能将其输入,进行机器学习。
- #特征说白了就是你基于原始信息,具体给机器喂了些什么。
特征工程(Feature Engineering)
特征工程(Feature Engineering)是指在机器学习和数据挖掘中,通过对原始数据进行处理、转换和提取,生成新的特征或选择合适的特征,从而改进模型性能和提高预测准确性的过程。
Eg. 如果想要建立起一个识别财务报表是否舞弊的模型:f(财报的特征)=是否舞弊,那么输入给模型的参数的选择有很多:资产负债率、盈利质量、流动比率、速动比率等等。
#那么选择哪些参数、输入多少参数输入给模型,其实都会对模型最后的识别性能有很高的影响。这个挖掘和选择特征的过程就是特征工程。
深度学习(Deep Learning)
在解释什么是深度学习之前,我希望先讲清楚表征与表征学习。
表示/表征(Representation)
表示(Representation)则通常指的是将数据以某种形式进行编码或者表示的方式,可以是在特征空间中的表示,也可以是在其他空间中的表示。在深度学习中,表征通常是由模型自动学习得到的,例如通过神经网络的隐藏层进行特征提取和表示学习(后面讲MLP的时候就会提到)。这种自动学习的表现通常比手工设计的特征更能够捕捉数据中的复杂模式和关系,从而提升模型的性能。
局部表示 Local Representation
局部表示,也称为离散表示或符号表示。 以颜色表示为例,我们可以用很多词来形容不同的颜色1,除了基本的“红” “蓝”“绿”“白”“黑”等之外,还有很多以地区或物品命名的,比如“中国红”“天蓝色”“咖啡色”“琥珀色”等.如果要在计算机中表示颜色,一般有两种表示方法.如果以不同名字来命名不同的颜色,这种表示方式叫作局部表示。
局部表示通常可以表示为One-hot向量的形式,假设假设所有颜色的名字构成一个词表 𝒱,词表大小为 |𝒱|.我们可以用一个|𝒱|维的one-hot向量来表示每一种颜色.在第𝑖种颜色对应的one-hot向量中,第𝑖 维的值为1,其他都为0.
例子参考下表,展示了琥珀色、天蓝色、中国红、咖啡色的局部表示方式。
在后续讲到自然语言处理时,就会提到,早期的语言模型中我们主要用one-hot向量来作为词汇的表征。
局部表示有两个优点:
1)这种离散的表示方式具有很好的解释性,有利于人工归纳和总结特征,并通过特征组合进行高效的特征工程;
2)通过多种特征组合得到的表示向量通常是稀疏的二值向量,当用于线性模型时计算效率非常高.