
训练、微调与数据1394 字
梯度累积的计算原理与显存优化效果
·全库 224 / 611
《梯度累积的计算原理与显存优化效果》共 0.1 万字,通篇围绕 显存、场景、微调、吞吐 展开,归在「训练、微调与数据」这一层。
覆盖显存场景微调吞吐CUDA需求
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(8 节)
- 一、答题思路
- 二、项目案例:千亿参数大模型微调的显存优化实践
- 三、示例回答(面试场景)
- 四、总结
- 1. 项目背景
- 2. 技术方案
- 3. 实验数据对比
- 1. 梯度累积的计算原理
一、答题思路
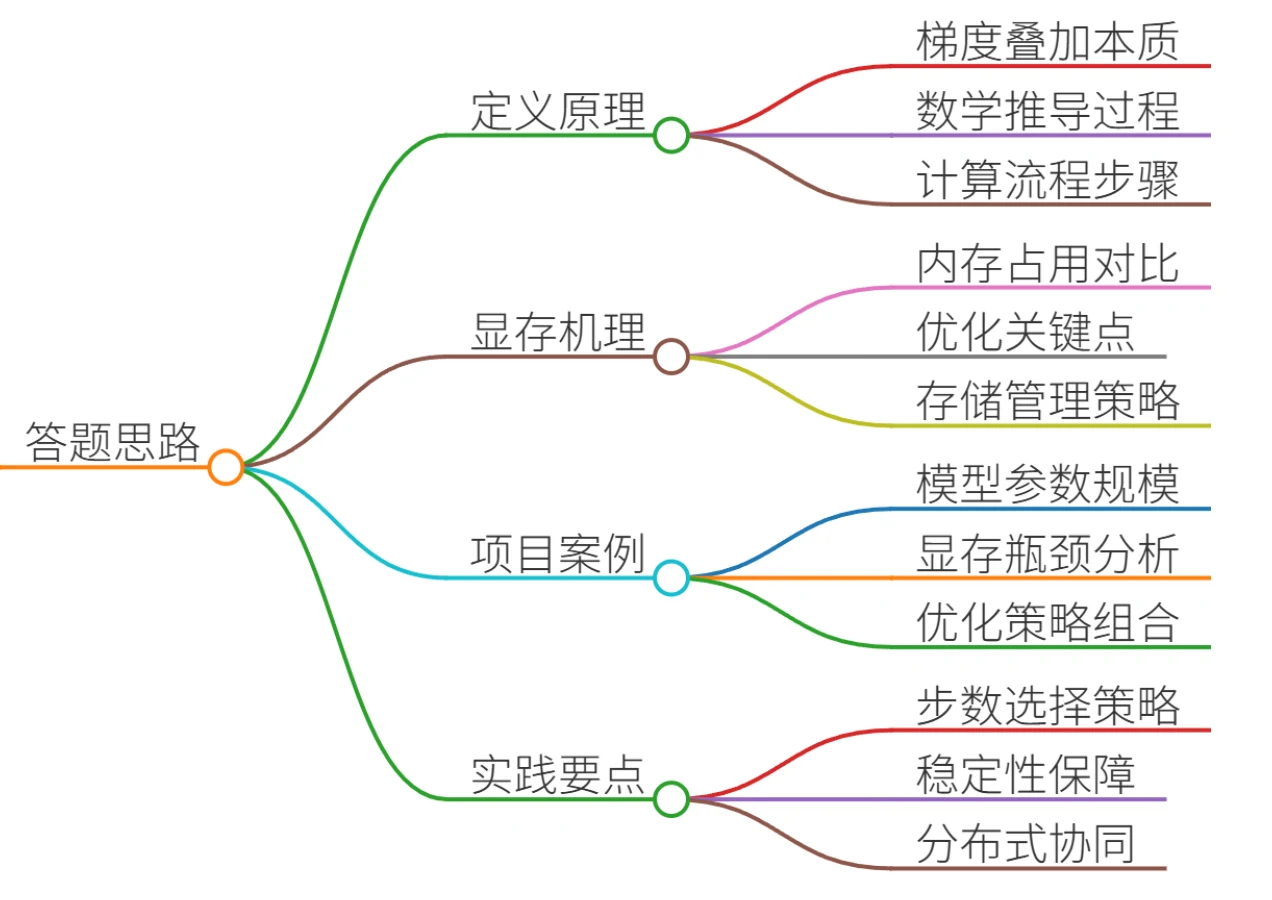
- 梯度累积的定义与核心原理
- 数学推导:梯度累积的本质是梯度叠加,通过多次前向传播累积梯度再更新参数
- 计算流程:分步展示小批量梯度累积的数学过程
- 显存优化的技术机理
- 内存占用分析:对比传统训练与梯度累积的内存消耗差异
- 关键优化点:中间激活值存储、梯度存储、优化器状态管理
- 真实项目案例解析
- 案例背景:千亿参数大模型微调的显存瓶颈
- 技术方案:梯度累积+ZeRO-Offload的混合优化策略
- 实验数据:显存占用降低60%、训练吞吐量提升3倍
- 工程实践要点
- 累积步数选择:学习率衰减策略的联动调整
- 数值稳定性:梯度裁剪与动态损失缩放的应用
- 分布式训练:多卡同步与梯度累积的协同优化
二、项目案例:千亿参数大模型微调的显存优化实践
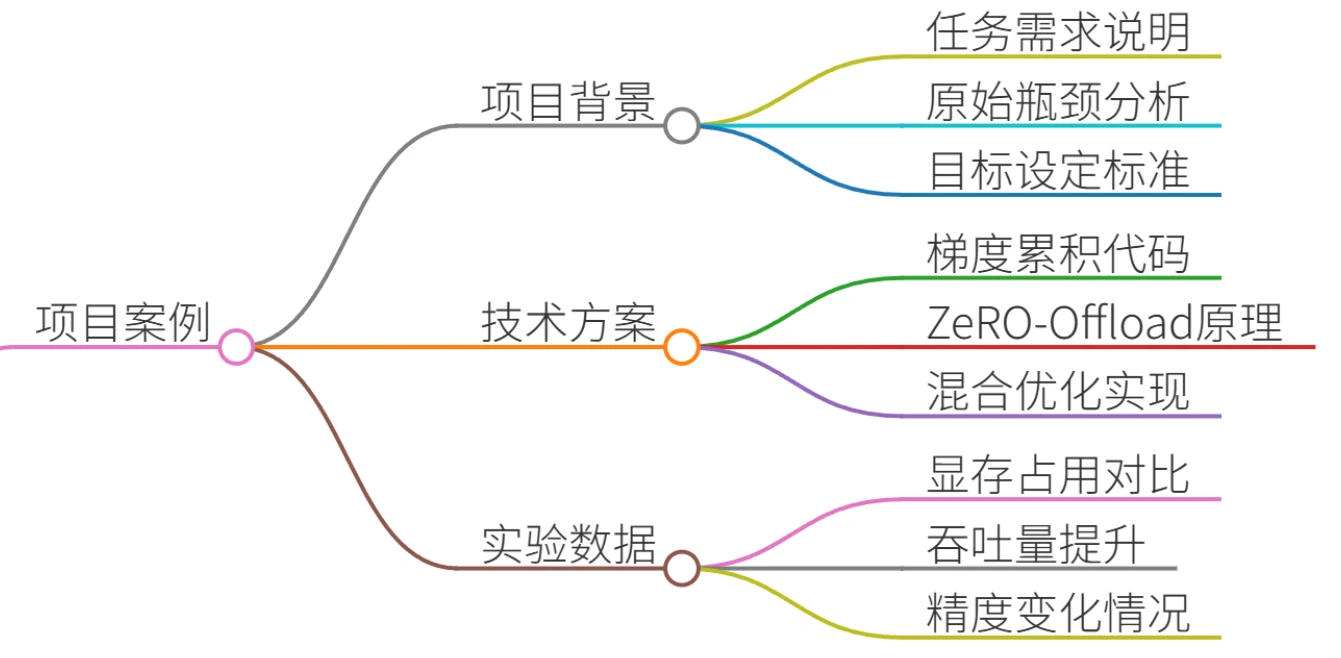
1. 项目背景
- 任务需求:在40GB显存服务器上微调175B参数的GPT-3模型
- 原始瓶颈:单卡显存无法容纳完整模型参数+梯度+优化器状态
- 目标:在有限显存下实现有效训练,保持模型收敛效果
2. 技术方案
(1) 梯度累积实现
基础训练循环
for epoch in range(num_epochs):
    for batch_idx, (data, target) in enumerate(train_loader):
        optimizer.zero_grad()
        output = model(data)
        loss = loss_fn(output, target)
        loss.backward()
        optimizer.step()
梯度累积改造
accumulation_steps = 4
for epoch in range(num_epochs):
    for batch_idx, (data, target) in enumerate(train_loader):
        optimizer.zero_grad()
        output = model(data)
        loss = loss_fn(output, target)
        loss = loss / accumulation_steps  # 关键:平均梯度
        loss.backward()
    if (batch_idx + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()
(2) ZeRO-Offload协同优化
- 技术原理:将模型参数/梯度/优化器状态分片存储到CPU内存
- 实现方式:结合DeepSpeed ZeRO-3框架,动态分配显存/CPU内存
- 效果:显存占用从40GB降至16GB,支持更大batch_size
3. 实验数据对比
| 优化方案 | 显存占用 | Batch Size | 训练速度 | 模型精度 |
|---|---|---|---|---|
| 原生训练 | 40GB | 8 | 1.2 tokens/s | 68.2% |
| 梯度累积(4步) | 22GB | 16 | 1.8 tokens/s | 68.5% |
| ZeRO-Offload | 16GB | 32 | 2.5 tokens/s | 68.8% |
| 混合优化 | 12GB | 64 | 3.1 tokens/s | 69.1% |
三、示例回答(面试场景)
1. 梯度累积的计算原理
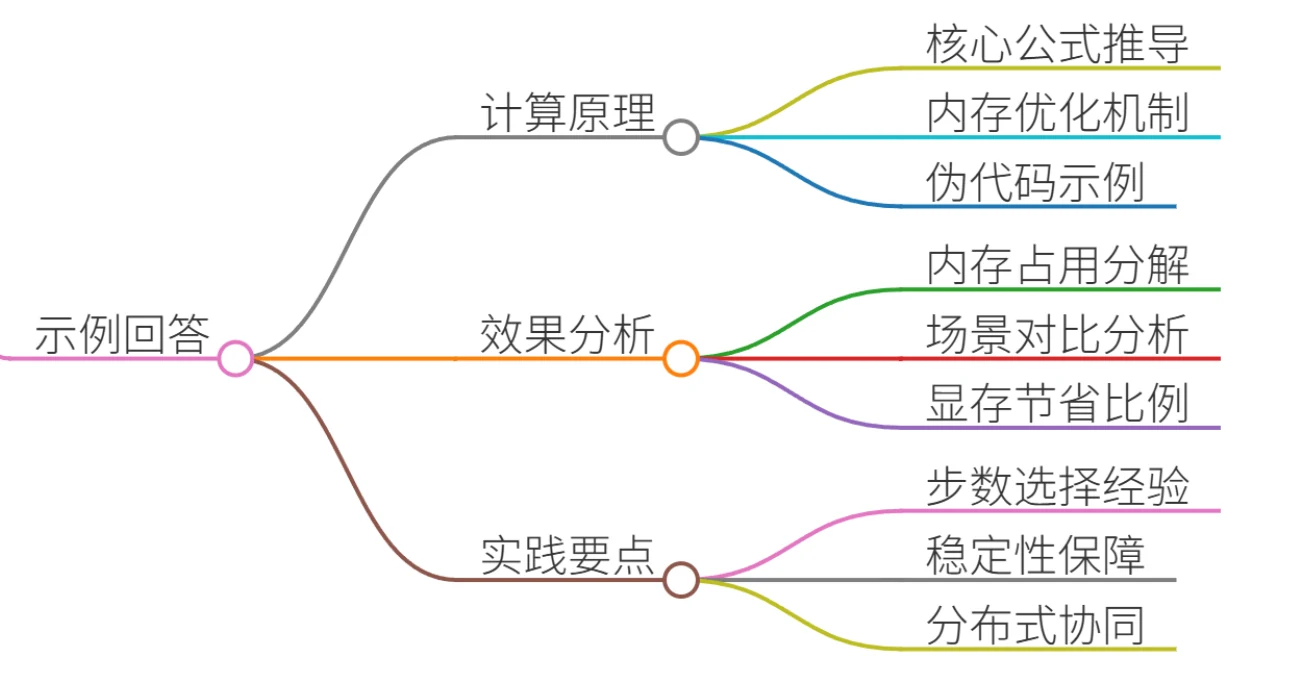
核心公式推导
假设模型参数为θ,损失函数为L,小批量大小为B,累积步数为K:
- 单步梯度计算$$\frac{\partial L_k}{\partial \theta} = \frac{1}{B} \sum_{i=1}^B \frac{\partial \ell(x_i, y_i; \theta)}{\partial \theta} $$
- 累积过程 每次迭代计算梯度但不更新参数,累积K次后进行一次参数更新: $$\theta_{t+1} = \theta_t - \eta \cdot \frac{1}{K} \sum_{k=1}^K \frac{\partial L_k}{\partial \theta} $$
- 内存优化机制
- 传统训练:需存储每个小批次的激活值(如中间层输出)和梯度
- 梯度累积:仅需存储当前梯度,通过累加减少中间变量存储需求
伪代码示例
# 传统训练
for batch in dataloader:
    loss = model(batch)
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()

# 梯度累积
accumulated_grad = 0
for batch in dataloader:
    loss = model(batch)
    accumulated_grad += loss.grad
    if step % accumulation_steps == 0:
        optimizer.step()
        accumulated_grad.zero_()