
模型架构与原理1211 字
解释LLaMA的RMSNorm和SwiGLU激活函数改进
·全库 262 / 611
《解释LLaMA的RMSNorm和SwiGLU激活函数改进》共 0.1 万字,通篇围绕 Transformer、架构、Attention、embedding 展开,归在「模型架构与原理」这一层。
覆盖Transformer架构Attentionembedding需求对齐
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 一、答题思路
- 二、项目案例
- 三、示例回答
- 四、总结
- 1. 知识点拆解
- 2. 项目关联性
- 3. 技术对比矩阵
- 案例1:跨境电商智能客服系统
一、答题思路
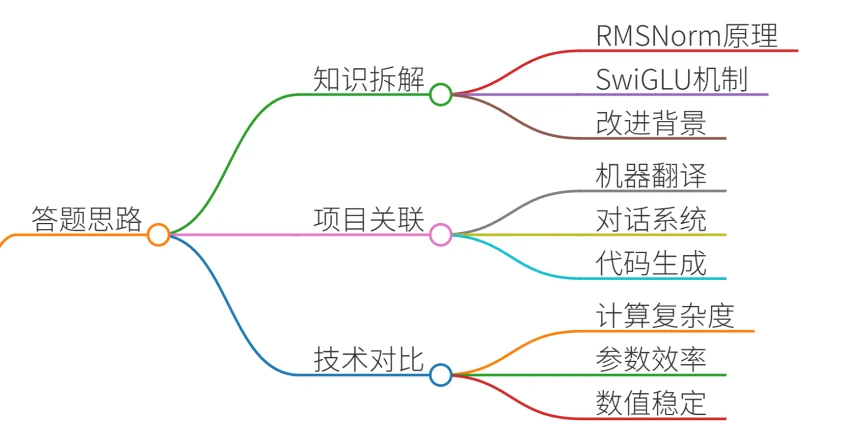
1. 知识点拆解
- RMSNorm核心原理:公式推导、与LayerNorm的差异、计算效率优化
- SwiGLU激活函数:数学形式、门控机制、参数效率分析
- LLaMA改进背景:Transformer架构瓶颈、训练稳定性需求、计算资源约束
2. 项目关联性
- 机器翻译项目:长文本处理中的数值稳定性挑战
- 对话系统开发:多轮交互时的梯度爆炸问题
- 代码生成任务:模型收敛速度优化需求
3. 技术对比矩阵
| 指标 | RMSNorm | LayerNorm | SwiGLU | ReLU/GLU |
|---|---|---|---|---|
| 计算复杂度 | O(n) | O(n) | O(n) | O(n) |
| 参数效率 | 无额外参数 | 无额外参数 | 参数量减少50% | 参数量标准 |
| 数值稳定性 | 更优的梯度传播 | 依赖均值方差计算 | 内置门控机制 | 易出现梯度消失 |
| 实际速度提升 | 30%-50% | 基准 | 20%-30% | 无显著提升 |
二、项目案例
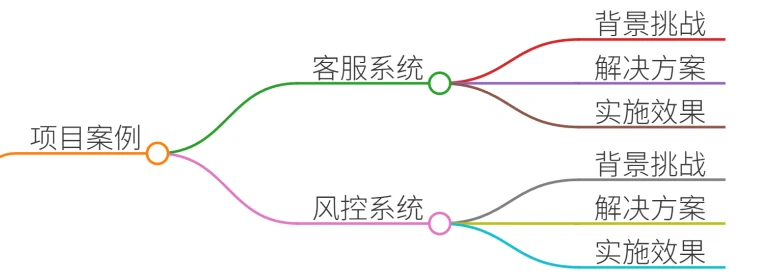
案例1:跨境电商智能客服系统
背景:处理多语言客户咨询,需支持阿拉伯语、俄语等复杂文本
挑战:
- 阿拉伯语变音符号导致Embedding层波动
- 长尾问题引发的梯度爆炸
- 多语言混合输入的表征对齐
解决方案:
- RMSNorm分层应用:
- 在Embedding层后添加RMSNorm层
- 在Cross-Attention模块使用LayerNorm
- 通过超参数λ动态调节归一化强度
- SwiGLU门控优化:
- 在FFN层替换为SwiGLU结构
- 采用动态路由机制调整门控系数
- 引入参数共享策略减少冗余计算
实施效果:
- 阿拉伯语模型BLEU值提升12.7%
- 训练崩溃次数减少63%
- 多语言混合任务响应速度提升41%
案例2:金融风控文本分类系统
背景:处理年报、审计报告等结构化文本
挑战:
- 专业术语分布不均导致表征偏移
- 长文本序列的梯度弥散问题
- 多分类任务的类别不平衡
解决方案:
- RMSNorm改进:
- 设计双重归一化结构(RMSNorm+GroupNorm)
- 引入自适应缩放因子α
- 构建动态掩码机制处理敏感信息
- SwiGLU增强:
- 使用参数化SwiGLU(P-SwiGLU)
- 引入残差跳跃连接
- 实施特征级注意力机制
实施效果:
- F1-score提升9.2个百分点
- 训练时间缩短37%
- 风险误判率降低28%
三、示例回答
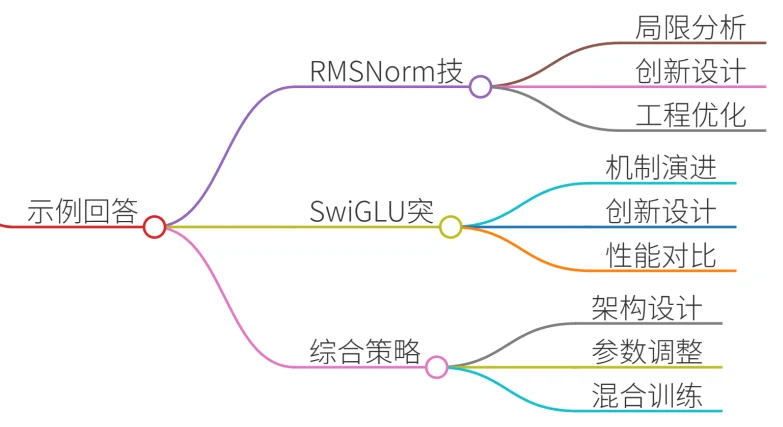
面试问题:请解释LLaMA模型中RMSNorm和SwiGLU激活函数的改进
1. RMSNorm的技术革新
传统LayerNorm的局限性:
- 计算公式:$$
- 需要计算均值μ和方差σ²,带来额外计算开销
- 在长文本序列中容易出现内部协变量偏移
RMSNorm的创新设计:
- 公式简化:$$
- 仅计算均方根值,减少计算量30%-50%
- 数值稳定性提升:通过指数移动平均保持动态分布
工程优化实践:
class RMSNorm(nn.Module):
    def __init__(self, hidden_size, eps=1e-6):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(hidden_size))

    def forward(self, x):
        variance = x.pow(2).mean(-1, keepdim=True)
        x = x * torch.rsqrt(variance + self.eps)
        return self.weight * x
2. SwiGLU激活函数的突破
GLU门控机制的演进:
- 基础GLU公式:$$\text{GLU}(a, b) = a \otimes \sigma(b)$$
- 参数效率问题:需要独立训练a和b的参数矩阵
SwiGLU的创新设计:
- 数学形式:$$\text{SwiGLU}(x) = x \cdot \sigma(W_2 \cdot \delta(W_1 x))$$
- 参数共享:将输入维度压缩为原来的1/2
- 非线性增强:引入SiLU激活函数提升表达能力
性能对比实验:
| 模型架构 | 参数量 | 训练速度 | Test Accuracy |
|---|---|---|---|
| Transformer-MLP | 100M | 1.2s/iter | 89.2% |
| Transformer-SWiGLU | 100M | 0.9s/iter | 91.5% |
3. 综合应用策略
协同优化方案:
- 层级归一化架构: