
Agent 与工具调用1236 字
Dify搭建股票价格趋势智能体
·全库 271 / 611
《Dify搭建股票价格趋势智能体》共 0.1 万字,通篇围绕 工作流、Dify、提示词 展开,归在「Agent 与工具调用」这一层。
覆盖工作流Dify提示词
适合要让 AI 真的去干活、不只是陪人聊天的人
目录骨架(4 节)
- 文档提取器
- LLM大语言模型
- echarts代码转换生成
- 直接回复
课程内容
本次我们将基于Dify.AI的Workflow引擎,构建上证综指5日K线可视化组件。话不多说我们先看一下实现效果。
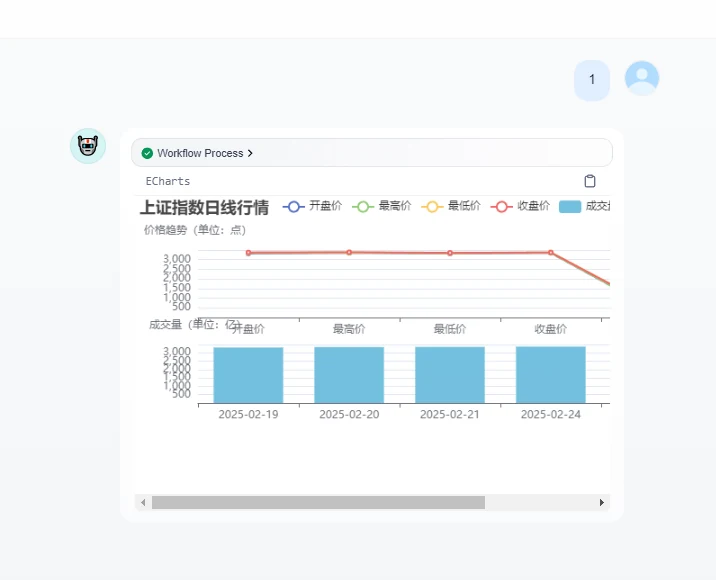
工作流展示
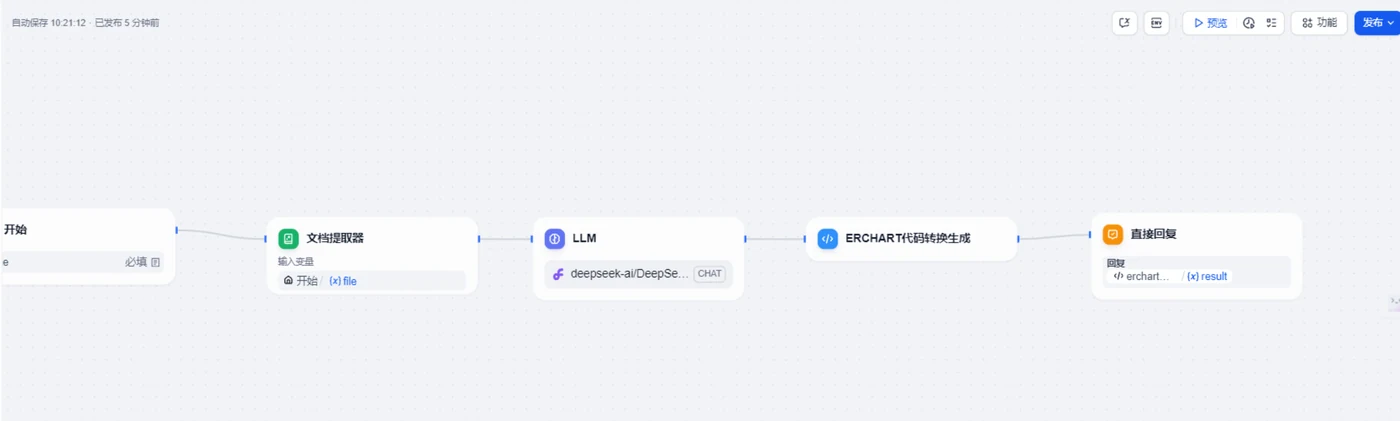
创建趋势图展示工作流
开始
首选我们先定义一个开始节点,这个开始节点需要设置1个文本上传输入参数,目前这个主要使用excel。所以我们设置文件类型。
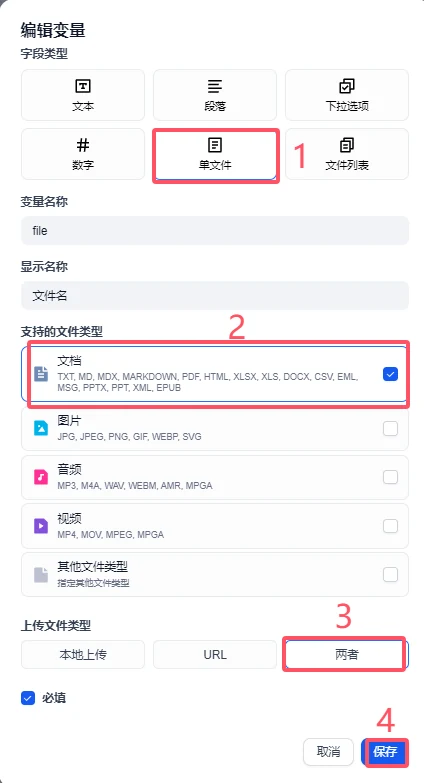
按照上图设置一个file作为开始节点的输入参数。
文档提取器
这个地方我们需要接受开始节点上传的excel 文件,通过这个文档提取器提取文档里面的内容。输入变量是file
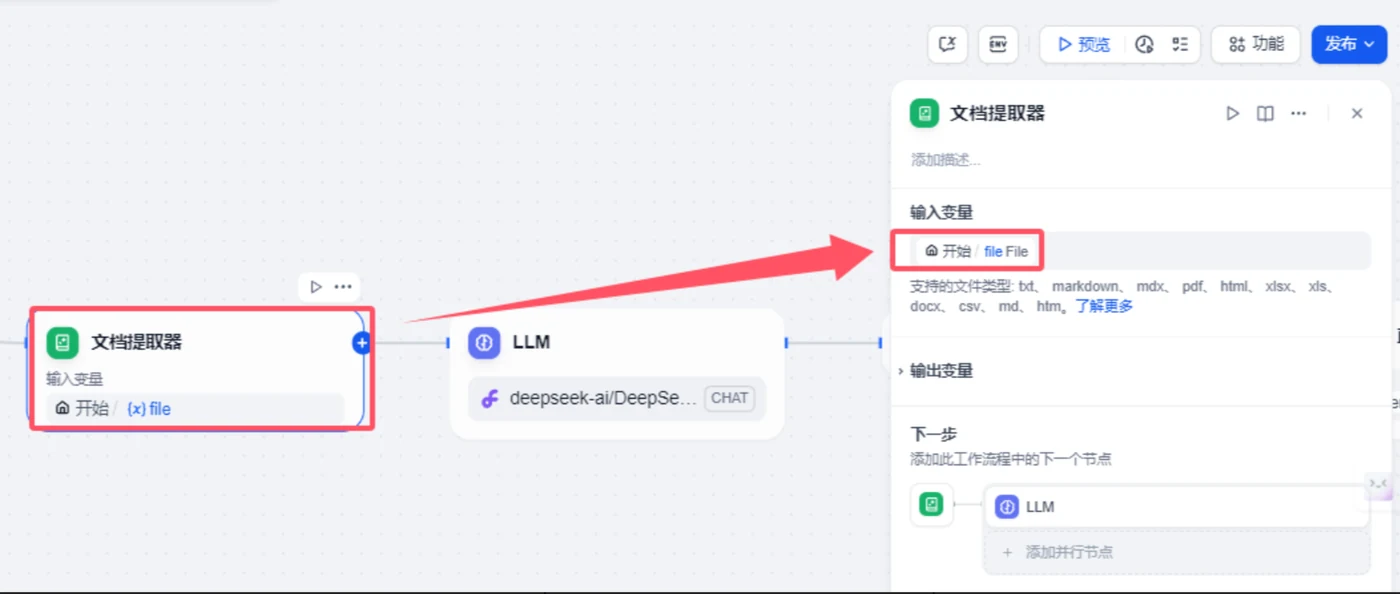
LLM大语言模型
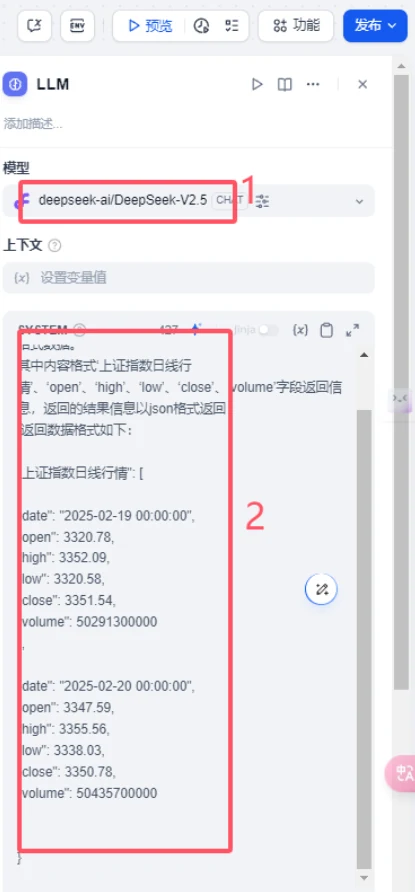
这个地方我们需要设置一个大语言模型,通过这个大语言模型提取 excel文本内容信息。这里模型我们选择deepseekv2.5的模型,使用硅基流动提供的deepseek模型,有的小伙伴可以问为什么不用v3 和R1模型呢?这里我们只提取文本内容,所以不需要非常厉害的模型。另外硅基最近流量比较大我们选个小模型这样反而速度更快点。
系统提示词
你是一个文档提取专家,请根据用户上传文档内容{{#1740472111460.text#}}提取该表格里面的数据返回json格式数据。
其中内容格式‘上证指数日线行情’、‘open’、‘high’、‘low’、‘close’、‘volume’字段返回信息,返回的结果信息以json格式返回
 返回数据格式如下:
{
"上证指数日线行情": [
{
"date": "2025-02-19 00:00:00",
"open": 3320.78,
"high": 3352.09,
"low": 3320.58,
"close": 3351.54,
"volume": 50291300000
},
{
"date": "2025-02-20 00:00:00",
"open": 3347.59,
"high": 3355.56,
"low": 3338.03,
"close": 3350.78,
"volume": 50435700000
}
]
}
模型的其他设置这里没有过多讲解的地方。
echarts代码转换生成
这个地方是本次工作流的一个难点,主要的作用就是通过上个节点的大语言模型提取输出的json格式的数据通过python 代码和echarts来实现数据组装。
代码如下:
import json
import os
import re

def main(json_str: str) -> dict:
    try:
        # 预处理:清理非 JSON 部分
        json_match = re.search(r'\{.*\}', json_str, re.DOTALL)
        if not json_match:
            return {"result": "Error: Invalid JSON format"}
        # 提取合法的 JSON 部分
        cleaned_json_str = json_match.group(0)
        # 解析JSON数据
        data = json.loads(cleaned_json_str)
        filename = data.get("filename", "stock_chart.html")
        stock_data = data.get("上证指数日线行情", [])
        # 准备数据格式
        dates = [item['date'].split(' ')[0] for item in stock_data]  # 提取日期部分(去掉时间)
        open_prices = [item['open'] for item in stock_data]
        close_prices = [item['close'] for item in stock_data]
        low_prices = [item['low'] for item in stock_data]
        high_prices = [item['high'] for item in stock_data]
        volumes = [item['volume'] / 1e8 for item in stock_data]  # 转换为亿单位
        # 构建ECharts配置
        echarts_config = {
            "title": {
                "text": "上证指数日线行情"
            },
            "legend": {
                "data": ["开盘价", "最高价", "最低价", "收盘价", "成交量"]
            },
            "tooltip": {},
            "dataset": {
                "source": [
                    ["日期", "开盘价", "最高价", "最低价", "收盘价", "成交量"],
                    *[[dates[i], open_prices[i], high_prices[i], low_prices[i], close_prices[i], volumes[i]]
                      for i in range(len(dates))]
                ]
            },
            "xAxis": [
                {"type": "category", "gridIndex": 0},
                {"type": "category", "gridIndex": 1}
            ],
            "yAxis": [
                {
                    "gridIndex": 0,
                    "name": "价格趋势(单位:点)"
                },
                {
                    "gridIndex": 1,
                    "name": "成交量(单位:亿)"
                }
            ],
            "grid": [
                {"bottom": "55%"},
                {"top": "55%"}
            ],
            "series": [
                # 第一个网格中的折线图系列
                {"type": "line", "seriesLayoutBy": "row", "name": "开盘价"},
                {"type": "line", "seriesLayoutBy": "row", "name": "最高价"},
                {"type": "line", "seriesLayoutBy": "row", "name": "最低价"},
                {"type": "line", "seriesLayoutBy": "row", "name": "收盘价"},
                # 第二个网格中的柱状图系列
                {"type": "bar", "xAxisIndex": 1, "yAxisIndex": 1, "name": "成交量"}
            ]
        }
        # 生成输出文件
        output = "echarts\n" + json.dumps(echarts_config, indent=2, ensure_ascii=False) + "\n"
        # 返回结果
        return {
            "result": output
        }
    except Exception as e:
        return {
            "result": f"Error: {str(e)}"
        }