
Dify一键获取热榜文章内容
《Dify一键获取热榜文章内容》共 0.2 万字,通篇围绕 Dify、工作流、提示词、Transformer 展开,归在「框架与工具链」这一层。
适合要选技术栈、不想把别人踩过的坑重踩一遍的人
目录骨架(8 节)
- 1.开始
- 2.http请求
- 3.llm(文本类大语言模型)
- 4 .转换
- 5 迭代
- 6 模版转换2
- 7 结束
- jina-ai 使用
课程内容
- dify 迭代循环节点使用
- Jina Reader从网站爬取信息
- http 请求
- 生成热榜文章内容
前言
我们每天需要通过app或者PC电脑浏览网页了解最新信息咨询,目前市面上APP应用非常多。我们手机上不可能装很多APP,另外也懒得找这些最新的热点信息。我们希望通过dify工作流每天定时推送实时新闻给我们,最好是推送到我手机上 推送到微信最好了。
以上就是我们本次的需求,看似很简单但是实现起来还是有不少技术点需要去克服了。下面分解一下技术路线。
- 需要通过第三方接口或者爬虫获取最新的新闻资讯-爬虫技术
- 需要将爬取的信息整理出来-llm大语言模型技术
- 需要将整理好的新闻信息发送到企业微信、微信、飞书、QQ、钉钉等IM软件。(下期文章会介绍这方面内容)。
我们先给大家看一下 实现的一个效果。
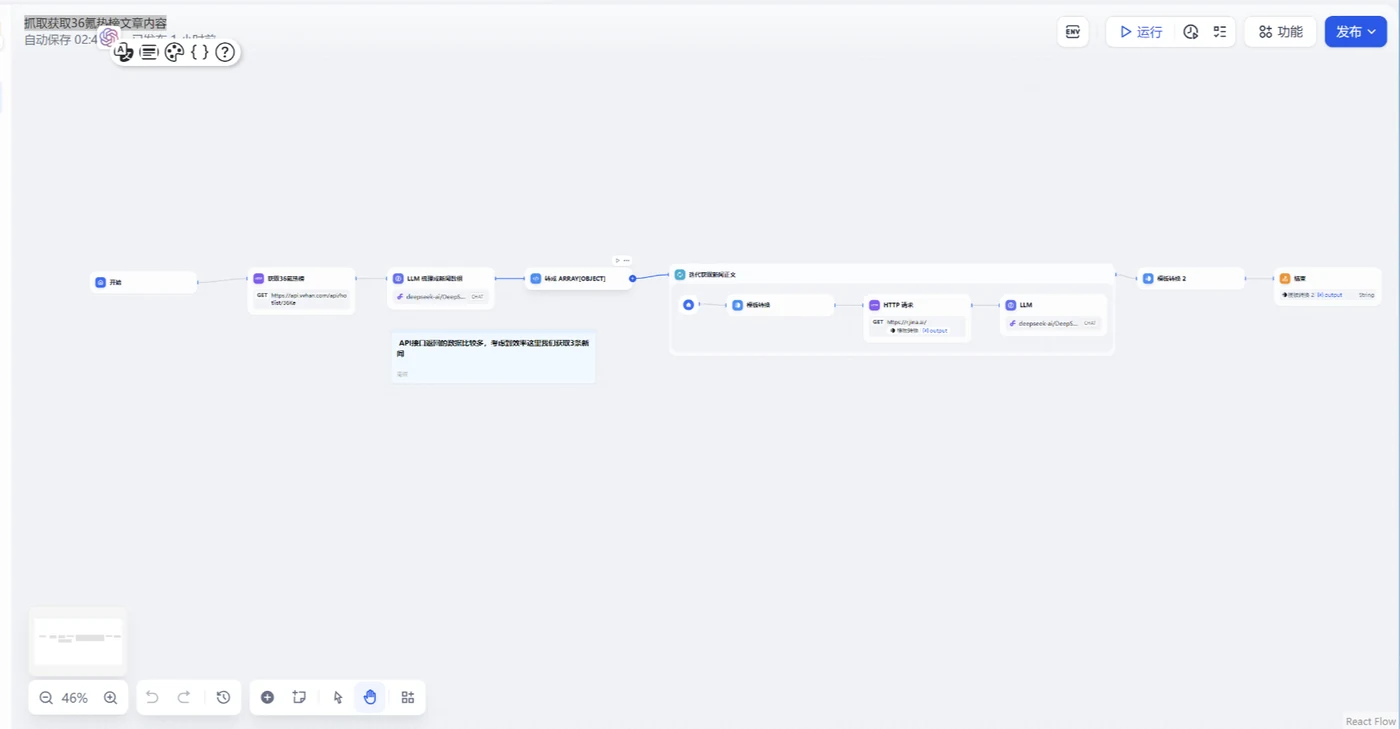
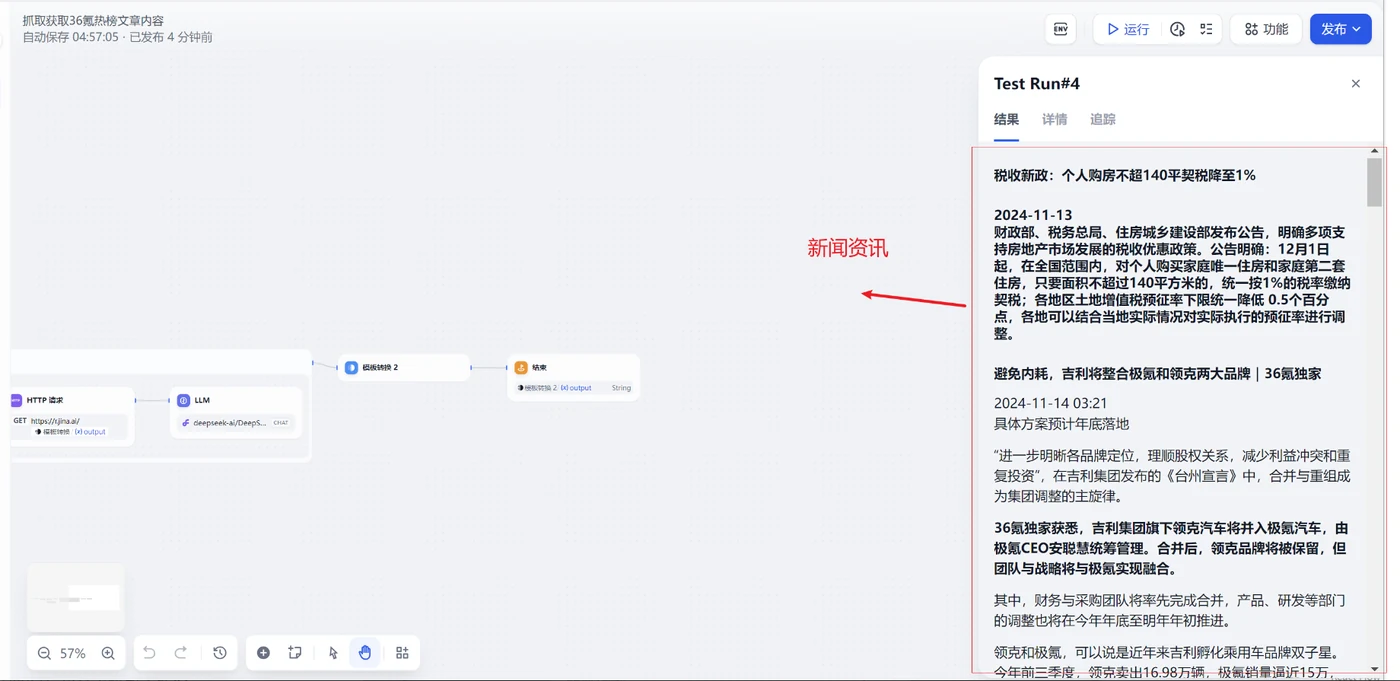
一、创建工作流
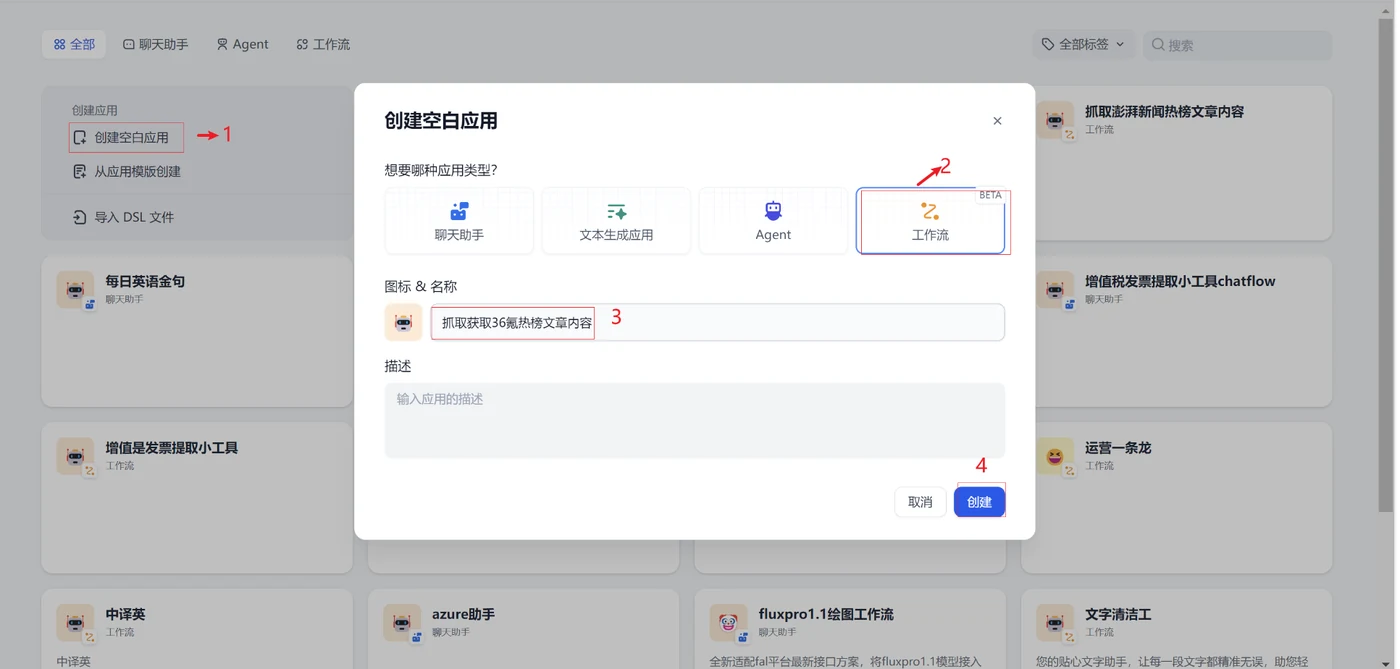
来到Dify中按下图顺序依次点击并点击创建
1.开始
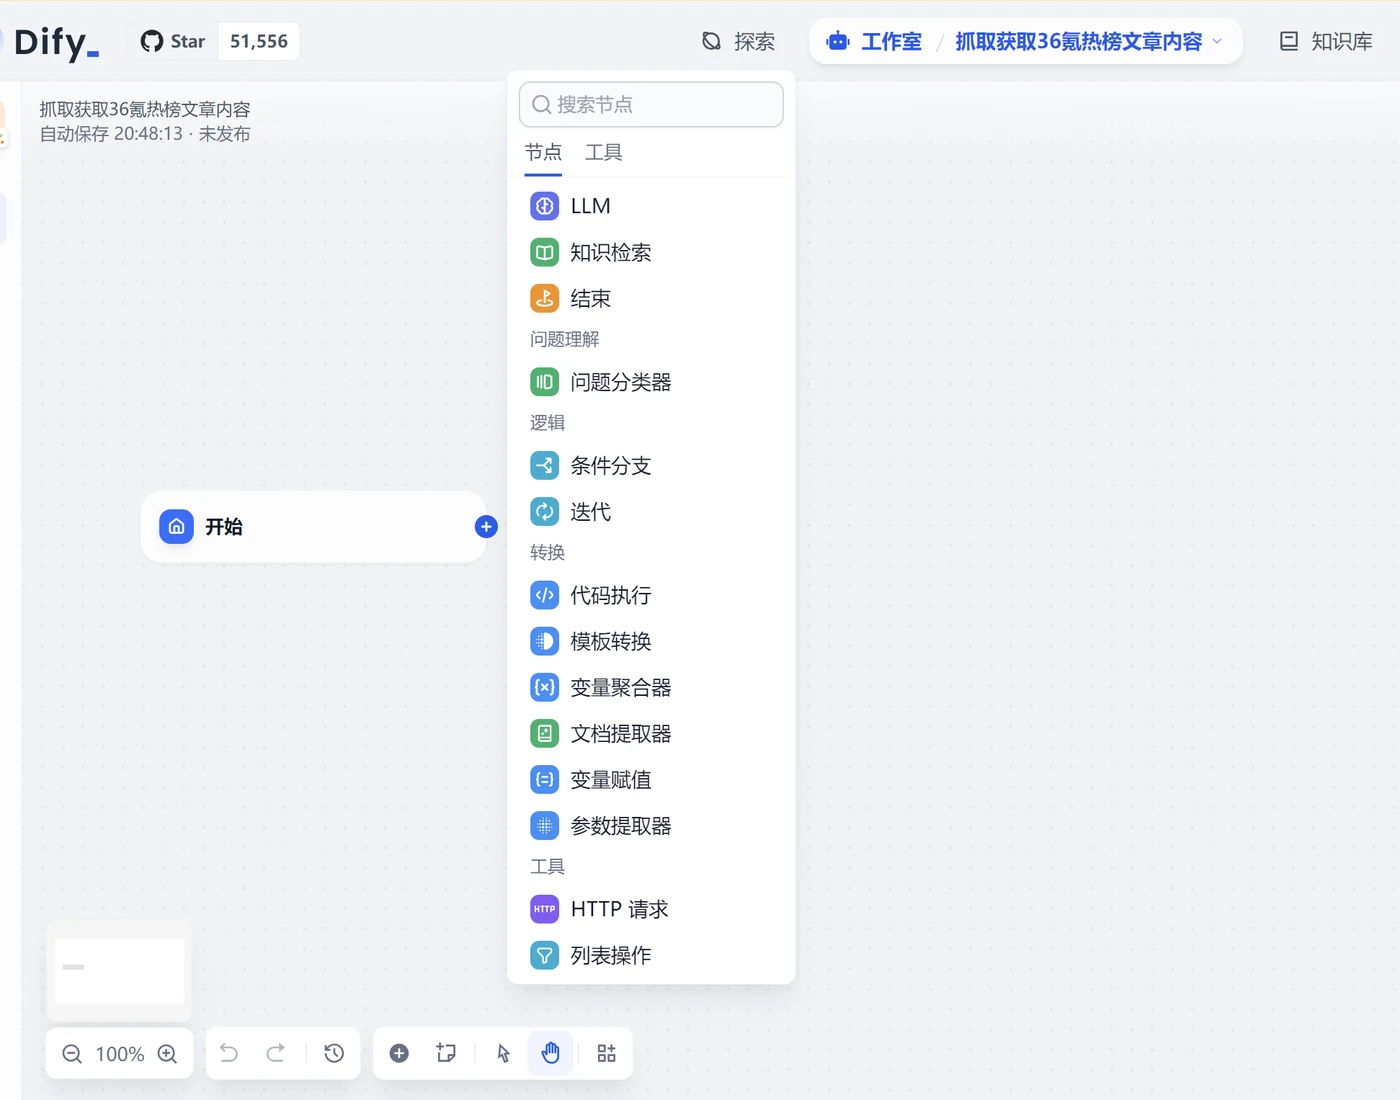
进入画布界面如上图,给开始节点增加http请求节点
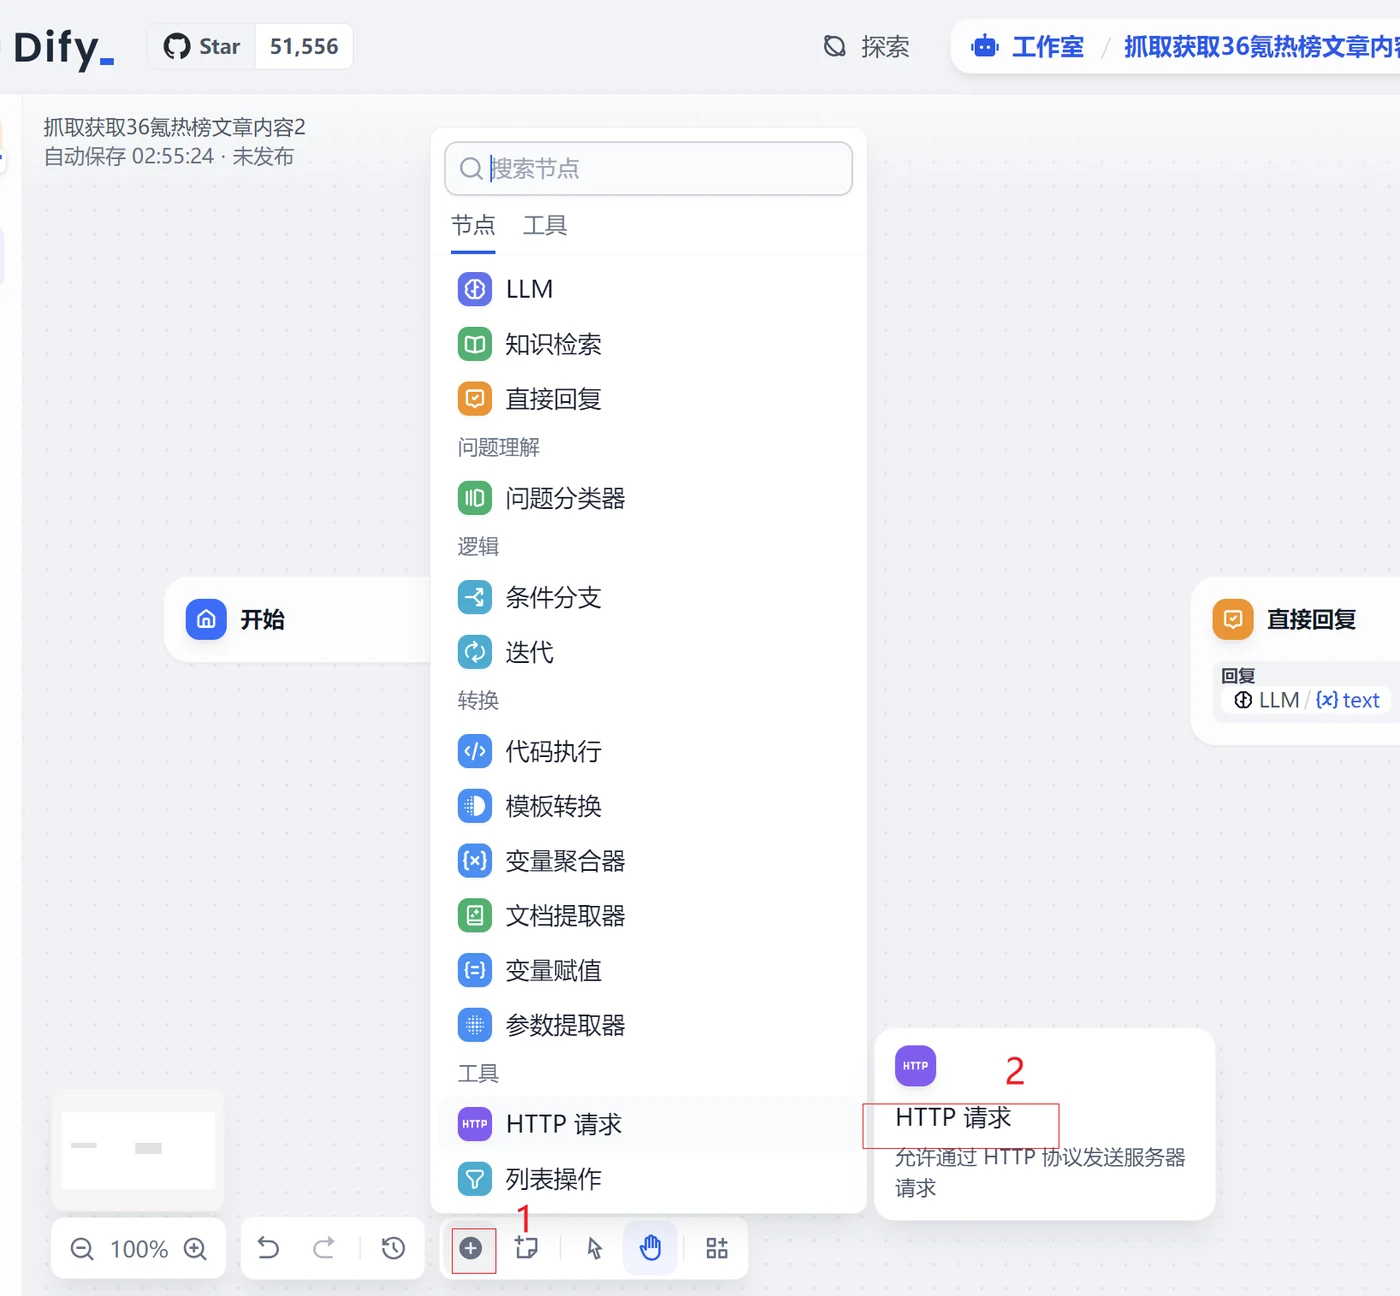
2.http请求
将开始节点和这个http请求节点连接上,点击http 请求,输入我们需要获取36氪热榜文章api接口。
我们这里用到了别人第三方接口(韩小韩webapi接口,感谢作者提供免费的api省的我们在去爬取新闻了),接口地址https://api.vvhan.com/article/36Ke.html
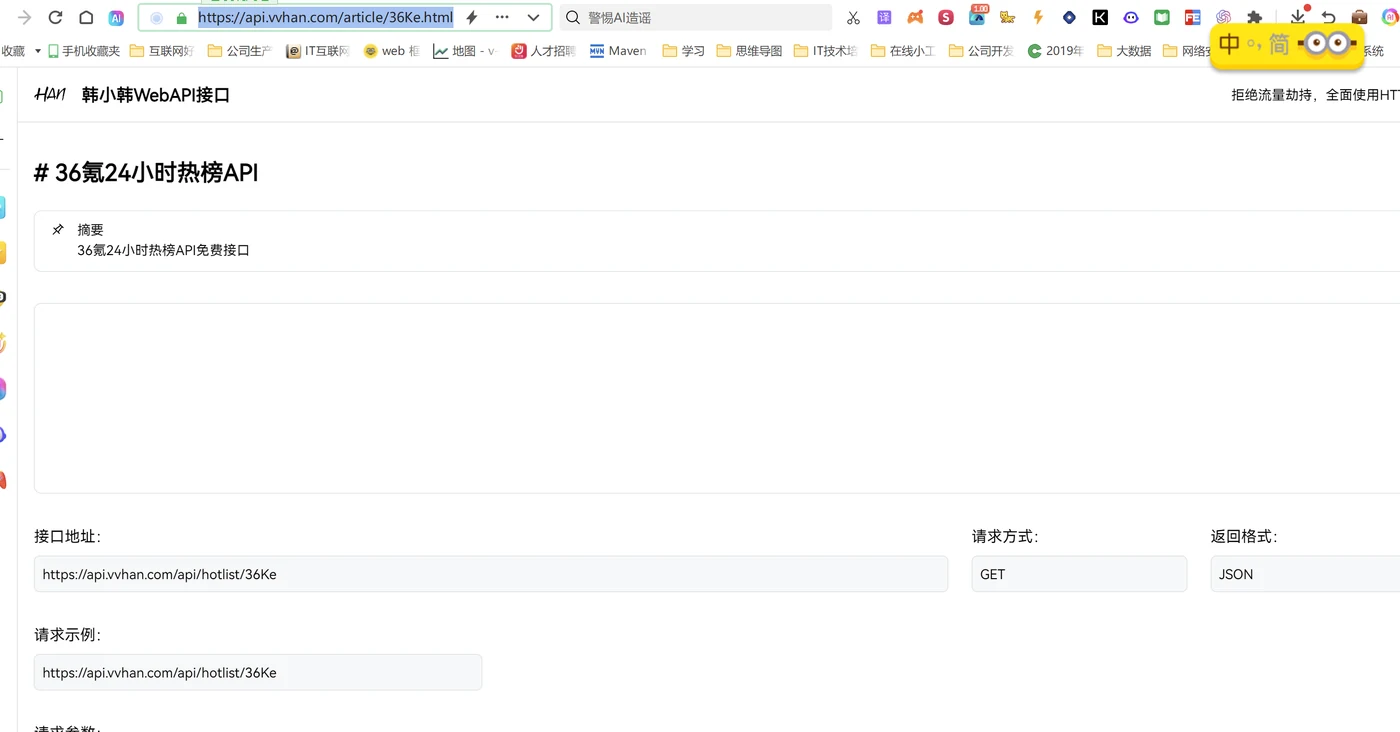
将接口地址:https://api.vvhan.com/api/hotlist/36Ke 复制到 http请求地址上
因为这个http请求接口是get 请求,其他参数都不需要输入,所以以上步骤参考我图上设置即可。
这里我们也用到dify http请求这个组件了。关于他的使用其实也非常简单,会开发小伙伴 使用postman调试接口开发工具应该都会使用,这里我就不详细展开了。
3.llm(文本类大语言模型)
接下来我们将http请求连接到一个大语言模型,这里我们使用的是deepseek-ai/DeepSeek-V2.5模型。
模型里面的系统提示词输入如下内容:
```xml
<instruction>
  <instructions>
    1. 抓取了360氪新闻榜单 json :{{#1726306543949.body#}}
    2. 只生成榜单前面 3 条数据
    3. 生成如下结构的内容:
      [{
        "title": "新闻标题",
        "url": "新闻链接"
      }]
    4.输出不要添加```json 包裹
  </instructions>
  <examples>
    <example>
      <output>
        [
          {"title": "8点1氪|个人购房不超140平契税降至1%;特斯拉10万员工薪酬数据曝光;校园招聘严禁限定985和211高校","url":"https://36kr.com/p/3035465134387461"},
            {"title": "避免内耗,吉利将整合极氪和领克两大品牌|36氪独家","url":"https://36kr.com/p/3034230633984003"},
 {"title": "Transformer打破三十年数学猜想,Meta研究者用AI给出反例,算法杀手攻克数学难题|36氪独家","url":"https://36kr.com/p/3034698843615238"},
        ]
      </output>
    </example>
 <examples>
这里主要是让大语言模型在获取上一个节点http请求返回的body值的地方做一下数据提取。其中 1、2、3、4 都是我们需要模型提取的关键点要素。因为我们这里是先获取新闻标题和新闻链接 其他的内容我们是不需要的,所以我们把生成要点告诉大语言模型。下面example是告诉模型输出的内容格式。
我们使用原始的https://api.vvhan.com/api/hotlist/36Ke 接口获取的内容如下:
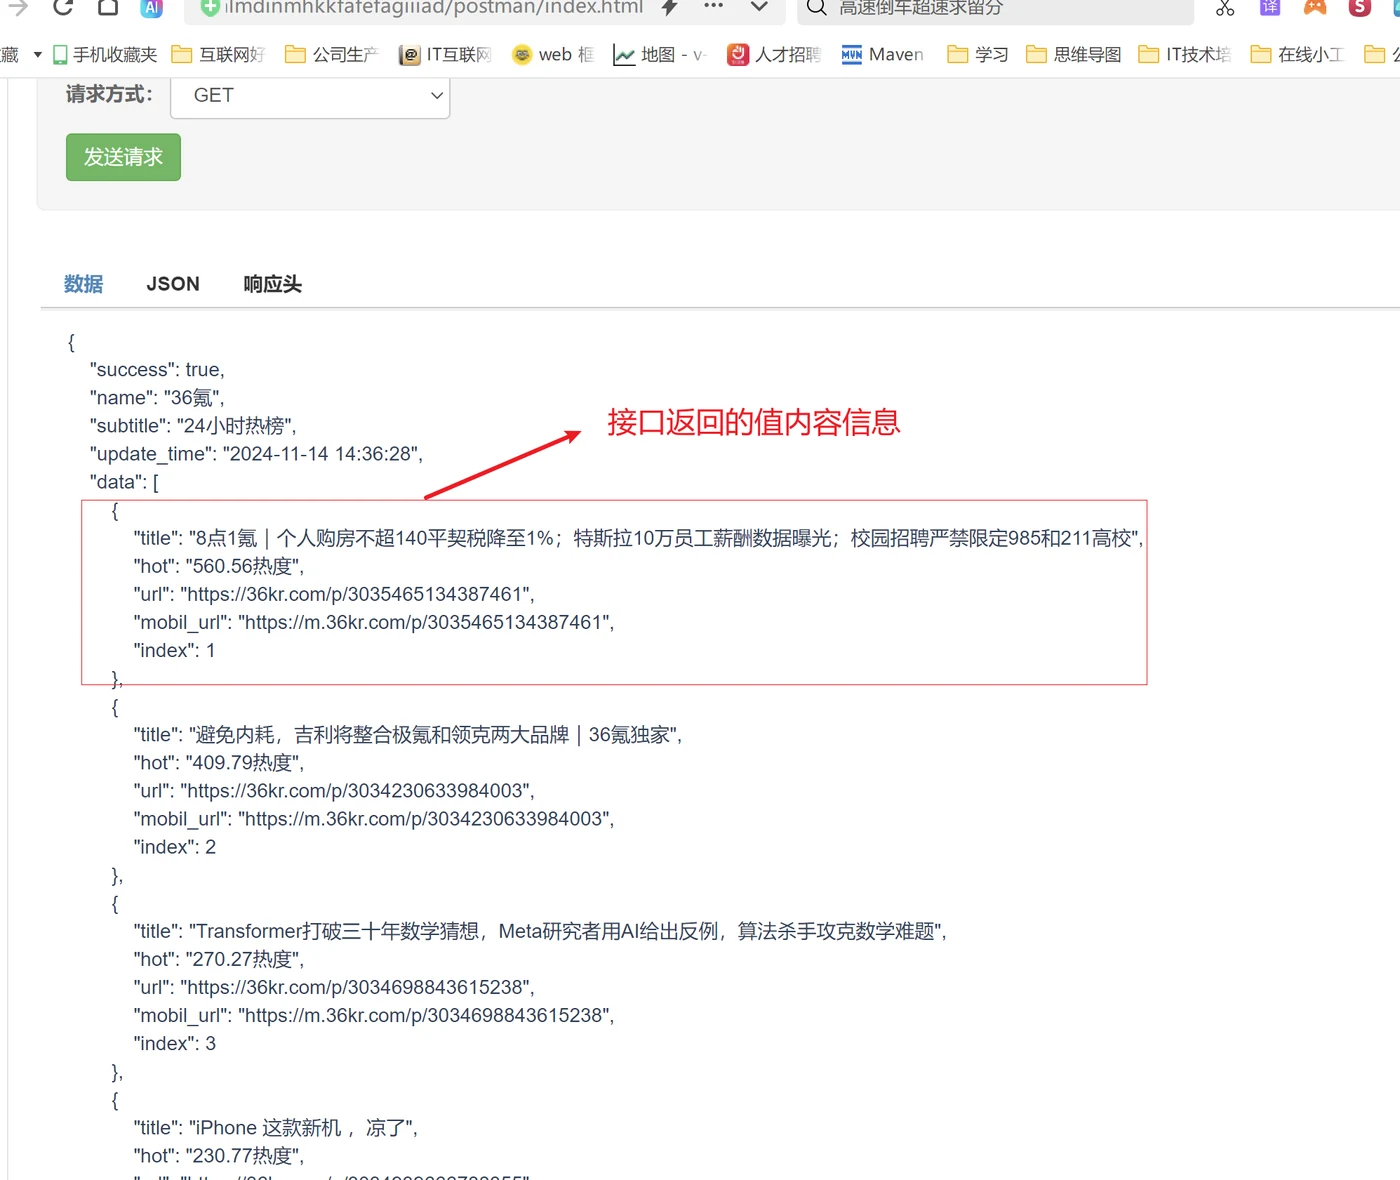
上面的节点我们只用到2个(title 、url),其他我们目前不需要就忽略掉他。llm(文本类大语言模型) 系统提示词配置如下
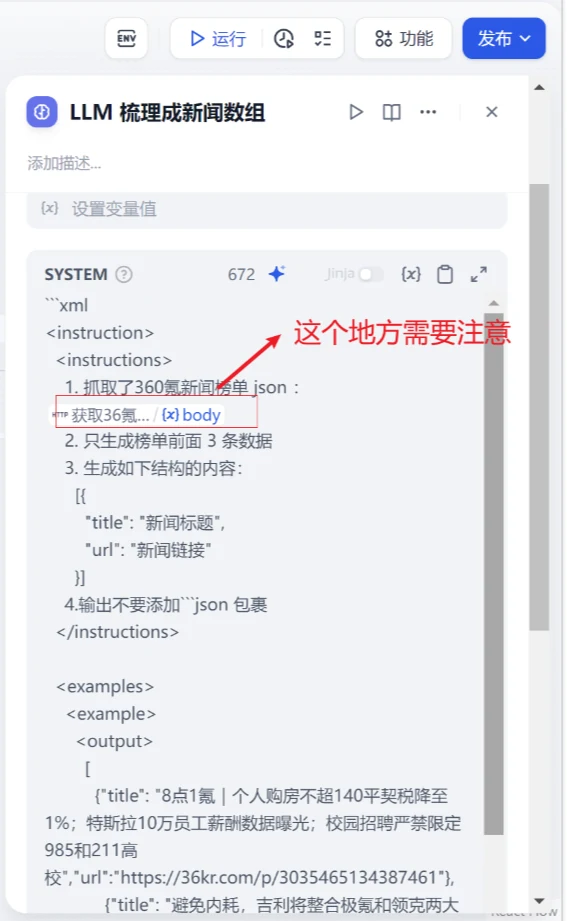
这里我们需要注意{X}body是从上一个http 请求的内容body部分的数据,不能写死了。
4 .转换
接下来我们需要对llm大语言模型输出的结果进行转换,转换的目的是把上个节点输出的内容转换成json格式数据。我们拖拽一个代码执行