
基于QLoRA微调LLaMA
《基于QLoRA微调LLaMA》共 0.3 万字,通篇围绕 微调、QLoRA、量化、LoRA 展开,归在「训练、微调与数据」这一层。
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(4 节)
- 示例代码
- 微调过程
- QLoRA 的局限性
- 参考资料
示例代码
📎 附件:qlora-llama.zip(zip, 9KB)
原文链接:https://www.yuque.com/attachments/yuque/0/2025/zip/2424104/1747014138764-7b76f13f-3ba2-47b6-b1ef-96d2a1381bf1.zip
前言
QLoRA 是一种高效的微调方法,通过将梯度反向传播到低阶适配器 (LoRA) 中,以显著减少内存使用量。它可以在单个 48GB GPU 上微调 650 亿个参数的模型,并且能够保持完整的 16 位微调任务性能。
同时还推出了一个名为 Guanaco 的新模型家族,它在 Vicuna 基准上表现出色,达到了 ChatGPT 性能水平的 99.3%。令人惊喜的是,只需要在单个 GPU 上进行 24 小时的微调,就能够取得如此优异的结果。这些创新使得在资源有限的情况下,能够以更高效的方式进行模型微调,并取得了非常令人满意的成果。
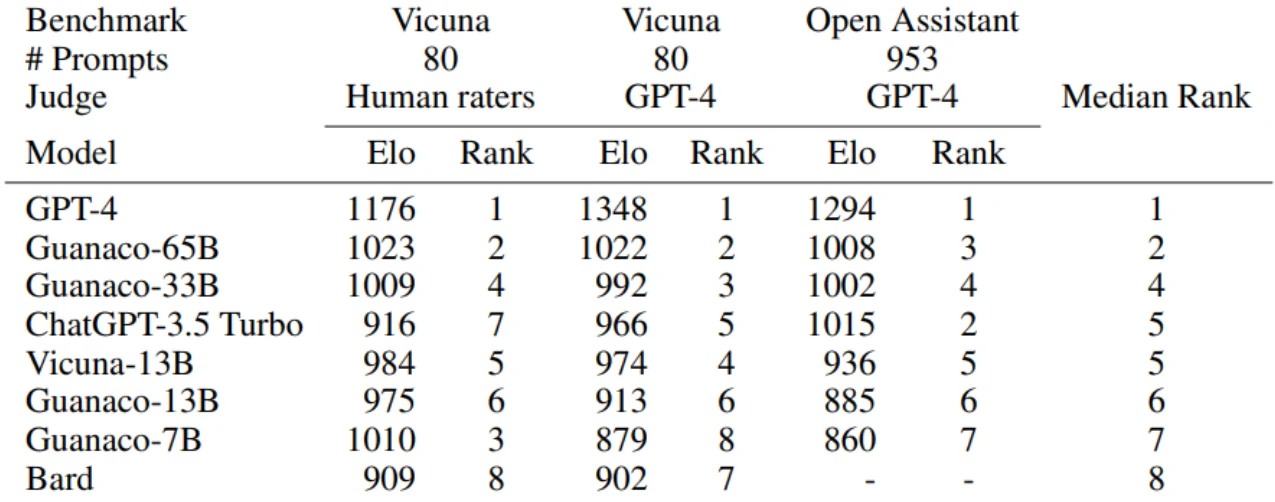
QLoRA 是一种创新的微调 LLM 方法,经过多项任务验证,包括文本分类、问题回答和自然语言生成等,证明了其在各个领域的有效性。这一方法的出现为更广泛的用户和应用程序提供了更便捷的 LLM 应用方式,并有望进一步推动 LLM 在不同领域的应用。
接下来我们将介绍如何在单个 Google Colab 上微调最新的 Llama-2-7b 模型并将其转变为聊天机器人。我们将利用 Hugging Face 生态系统中的 PEFT 库以及 QLoRA 来实现更高效的内存微调。
LoRA(低秩适配器)和 QLoRA(量化 LoRA)都是微调大型语言模型并减少内存需求的方法。然而,QLoRA 引入了多项创新,以在保持性能的同时进一步减少内存使用。以下是两种方法的比较:
LoRA:
- - 使用一小组可训练参数(适配器),同时保持完整模型参数固定。
- - 随机梯度下降期间的梯度通过固定的预训练模型权重传递到适配器,适配器被更新以优化损失函数。
- - 与完全微调相比,内存效率更高,但仍需要 16 位精度进行训练。
QLoRA:
- - 通过冻结的 4 位量化预训练语言模型将梯度反向传播到低阶适配器 (LoRA) 中。
- - 引入 4 位 NormalFloat (NF4),这是一种适用于正态分布数据的信息理论上最佳量化数据类型,可产生比 4 位整数和 4 位浮点更好的经验结果。
- - 应用双量化,一种对量化常数进行量化的方法,每个参数平均节省约 0.37 位。
- - 使用具有 NVIDIA 统一内存的分页优化器,以避免在处理具有长序列长度的小批量时在梯度检查点期间出现内存峰值。
- - 显着降低内存需求,与 16 位完全微调基准相比,允许在单个 48GB GPU 上微调 65B 参数模型,而不会降低运行时间或预测性能。
总之,QLoRA 建立在传统 LoRA 的基础上,引入了 4 位量化、4 位 NormalFloat 数据类型、双量化和分页优化器,以进一步减少内存使用,同时保持与 16 位微调方法相当的性能。
微调过程
1、PEFT 或参数高效微调
PEFT(即参数高效微调)是 Hugging Face 的一个新开源库,可将预训练语言模型 (PLM) 高效地适应各种下游应用程序,而无需微调所有模型参数。 PEFT 目前包括以下技术:
- LoRA:大语言模型的低阶自适应 [8]
- 前缀调优:P-Tuning v2:快速调优可与跨尺度和任务的通用微调相媲美
- P-Tuning:GPT 也能理解 [9]
- 即时调优:规模的力量可实现参数高效的即时调优 [10]
2、设置开发环境
首先需要安装必要的依赖,我们将需要安装 accelerate 、 peft 、 transformers 、 datasets 和 TRL 库,以利用最新的 SFTTrainer 。通过使用 bitsandbytes 将基本模型量化为 4 位。同时还将安装 einops ,因为它是加载 Falcon 模型所必须的库。
pip install trl transformers accelerate git+https://github.com/huggingface/peft.git
pip install datasets bitsandbytes einops wandb
3、准备数据集
我们将从 AlexanderDoria/novel17_test 数据集中加载了 train 数据集分割。该数据集包含了一些法语小说的文本数据,用于进行自然语言处理任务的训练和评估。该数据集中的文本将被用于训练模型,以便让模型能够对法语小说进行自然语言处理。
from datasets import load_dataset

#dataset_name = "timdettmers/openassistant-guanaco" ###Human ,.,,,,,, ###Assistant

dataset_name = 'AlexanderDoria/novel17_test' #french novels
dataset = load_dataset(dataset_name, split="train")