
QLoRA量化微调快速入门
《QLoRA量化微调快速入门》共 0.3 万字,通篇围绕 QLoRA、微调、量化、GPU 展开,归在「训练、微调与数据」这一层。
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(7 节)
- 示例代码
- 一、前言
- 二、QLoRA 介绍
- 三、QLoRA 微调要求
- 四、QLoRA 演示
- 五、QLoRA 安装
- 六、QLoRA 入门
示例代码
📎 附件:qlora-quick.zip(zip, 20KB)
原文链接:https://www.yuque.com/attachments/yuque/0/2025/zip/2424104/1747014138672-3166849b-ff10-4fbe-9d68-9ae216a5a346.zip
一、前言
在大型语言模型(LLM)领域,微调是提高性能和调整行为的关键过程。然而,由于内存需求巨大,对于大型模型进行微调可能非常昂贵。最近,华盛顿大学发表了一项关于解决这一问题的创新方案——QLoRA(Quantized Low-Rank Adapter)。
QLoRA 是一种新的微调大型语言模型(LLM)的方法,它能够在节省内存的同时保持速度。其工作原理是首先将 LLM 进行 4 位量化,从而显著减少模型的内存占用。接着,使用低阶适配器(LoRA)方法对量化的 LLM 进行微调。LoRA 使得改进后的模型能够保留原始 LLM 的大部分准确性,同时具有更小的体积和更快的速度。
以上是对 QLoRA 的简要介绍,下面将进一步探讨其原理和应用。
二、QLoRA 介绍
QLoRA 是一种高效的微调方法,通过将梯度反向传播到低阶适配器 (LoRA) 中,以显著减少内存使用量。它可以在单个 48GB GPU 上微调 650 亿个参数的模型,并且能够保持完整的 16 位微调任务性能。
同时还推出了一个名为 Guanaco 的新模型家族,它在 Vicuna 基准上表现出色,达到了 ChatGPT 性能水平的 99.3%。令人惊喜的是,只需要在单个 GPU 上进行 24 小时的微调,就能够取得如此优异的结果。这些创新使得在资源有限的情况下,能够以更高效的方式进行模型微调,并取得了非常令人满意的成果。
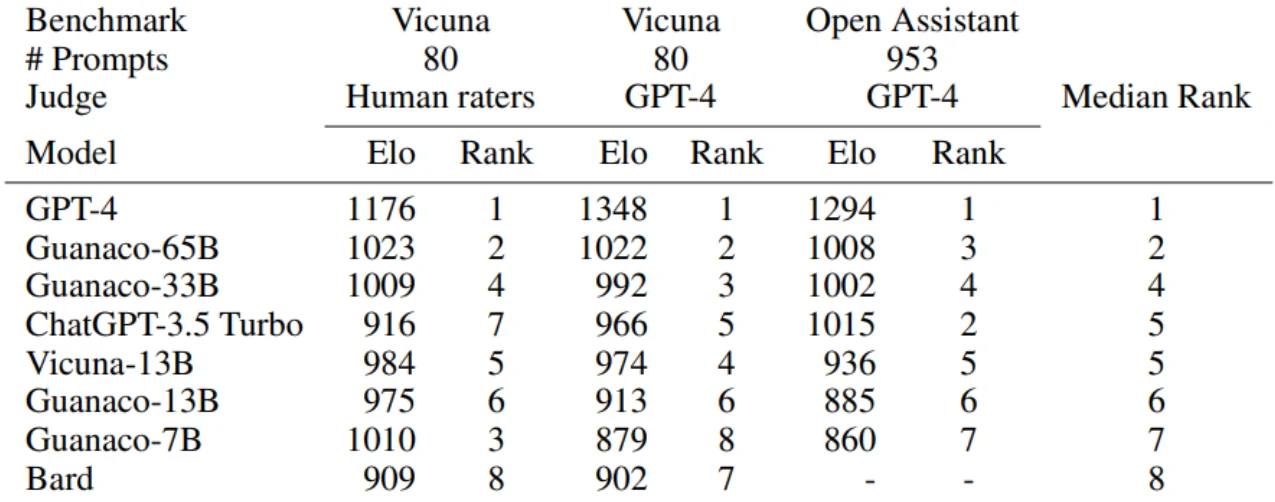
QLoRA 是一种创新的微调 LLM 方法,经过多项任务验证,包括文本分类、问题回答和自然语言生成等,证明了其在各个领域的有效性。这一方法的出现为更广泛的用户和应用程序提供了更便捷的 LLM 应用方式,并有望进一步推动 LLM 在不同领域的应用。
2.1、关键创新
LoRA(低秩适配器)和 QLoRA(量化 LoRA)都是微调大型语言模型并减少内存需求的方法。然而,QLoRA 引入了多项创新,以在保持性能的同时进一步减少内存使用。以下是两种方法的比较:
LoRA:
- - 使用一小组可训练参数(适配器),同时保持完整模型参数固定。
- - 随机梯度下降期间的梯度通过固定的预训练模型权重传递到适配器,适配器被更新以优化损失函数。
- - 与完全微调相比,内存效率更高,但仍需要 16 位精度进行训练。
QLoRA:
- - 通过冻结的 4 位量化预训练语言模型将梯度反向传播到低阶适配器 (LoRA) 中。
- - 引入 4 位 NormalFloat (NF4),这是一种适用于正态分布数据的信息理论上最佳量化数据类型,可产生比 4 位整数和 4 位浮点更好的经验结果。
- - 应用双量化,一种对量化常数进行量化的方法,每个参数平均节省约 0.37 位。
- - 使用具有 NVIDIA 统一内存的分页优化器,以避免在处理具有长序列长度的小批量时在梯度检查点期间出现内存峰值。
- - 显着降低内存需求,与 16 位完全微调基准相比,允许在单个 48GB GPU 上微调 65B 参数模型,而不会降低运行时间或预测性能。
总之,QLoRA 建立在传统 LoRA 的基础上,引入了 4 位量化、4 位 NormalFloat 数据类型、双量化和分页优化器,以进一步减少内存使用,同时保持与 16 位微调方法相当的性能。
2.2 性能分析
通过对模型规模和聊天机器人性能进行深入研究,发现了一些有趣的结果。由于内存开销的限制,常规微调方法无法使用。因此,采用了一种特殊的指令微调方法,在多个数据集、不同的模型架构和参数数量范围内进行了训练,总共训练了 1000 多个模型。
结果显示,即使使用比之前最先进的模型更小的模型,通过 QLoRA 对小型高质量数据集进行微调,也能够获得最先进的结果。这表明,数据质量对于模型性能的影响远远大于数据集的大小。这一发现对于优化聊天机器人的性能具有重要的指导意义。
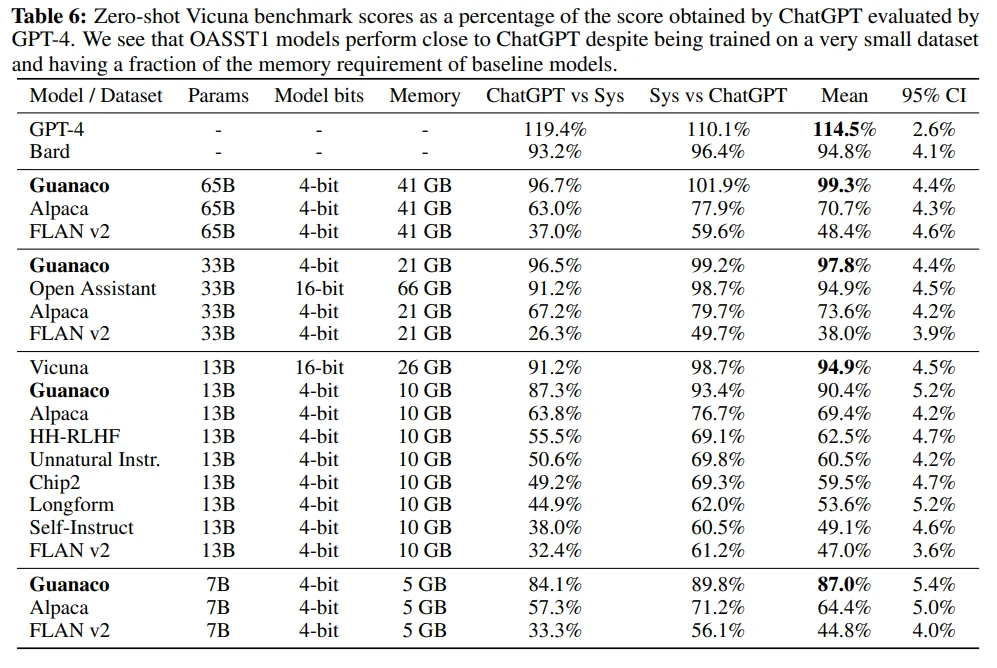
通过对 Guanaco 65B 模型进行了评估,该模型使用 QLORA 对 OASST1 的变体进行了微调。结果表明,它是性能最佳的开源聊天机器人模型,其性能可与 ChatGPT 相媲美。与 GPT-4 相比,Guanaco 65B 和 33B 的预期获胜概率为 30%。
- 在 Vicuna 基准测试中,Guanaco 65B 在 GPT-4 之后表现最好,相对于 ChatGPT 达到了 99.3% 的性能。尽管参数较多,但由于权重仅使用 4 位精度,Guanaco 33B 模型的内存效率比 Vicuna 13B 模型更高。此外,Guanaco 7B 可以安装在现代手机上,同时得分比 Alpaca 13B 高出近 20 个百分点。
- 尽管结果令人印象深刻,但许多模型的性能重叠,置信区间范围很广。作者将这种不确定性归因于缺乏明确的规模规范。为了解决这个问题,他们建议使用 Elo 排名方法,该方法基于人类注释者和 GPT-4 的成对判断。
- Elo 排名表明,Guanaco 33B 和 65B 模型在 Vicuna 和 OA 基准测试中的表现优于除 GPT-4 之外的所有模型,并且与 ChatGPT 的表现相当。然而,微调数据集的选择极大地影响了性能,表明数据集适用性的重要性。