
模型架构与原理1300 字
Transformers执行分类推理任务
·全库 326 / 611
《Transformers执行分类推理任务》共 0.1 万字,通篇围绕 推理、CUDA、上下文、GPU 展开,归在「模型架构与原理」这一层。
覆盖推理CUDA上下文GPU
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 一、Transformers 分类推理过程
- 二、查看 PipeLine 支持的任务类型
- 三、Pipeline 的创建和使用
- 四、Pipeline的背后实现
- 3.1 根据任务类型,直接创建 Pipeline,默认是英文模型
- 3.2 指定任务类型,再指定模型,创建基于指定模型的 Pipeline
- 3.3 预先加载模型,再创建 Pipeline
- 3.4 使用 Gpu 进行推理
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.12.4
一、Transformers 分类推理过程
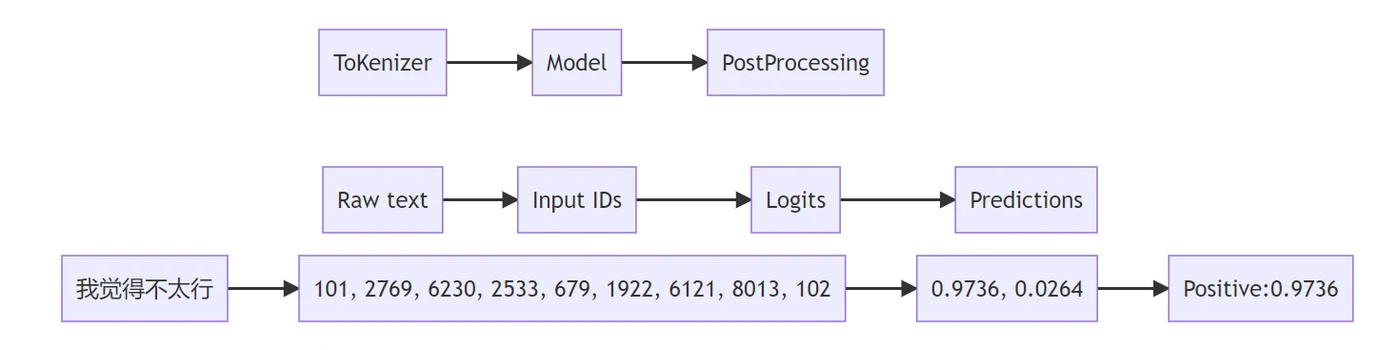
- 将数据预处理、模型调用、结果后处理三部分组装成的流水线,如下流程图
- 使我们能够直接输入文本便获得最终的答案,不需要我们关注细节
二、查看 PipeLine 支持的任务类型
from transformers.pipelines import SUPPORTED_TASKS
from pprint import pprint
for k, v in SUPPORTED_TASKS.items():
    print(k, v)
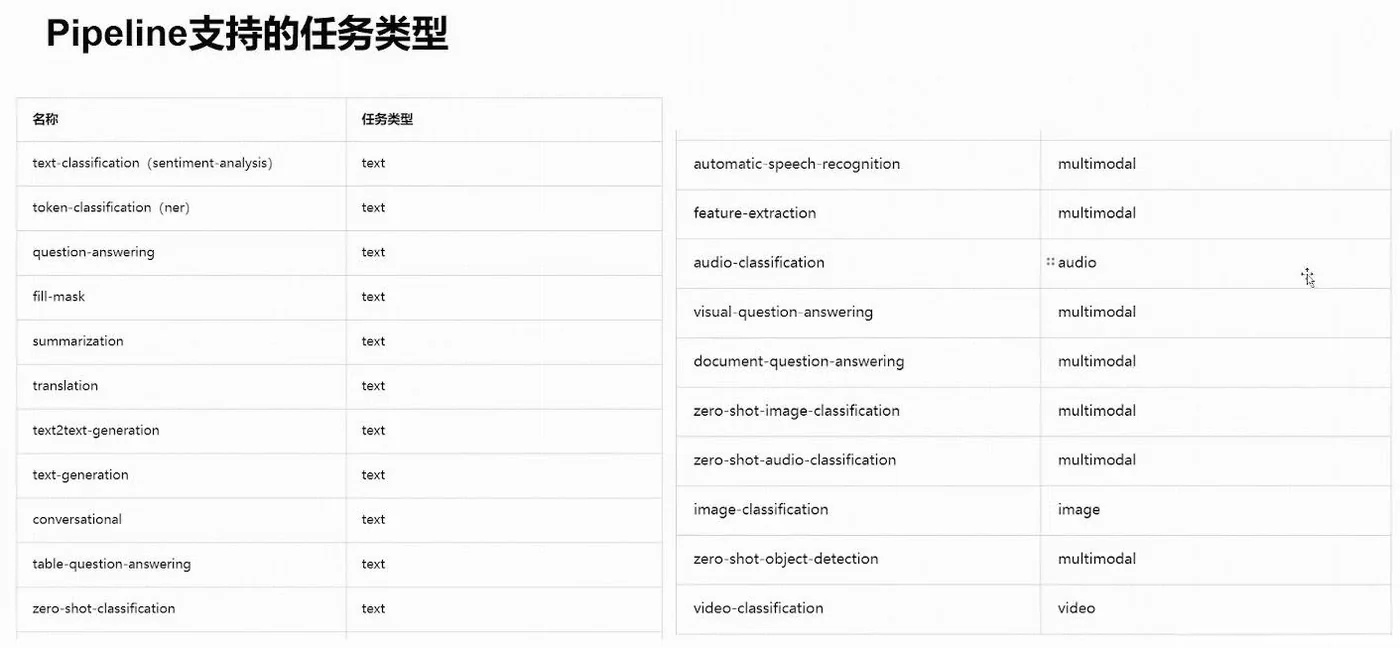
输出但其概念 PipeLine 支持的任务类型以及可以调用的举例输出:
audio-classification {'impl': <class 'transformers.pipelines.audio_classification.AudioClassificationPipeline'>, 'tf': (), 'pt': (<class 'transformers.models.auto.modeling_auto.AutoModelForAudioClassification'>,), 'default': {'model': {'pt': ('superb/wav2vec2-base-superb-ks', '372e048')}}, 'type': 'audio'}
automatic-speech-recognition
text-to-audio
feature-extraction
text-classification- key: 任务的名称,如音频分类
- v:关于任务的实现,如具体哪个 Pipeline,有没有 TF 模型,有没有 pytorch 模型, 模型具体是哪一个
三、Pipeline 的创建和使用
3.1 根据任务类型,直接创建 Pipeline,默认是英文模型
from transformers import pipeline
pipe = pipeline("text-classification") # 根据pipeline直接创建一个任务类
pipe("very good") # 测试一个句子,输出结果
3.2 指定任务类型,再指定模型,创建基于指定模型的 Pipeline
注,这里我已经将模型离线下载到本地了
# https://huggingface.co/models
pipe = pipeline("text-classification", model="./models/roberta-base-finetuned-dianping-chinese")
3.3 预先加载模型,再创建 Pipeline
rom transformers import AutoModelForSequenceClassification, AutoTokenizer

# 这种方式,必须同时指定model和tokenizer
model = AutoModelForSequenceClassification.from_pretrained("./models_roberta-base-finetuned-dianping-chinese")
tokenizer = AutoTokenizer.from_pretrained("./models_roberta-base-finetuned-dianping-chinese")
pipe = pipeline("text-classification", model=model, tokenizer=tokenizer)
3.4 使用 Gpu 进行推理
pipe = pipeline("text-classification", model="./models_roberta-base-finetuned-dianping-chinese", device=0)3.5 查看 Device
pipe.model.device3.6 测试一下耗时
import torch
import time
times = []
for i in range(100):
    torch.cuda.synchronize()
    start = time.time()
    pipe("我觉得不太行!")
    torch.cuda.synchronize()
    end = time.time()
    times.append(end - start)
print(sum(times) / 100)