
框架与工具链2760 字
LangChain自定义会话管理和Retriever
·全库 340 / 611
《LangChain自定义会话管理和Retriever》共 0.3 万字,通篇围绕 检索、LangChain、提示词、上下文 展开,归在「框架与工具链」这一层。
覆盖检索LangChain提示词上下文向量prompt
适合要选技术栈、不想把别人踩过的坑重踩一遍的人
目录骨架(2 节)
- 如何自定义会话管理
- 如何创建自定义Retriever
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.12.4
如何自定义会话管理
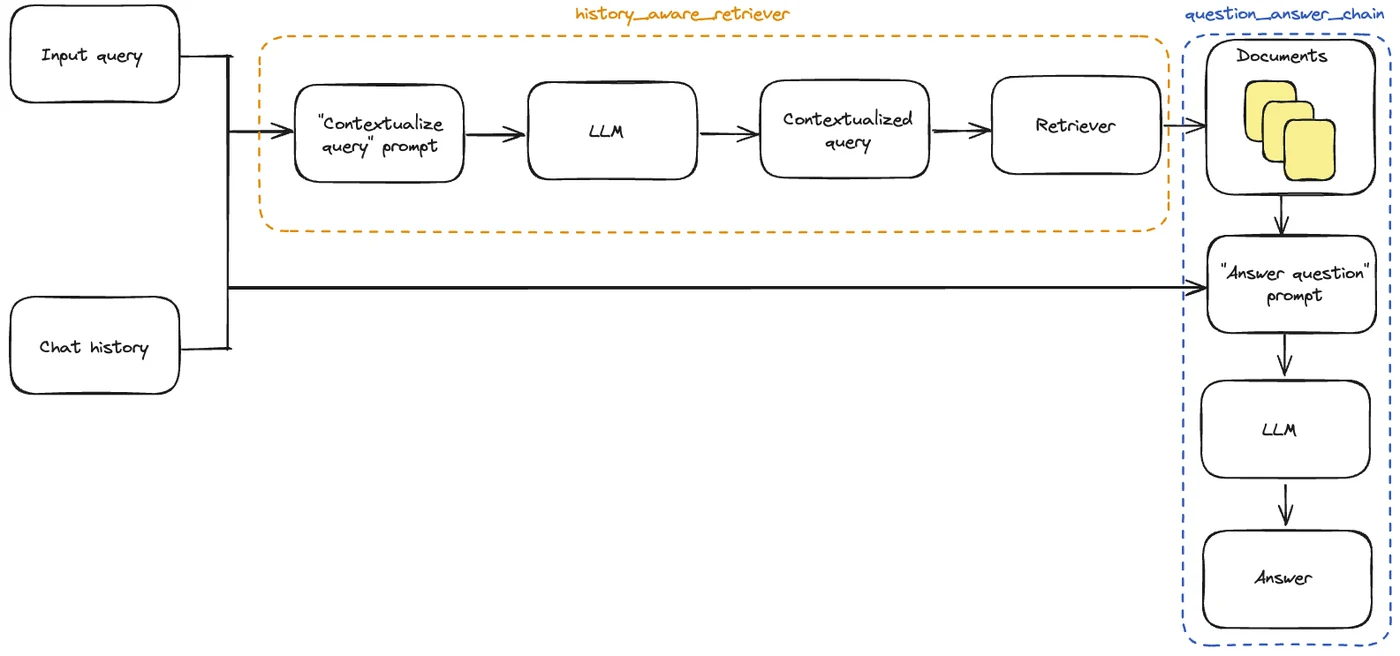
之前我们已经介绍了如何添加会话历史记录,但我们仍在手动更新对话历史并将其插入到每个输入中。在真正的问答应用程序中,我们希望有一种持久化对话历史的方式,并且有一种自动插入和更新它的方式。 为此,我们可以使用:
- BaseChatMessageHistory: 存储对话历史。
- RunnableWithMessageHistory: LCEL 链和 BaseChatMessageHistory 的包装器,负责将对话历史注入输入并在每次调用后更新它。 要详细了解如何将这些类结合在一起创建有状态的对话链,请转到 如何添加消息历史(内存) LCEL 页面。 下面,我们实现了第二种选项的一个简单示例,其中对话历史存储在一个简单的字典中。 RunnableWithMessageHistory 的实例会为您管理对话历史。它们接受一个带有键(默认为 "session_id")的配置,该键指定要获取和预置到输入中的对话历史,并将输出附加到相同的对话历史。以下是一个示例:
#示例:custom_chat_session.py
# pip install --upgrade langchain langchain-community langchainhub langchain-chroma bs4
import bs4
from langchain_chroma import Chroma
from langchain_community.document_loaders import WebBaseLoader
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.prompts import MessagesPlaceholder
from langchain_openai import ChatOpenAI
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_core.messages import AIMessage, HumanMessage
from langchain.globals import set_debug
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_community.chat_message_histories import ChatMessageHistory
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain.chains import create_history_aware_retriever
from langchain.chains import create_retrieval_chain

# 打印调试日志
set_debug(False)

# 创建一个 WebBaseLoader 对象,用于从指定网址加载文档
loader = WebBaseLoader(
    web_paths=("https://lilianweng.github.io/posts/2023-06-23-agent/",),
    bs_kwargs=dict(
        parse_only=bs4.SoupStrainer(
            class_=("post-content", "post-title", "post-header")
        )
    ),
)
# 加载文档
docs = loader.load()
# 创建一个 RecursiveCharacterTextSplitter 对象,用于将文档拆分成较小的文本块
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
# 将文档拆分成文本块
splits = text_splitter.split_documents(docs)
# 创建一个 Chroma 对象,用于存储文本块的向量表示
vectorstore = Chroma.from_documents(documents=splits, embedding=OpenAIEmbeddings())
# 将向量存储转换为检索器
retriever = vectorstore.as_retriever()