
LangChain高效检索器最佳实践
《LangChain高效检索器最佳实践》共 0.7 万字,通篇围绕 向量、LangChain、数据库、检索 展开,归在「RAG 与知识库」这一层。
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(8 节)
- 分享内容
- 相似性搜索 (Similarity Search)
- Pinecone
- K-Means
- Hierarchical Navigable Small Worlds (HNSW)
- Faiss介绍
- 作为检索器
- 带分数的相似度搜索
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.12.4
分享内容
- 相似性搜索底层原理
- FAISS相似度匹配
- Pinecone索引检索
- Lance向量持久化存储
- 总结
相似性搜索 (Similarity Search)
既然我们知道了可以通过比较向量之间的距离来判断它们的相似度,那么如何将它应用到真实的场景中呢?如果想要在一个海量的数据中找到和某个向量最相似的向量,我们需要对数据库中的每个向量进行一次比较计算,但这样的计算量是非常巨大的,所以我们需要一种高效的算法来解决这个问题。
高效的搜索算法有很多,其主要思想是通过两种方式提高搜索效率:
1)减少向量大小——通过降维或减少表示向量值的长度。
2)缩小搜索范围——可以通过聚类或将向量组织成基于树形、图形结构来实现,并限制搜索范围仅在最接近的簇中进行,或者通过最相似的分支进行过滤。
我们首先来介绍一下大部分算法共有的核心概念,也就是聚类。
K-Means
我们可以在保存向量数据后,先对向量数据先进行聚类。例如下图在二维坐标系中,划定了 4 个聚类中心,然后将每个向量分配到最近的聚类中心,经过聚类算法不断调整聚类中心位置,这样就可以将向量数据分成 4 个簇。每次搜索时,只需要先判断搜索向量属于哪个簇,然后再在这一个簇中进行搜索,这样就从 4 个簇的搜索范围减少到了 1 个簇,大大减少了搜索的范围。
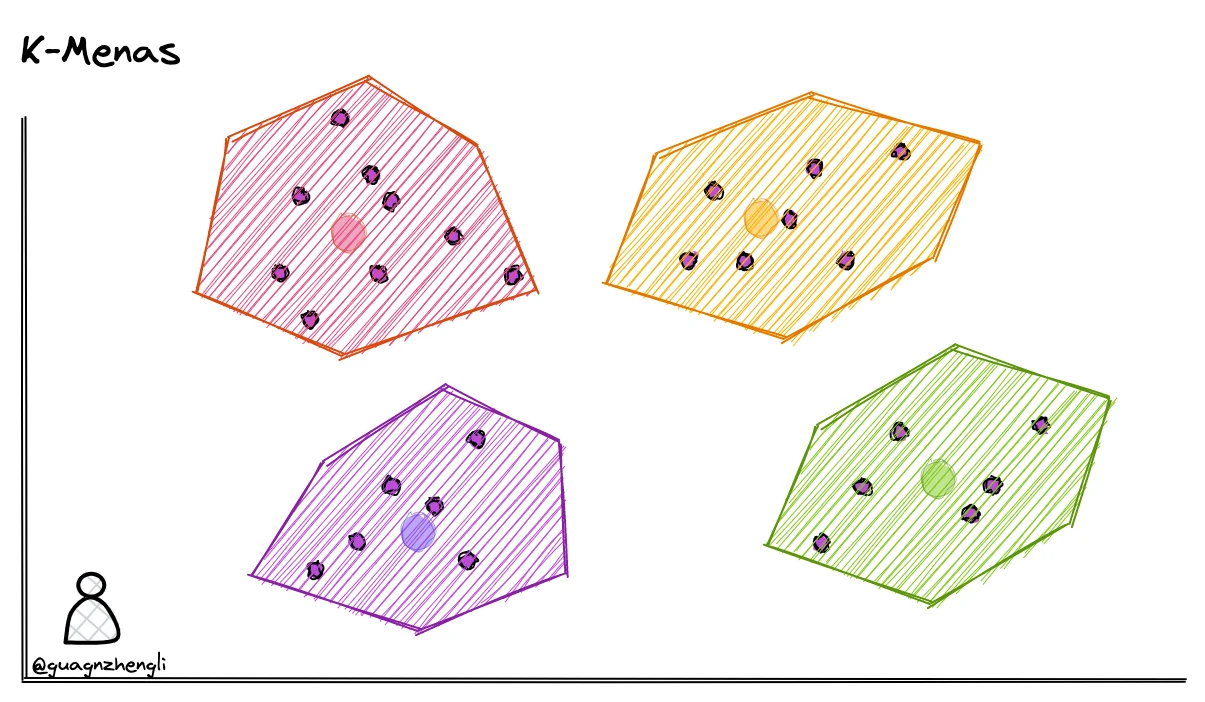
工作原理
- 初始化:选择 个随机点作为初始聚类中心。
- 分配:将每个向量分配给离它最近的聚类中心,形成 个簇。
- 更新:重新计算每个簇的聚类中心,即簇内所有向量的平均值。
- 迭代:重复“分配”和“更新”步骤,直到聚类中心不再变化或达到最大迭代次数。
举例说明
假设我们有一组二维向量(点),例如:,我们希望将它们聚成四个簇()。
- 初始化:随机选择四个点作为初始聚类中心,比如 、、 和 。
- 分配:计算每个点到四个聚类中心的距离,将每个点分配给最近的聚类中心。
形成四个簇:,,,。
- 点 更接近 。
- 点 更接近 。
- 点 更接近 。
- 点 更接近 。
- 点 更接近 。
- 更新:计算每个簇的新聚类中心。
- 第一个簇的聚类中心是 。
- 第二个簇的聚类中心是 。
- 第三个簇的新聚类中心是 。
- 第四个簇的聚类中心是 。
- 迭代:重复分配和更新步骤,直到聚类中心不再变化。
优点:通过将向量聚类,我们可以在进行相似性搜索时只需计算查询向量与每个聚类中心之间的距离,而不是与所有向量计算距离。这大大减少了计算量,提高了搜索效率。这种方法在处理大规模数据时尤其有效,可以显著加快搜索速度。
缺点,例如在搜索的时候,如果搜索的内容正好处于两个分类区域的中间,就很有可能遗漏掉最相似的向量。
Hierarchical Navigable Small Worlds (HNSW)
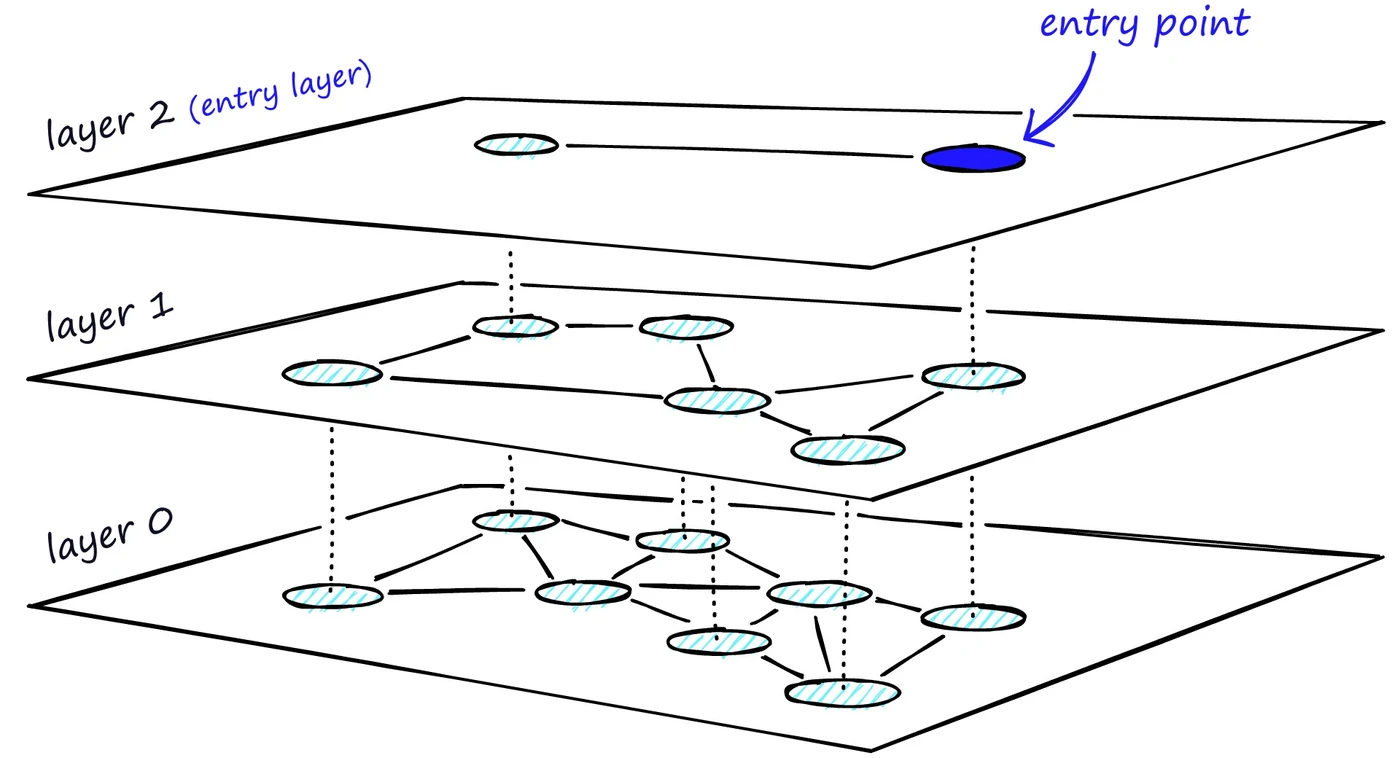
除了聚类以外,也可以通过构建树或者构建图的方式来实现近似最近邻搜索。这种方法的基本思想是每次将向量加到数据库中的时候,就先找到与它最相邻的向量,然后将它们连接起来,这样就构成了一个图。当需要搜索的时候,就可以从图中的某个节点开始,不断的进行最相邻搜索和最短路径计算,直到找到最相似的向量。
这种算法能保证搜索的质量,但是如果图中所以的节点都以最短的路径相连,如图中最下面的一层,那么在搜索的时候,就同样需要遍历所有的节点。
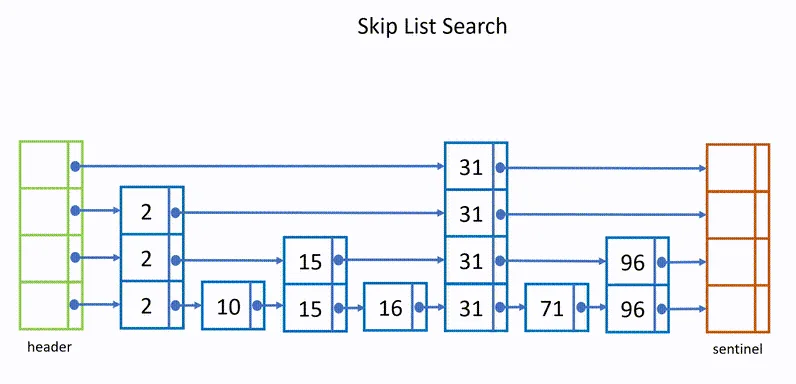
解决这个问题的思路与常见的跳表算法相似,如下图要搜索跳表,从最高层开始,沿着具有最长 “跳过” 的边向右移动。如果发现当前节点的值大于要搜索的值 - 我们知道已经超过了目标,因此我们会在下一级中向前一个节点。
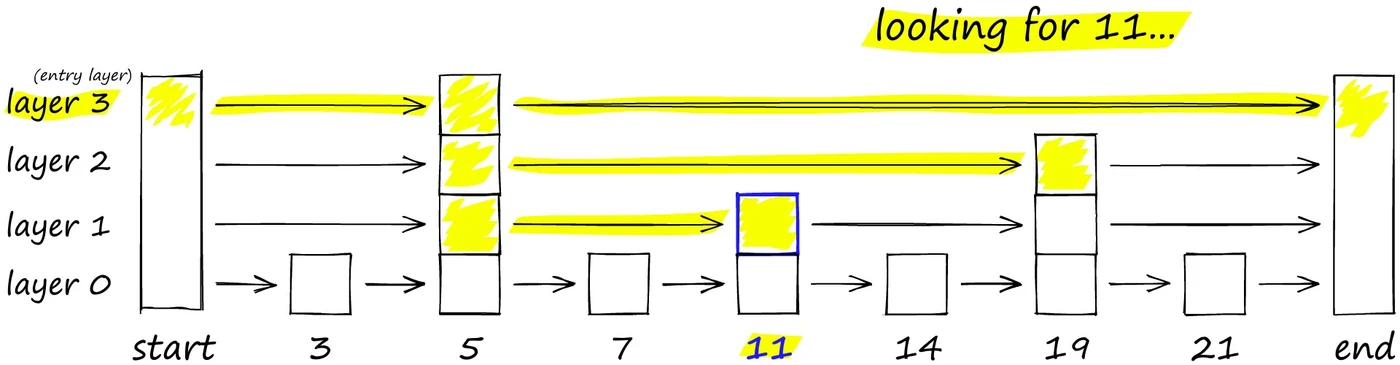
HNSW 继承了相同的分层格式,最高层具有更长的边缘(用于快速搜索),而较低层具有较短的边缘(用于准确搜索)。
具体来说,可以将图分为多层,每一层都是一个小世界,图中的节点都是相互连接的。而且每一层的节点都会连接到上一层的节点,当需要搜索的时候,就可以从第一层开始,因为第一层的节点之间距离很长,可以减少搜索的时间,然后再逐层向下搜索,又因为最下层相似节点之间相互关联,所以可以保证搜索的质量,能够找到最相似的向量。
HNSW 算法是一种经典的空间换时间的算法,它的搜索质量和搜索速度都比较高,但是它的内存开销也比较大,因为不仅需要将所有的向量都存储在内存中。还需要维护一个图的结构,也同样需要存储。所以这类算法需要根据实际的场景来选择。
通过一个简单的例子来说明 HNSW 的工作原理。