
互联网大厂异地多活架构方案
《互联网大厂异地多活架构方案》共 0.7 万字,通篇围绕 架构、部署、延迟、数据库 展开,归在「后端与系统架构」这一层。
适合给 AI 系统搭底座、要管得住的人
目录骨架(8 节)
- 接二连三的 P0 级事故(高可用事故)
- 架构师们,锅能不背么?
- 什么是优秀的架构
- 两个 P0 级故障的根因分析
- 什么是异地多活
- 常见的多活方案
- 方案 1:同城双活
- 方案 2:两地三中心
分享内容
- 高可用事故
- 故障的根因分析
- 什么是异地多活
- 常见三种多活方案
- 异地多活三大挑战
接二连三的 P0 级事故(高可用事故)
- 3 月 5 日 B 站崩了
- 3 月 29 日 唯品会又崩
P0 级事故:3 月 5 日 B 站崩了
3 月 5 日晚,有小伙伴发现,从 20:22 分开始 B 站的服务器就处于状态,用户无法观看视频和刷新推荐内容。直至 20:40 左右才恢复正常,持续时间近二十分钟。
事故复盘
B 站 APP 端,用户可以在有缓存的情况下打开首页,
在没有缓存的情况下,会得到的是报错提示,访问视频资源时无法正常加载页面。
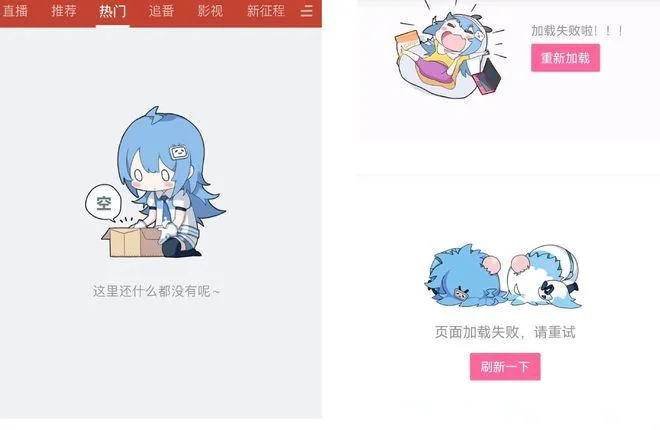
Web 端主站的用户点击 “换一换” 无法正常刷新,多尝试几次会得到提示“暂时没有新内容了”。
事故原因
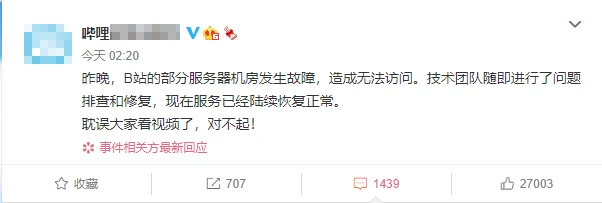
次日凌晨 2 点,B 站发布公告称,昨晚,B 站的部分服务器机房发生故障,造成无法访问。
技术团队随即进行了问题排查和修复,现在服务已经陆续恢复正常。
影响范围
以 B 站 6000 万的日活、晚 8 点是传统的视频用户高活跃期来看,本次事故影响的用户量级超千万。
以互联网企业常规的事故评判标准来看,应该属于 P0 级事故,
对于这种严重的事故, 主要技术负责人面临扣绩效甚至背锅走人的风险。
P0 级事故:3 月 29 日 唯品会又崩
事故复盘
3 月 29 日发生的突发事件,唯品会 App 崩了当天冲上热搜。
故障的现象:“加购” 等功能或出现异常。
故障的时长: 12 小时。
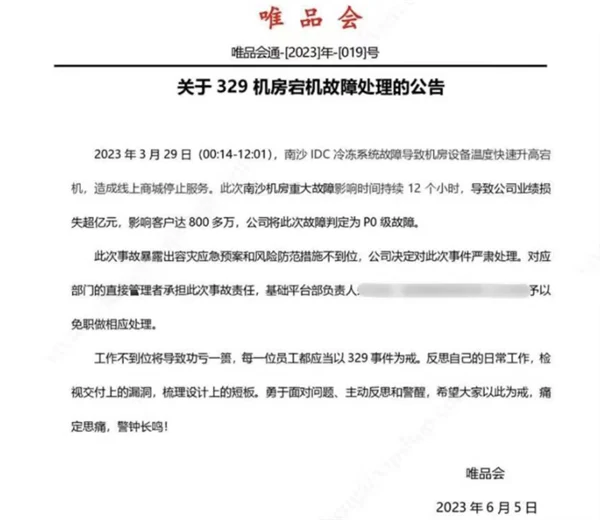
6 月 6 日消息,唯品会发布了一份处理公告,3 月 29 日 唯品会 App 崩了的事故,判定为 P0 级故障。
什么是 P0 级 事故?
事故等级主要针对生产环境,划分依据类似于bug等级。

P0级 属于最高级别事故。  比如崩溃,页面无法访问,主流程不通,主功能未实现,或者在影响面上影响很大(即使bug本身不严重)。

P1级 属于高级别事故。 一般属于主功能上的分支,支线流程,核心次功能等

P2级 属于中级别事故。主要根据企业实际情况划分。

P3级 属于低级别事故。 主要根据企业实际情况划分。

PN级  ...级别越高。
P0 属于最高级别事故,比如崩溃、页面无法访问、主流程不通、主功能未实现,或在影响面上影响很大 (即使 Bug 本身不严重)。
官方在公告中称,此次南沙机房重大故障影响时间持续 12 个小时,导致公司业绩损失超亿元,影响客户达 800 多万。
唯品会表示,决定对此次事件严肃处理,对应部门的直接管理者承担此次事故责任。
关键是,主要技术负责人面临扣绩效甚至背锅走人:基础平台部负责人予以免职做相应处理。
架构师们,锅能不背么?
所以,架构师的视角,不是关注 B 站、唯品会损失了多少亿。
而是关注的是咱们架构师的职业生涯, 简单来说,就是一句话:
架构师们,锅能不背么?
这里,先把责任明确一下。
基础平台部负责人 虽然是 管理岗,本身也有一定的架构职责,所以,从一定意义上说,也是架构师。
当然,有的小伙伴会说, 架构师就是技术军师、技术师爷, 负责出方案,出主意的。基础平台部负责人 不是架构师。
如果一定要这么说,也行。
既然老帅都丢了,军师会有好受的吗? 同样要背锅走人。
所以,还是同一个问题:架构师们,当如何拜托背锅走人的宿命?
什么是优秀的架构
如何不背锅呢?先得回到问题的本身。
三高架构的三原则
原则 1:高性能意味着系统拥有更大流量的处理能力,更低的响应延迟。
例如 1 秒可处理 10W 并发请求,接口响应时间 5 ms 等等。
原则 2:高并发表示系统在迭代新功能时,能以最小的代价去扩展,系统遇到流量压力时,可以在不改动代码的前提下,去扩容系统。
原则 3:高可用通常用 2 个指标来衡量:
- 平均故障间隔 MTBF(Mean Time Between Failure):表示两次故障的间隔时间,也就是系统「正常运行」的平均时间,这个时间越长,说明系统稳定性越高
- 故障恢复时间 MTTR(Mean Time To Repair):表示系统发生故障后「恢复的时间」,这个值越小,故障对用户的影响越小
可用性与这两者的关系:
可用性(Availability)= MTBF / (MTBF + MTTR) * 100%
这个公式得出的结果是一个比例,通常我们会用「N 个 9」来描述一个系统的可用性。
| 系统可用性 | 年故障时间 | 日故障时间 |
|---|---|---|
| 90% (1 个 9) | 36.5 天 | 2.4 小时 |
| 99% (2 个 9) | 3.65 天 | 14 分钟 |
| 99.9% (3 个 9) | 8 小时 | 86 秒 |
| 99.99%(4 个 9) | 52 分钟 | 8.6 秒 |
| 99.999%(5 个 9) | 5 分钟 | 0.86 秒 |
| 99.9999%(6 个 9) | 32 秒 | 86 毫秒 |
从这张图,大家最好是能耳熟能详。
从图中,可以看到,要想达到 4 个 9 以上的可用性,一年的不可以时间为 52 分钟,平均每天故障时间必须控制在 10 秒以内。