
亿级用户中心的设计与实践
《亿级用户中心的设计与实践》共 0.5 万字,通篇围绕 数据库、安全、监控、Redis 展开,归在「后端与系统架构」这一层。
适合给 AI 系统搭底座、要管得住的人
目录骨架(8 节)
- 一、服务架构
- 二、接口设计
- 三、分库分表
- 四、Token 之柔性降级
- 五、数据安全
- 六、异步消费设计
- 七、灵活多样的监控
- 八、总结
分享内容
用户中心是互联网最为基础的核心系统,随着业务和用户的增长,势必会带来不断的挑战。如何在亿级的情况下保证系统的高可用,高性能以及高安全,我们来分享下实践方案。
用户中心,顾名思义就是管理用户的地方,几乎是所有互联网公司最为核心的子系统之一。它的核心功能是登录与注册,主要功能是修改密码、换绑手机号码、获取用户信息、修改用户信息和一些延伸服务,同时还有登录之后生成 Token 以及校验 Token 的功能。下面我们从几个维度来拆解用户中心。
一、服务架构
用户中心既需要为用户提供服务,也会承担其他业务的频繁调用;既然需要为用户提供服务,它就会自带一些业务逻辑,比如用户在登录过程中需要风控或短信的校验,那么就会存在不可用的风险。而比如获取用户信息的接口,则没有那么多的依赖,可能只需要调用数据库或者缓存就可以。获取用户信息接口要求稳定,而核心的登录注册接口也需要稳定,但是当我们在接口层面加一些策略或者修改的时候,不希望因为上线问题导致整个服务不可用,而且上线后,需要对整个服务功能做全量的回归,导致资源严重浪费。
因此,基于业务特性,我们可以将用户中心拆成 3 个独立的微服务: 网关服务,核心服务,异步消费者服务。网关服务,提供 http 服务,聚合了各种业务逻辑和服务调用,比如登录时候需要校验的风控或者短信;核心服务,处理简单的业务逻辑以及数据存储,核心服务处在调用链路的终端,几乎不依赖调用其他服务,比如校验 Token 或者获取用户信息,他们就只依赖于 redis 或者数据库;而异步消费者服务,则处理并消费异步消息。
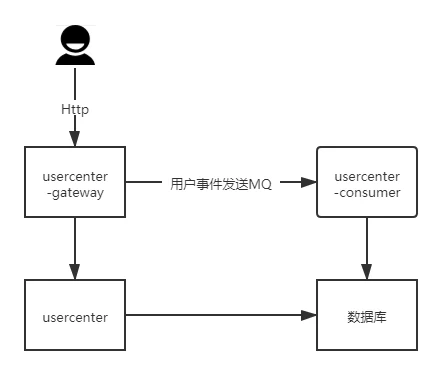
这样的设计之后,当有新功能上线时,核心服务和异步消费服务几乎不需要重新发布,只需要发布网关服务,依赖我们核心服务的第三方非常放心,层级也非常的清晰。当然,这样做的代价就是服务的调用链路变长了。由于涉及到网关和核心服务,就需要发布两个服务,而且要做兼容性测试。
二、接口设计
用户中心的接口涉及到用户的核心信息,安全性要求高;同时,承接了较多第三方的调用,可用性要求也高。因此,对用户中心的接口做以下设计:
首先,接口可以拆分为面向 Web 和面向 App 的接口。Web 接口需要做到跨域情况下的单点登录,加密、验签和 token 校验的方式也同 App 端的不一样。
其次,对核心接口做特殊处理。比如登录接口,在逻辑和链路上做了一些优化。为什么要对这些接口做特殊处理呢?假如用户不能登录,用户会非常恐慌,客诉量会立马上来。
那怎么做呢?一方面,我们将用户核心信息表做简单。用户的信息当中会包含 userId、手机号码、密码、头像、昵称等字段,假如把用户的这些所有信息都保存在一张表中,那么这张表将会异常庞大,变更字段变得异常困难。因此,需要将用户表拆分,将核心的信息保存在用户表中,比如 userId、username、手机号码、密码、盐值(随机生成)等;而一些如性别,头像,昵称等信息保存在用户资料表中。
另一方面,我们需要将登录的核心链路做短,短到只依赖于读库。一般情况下,用户登录后,需要记录用户登录信息,调用风控或者短信等服务。对于登录链路来说,任何一个环节出现问题都有可能导致用户无法登录,那么怎么样才能做到最短的链路呢?方法就是依赖的服务可自动降级。比如说反欺诈校验出问题了,那么它自动降级后使用它的默认策略,极端情况下只做密码校验,主库挂了之后还能到从库读取用户信息。
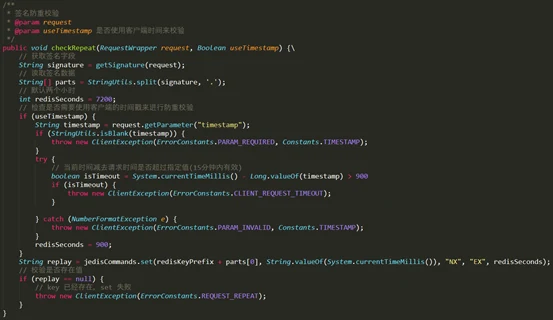
最后就是接口的安全性校验。对 App 接口我们需要做防重放和验签。验签可能大家比较熟悉,但是对防重放这个概念可能相对陌生。防重放,顾名思义就是防止请求重复发送。用户请求在特定时间段内只能请求一次。即使用户请求被攻击者挟持,在一段时间内也无法重复请求。如果攻击者想要篡改用户请求再发送,对不起,请求不会通过。得益于大数据的支持,结合终端,我们还可以把每个用户行为画像存储在系统中(或者调用第三方服务)。用户发起请求后,我们的接口会根据用户画像对用户进行诸如手机号码校验、实名认证、人脸或者活体校验。
三、分库分表
随着用户的增长,数据超过了 1 亿,怎么办?常见的办法就是分库分表。我们来分析一下用户中心常见的一些表结构:用户信息表,第三方登录关联表,用户事件表。从上述表中可以看出来,用户相关的数据表增长相对缓慢,因为用户增长是有天花板的。用户事件表的增长是呈指数级增长,因为每个用户登录、变更等密码及变更手机号码等操作是不限次数。
因此,首先我们可以先把用户信息表垂直切分。正如上面说的,将用户 ID、密码、手机号、盐值等常见字段从用户信息表中拆分,其他用户相关的信息用单独一张表。另外,把用户事件表迁移至其他库中。相比于水平切分,垂直切分的代价相对较少,操作起来相对简单。用户核心信息表由于数据量相对较少,即使是亿级别的数据,利用数据库缓存的机制,也能够解决性能问题。