
小红书性能优化平台落地实践
《小红书性能优化平台落地实践》共 0.5 万字,通篇围绕 成本、场景、落地、Agent 展开,归在「推理、部署与算力」这一层。
适合要把模型跑起来,还得跑得起的人
目录骨架(8 节)
- 1.背景
- 2.思路
- 3.整体方案
- 3.总结
- 3.1 数据采集、处理、存储
- 3.2 存量优化
- 3.3 性能持续优化
- 3.4 性能异常问题定位
分享内容
随着小红书业务的快速发展,资源消耗和成本压力显著增加。在降本增效的大背景下,我们建设了性能持续优化 & 追踪平台,来系统性辅助业务团队解决性能问题,在业务系统日常的演化过程中,持续跟进、追踪系统的性能退化并推动优化。
目前,这一平台已覆盖小红书搜索、推荐、广告的 S0 服务,运行两个多月以来,辅助业务团队存量优化超 1 万 CPU 核;发现性能退化超 1 万 CPU 核并跟进优化。
1.背景
当前,小红书正处在快速发展期间,流量的快速上涨和业务的快速迭代,显著增加了资源消耗和成本压力。
在存量的资源占用上,我们要求研发人员对应用做尽可能深度的性能优化。然而,研发人员在对自己的模块做性能优化时,往往缺少工具来辅助分析,工具的合理选择、环境配置、使用方式等各个方面,都有较高的学习成本。
另一方面,当前性能优化主要依靠个人经验进行逐个分析,缺乏通用化的机制,经验较难在团队间共享。即使有人发现一个通用的性能问题,也很难衡量其涉及的模块和整体的优化空间。
此外,小红书业务的日常迭代往往会带来增量的资源消耗,即性能退化。特别是对于频繁迭代的模块,如一些推荐应用,每天进行发版且每个版本涉及十多次不同的提交。在这些提交中,可能会隐藏着一些性能退化点。显著的性能退化点会在性能压测中被发现,而更多的性能退化往往是微小的,比如一个 commit 带来了整体 CPU 1% 左右的占用,这样微小的退化是隐蔽的,通过常规压测等手段比较难以发现。
随着业务的迭代,日积月累下,多个微小的性能退化会导致应用整体性能的显著恶化,进而积重难返。经过一段时间的积累后,在排查这种问题时,面对动辄上百次的代码提交历史,开发同学很难排查出真正导致性能退化的提交是什么。最终只能以稳定性的名义增加资源扩容,这样的情况多次发生。
针对此,我们尝试从整体上解决性能问题,设计开发了一套性能优化和持续追踪的平台,来辅助应用研发人员分析性能问题,同时在日常的业务系统演化过程中,持续跟进、追踪系统的性能退化并推动优化。
2.思路
我们的目标是从整体上解决性能问题。
问题主要聚焦在以下三个方面:
存量性能优化:对应用进行全方位的深入分析、诊断、优化;优化的经验积累后,横向扩展,做到通用的优化
增量性能退化拦截:业务迭代过程中,主动发现应用的增量资源占用,即性能退化
性能稳定性问题:对一些突发的性能恶化导致的稳定性问题,快速定位原因
对应的总体技术思路:
分析手段:基于 profiling 等采样手段,来对应用进行剖析
产品化:做到平台化来提高易用性,研发人员可以尽可能低门槛、高效的使用;
持续优化:在机制上做到持续优化,将采样分析做到常态化、例行化,将性能优化、分析、防退化,融入到业务应用的日常迭代中,关注应用的每一个版本、每一次代码提交、每一个策略实验进行,持续追踪业务应用的性能表现。
3.整体方案
我们的内部落地整体架构如下:
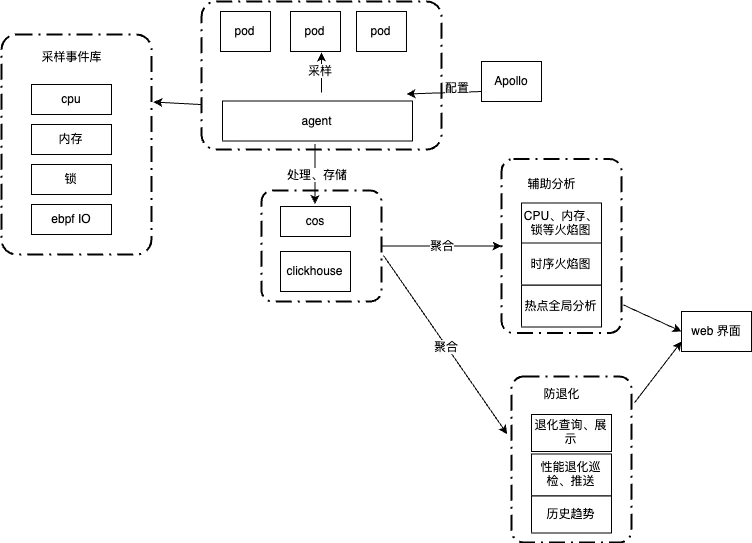
核心思路是通过对业务进程进行持续性的采样、处理、存储,并基于采样数据做分析,来辅助性能优化和发现性能退化。
数据采样上,我们用单机低频次持续采样,降低成本,减少对应用的影响。
在分析上,数据来自大数据存储,并从纵向、横向来对比分析:在纵向上,采用 merge + diff 分析,来发现退化点;在横向上,提供跨应用的通用查询能力,查询、分析函数粒度的资源占用。
3.1 数据采集、处理、存储
3.1.1. 数据采集
当前主要的数据采集方式是通过对进程进行 profiling,profiling 的原理是基于一定的频率对运行进程进行采样,来了解进程的特征。当前,profiling 支持从多个方面对程序进行采样分析,如 CPU、Memory、Thread、Lock、I/O 等。日常使用中,对 CPU 进行 profiling 的应用最为广泛。
一般的 CPU profiling 是 On-CPU,也就是 CPU 时间花费在哪些代码执行上。在 On-CPU 之外,还有 Off-CPU,指的是进程不在 CPU 上运行的时间,比如进程因为 IO、锁等原因处于等待,花费了时间。所以,Off-CPU 是对 On-CPU 的补充,整体关系如下:
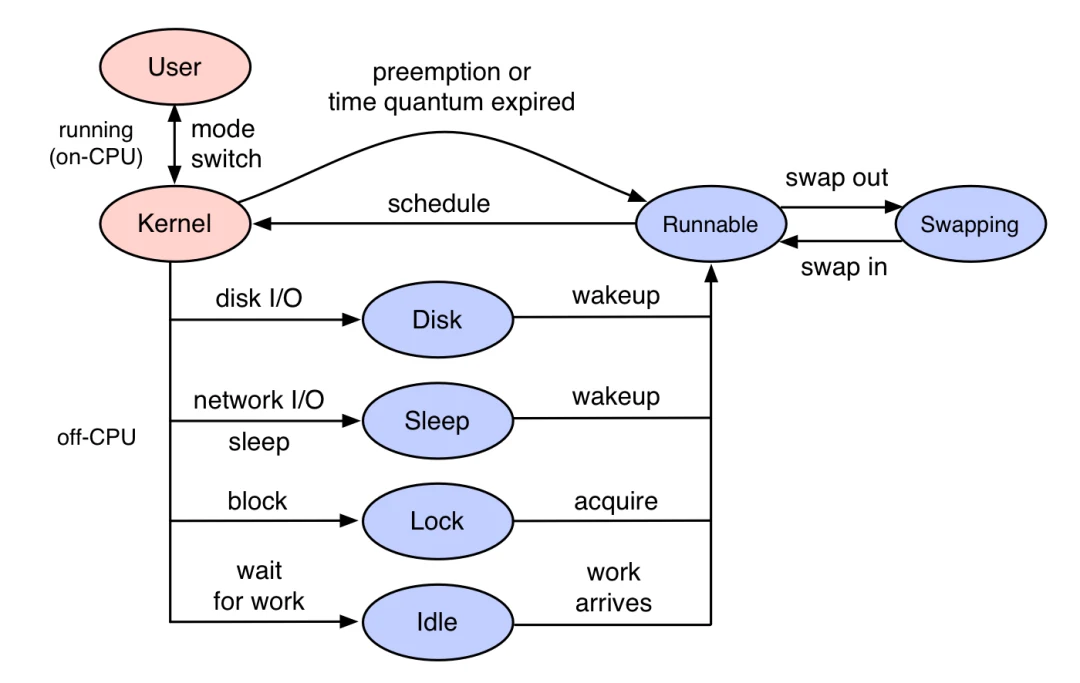
根据应用的实际情况,综合的对 On-CPU、Off-CPU 进行采样,更为全面地了解程序的运行情况。
在多语言支持方面,当前我们支持 C++、JAVA、Golang 等主流语言:
C++ 应用:通过 Linux perf
JAVA 应用:目前主流方案(如 IntelliJ IDEA 和阿里的 Arthas)是通过 Async-profiler 来实现 profiling。Async-profiler 是将 Perf 的堆栈追踪和 JDK 提供的 AsyncGetCallTrace 结合了起来,低开销的支持多种 Perf event。我们的方案里也借助了这个工具,并针对我们的需求进一步做了定制开发