
基于DB-GPT开发金融财报分析助手
《基于DB-GPT开发金融财报分析助手》共 0.6 万字,通篇围绕 召回、检索、向量、金融 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 一、背景
- 二、架构方案
- 三、金融知识构建
- 四、意图识别
- 五、Text2SQL
- 六、金融知识检索
- 3.1 数据预处理
- 3.2 知识抽取
一、背景
最近,利用大模型进行财务报表分析正逐渐成为垂直领域的一个热门应用。大模型能够比人类更准确地理解复杂的财务规则,并在基于专业知识的基础上输出合理的分析结果。然而,财务报表信息庞大且复杂,对数据分析的准确性要求极高,通用的RAG和Agent的解决方案往往难以满足这些需求。
以某公司的2022年财务报表为例,传统方法在处理类似“2022年XXX子公司的第三季度的营业净利润是多少?”的查询时,通常通过知识向量相似检索和匹配来召回最相关的文本块进行总结和问答。然而,财务年报中包含多处相关信息,如不同季度的利润表、现金流量表等,这些信息可能会引发误判。如果不能准确召回并理解正确部分,就容易生成错误答案。如果涉及到财务指标的计算,分析过程可能会变得更加复杂。例如,计算毛利率、净利率等指标需要对收入和成本等多方面的数据进行综合分析。
为了克服大模型应用中的这些挑战,我们需要结合财务领域的知识背景,添加专门的外部模块来增强其功能。我们以DB-GPT的AWEL编排模式为例,借助DB-GPT-Hub的几个关键原子,详细阐述如何利用大模型进行有效的财报数据分析,希望能为在垂直领域的进行数据AI赋能的朋友提供一些思考。
DB-GPT项目地址:https://github.com/eosphoros-ai/DB-GPT
二、架构方案
实现方式可以通过上传公司年报,利用大模型作为知识驱动引擎,调用向量数据库、关系型数据库、OCR服务以及相关模型等组件,通过AWEL(agent流式编排)构建一个财报分析的问答助手,能够直接回答用户这几类问题:
- 财报基础信息回答
- 财报指标计算
- 报告解读分析
- 专业名词解释
这里的架构设计主要是通过意图分类解决财报分析中可能出现的问题。针对每类意图执行单独的处理链路,每条处理链路基于不同场景精心设计。同时为了保证数据分析的正确性,我们还会通过解析和抽取用户查询中的相关参数,调用工具或执行SQL查询,为分析结果提供更准确的数据支持。因此整个架构围绕3部分进行实现,金融知识构建,查询意图识别,以及金融知识检索。
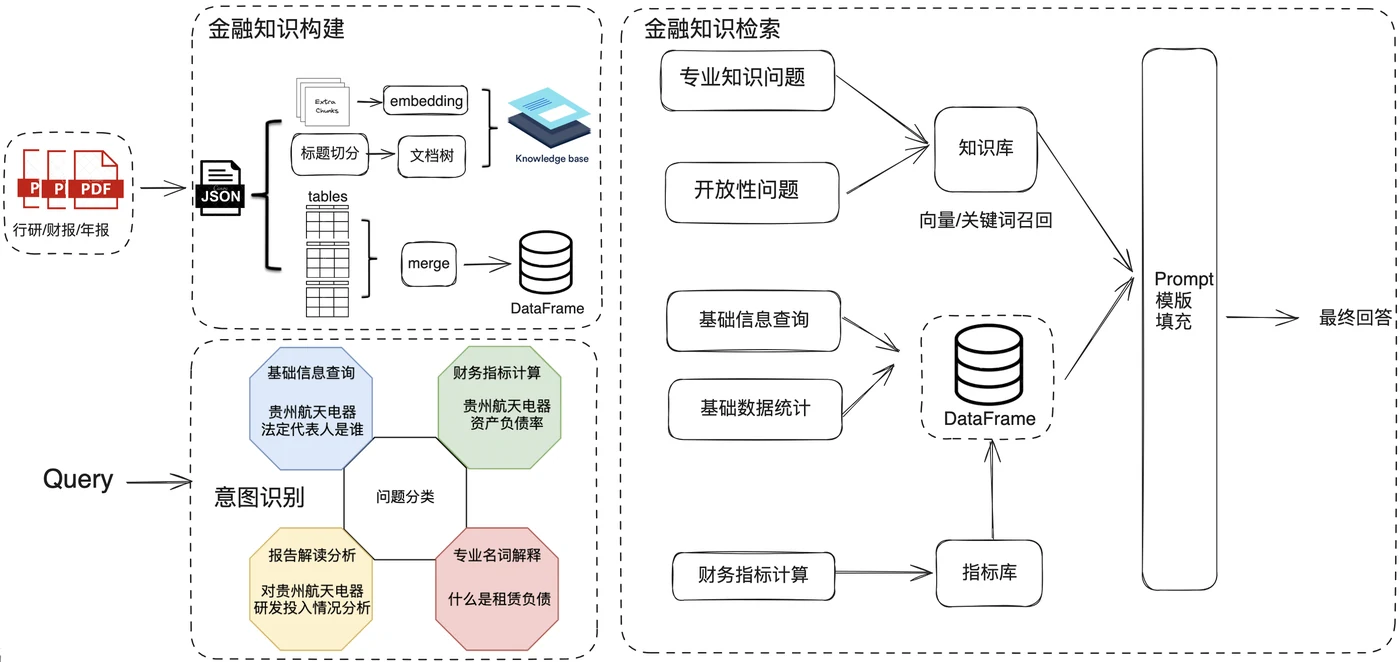
- 金融知识构建,目的是进行数据多元化的信息抽取与索引存储,涉及pdf文档加载,数据预处理,PDF转JSON,文档切分,文档树构建,表格的提取与合并,Embedding以及数据存储等过程。
- 查询意图识别,目的是进行问题分类以及槽位提取,可以解析和抽取用户查询中的相关参数后可以路由到不同的知识检索处理流程中。
- 金融知识检索,目的是更精准地查询出用户想要的知识信息,涉及RAG以及Text2SQL的处理。
三、金融知识构建
在A股上市公司发布的财务报告中,通常会包含一些重要的文本描述、财务表格和其他附注信息。每个财务报表都提供了不同方面的财务数据,用来展示公司的财务状况、经营成果和现金流情况:
- 资产负债表显示公司的资产、负债和股东权益,提供了公司在某一特定日期的财务状况。
- 利润表展示公司在一定期间内的收入、成本、费用及净利润情况,反映公司的经营成果。
- 现金流量表展示公司在一定期间内现金及现金等价物流入和流出的情况,分为经营活动、投资活动和筹资活动三个部分。
- 所有者权益变动表展示公司在一定期间内股东权益的变动情况,包括净利润、分红、增发等。
- 财务报表附注提供了对报表中项目的详细解释和补充说明,帮助报表使用者更好地理解公司的财务状况和经营成果。
这些表格数据结构化程度高,需要提取出完整有用的数据信息进行加工处理。而财报文本部分则包含大量公司简介、业务描述、风险分析和管理层讨论等重要信息。我们希望大模型能够通过深入理解文本内容,提取对投资决策有帮助的信息,如公司未来的战略规划、市场风险和机遇等。
3.1 数据预处理
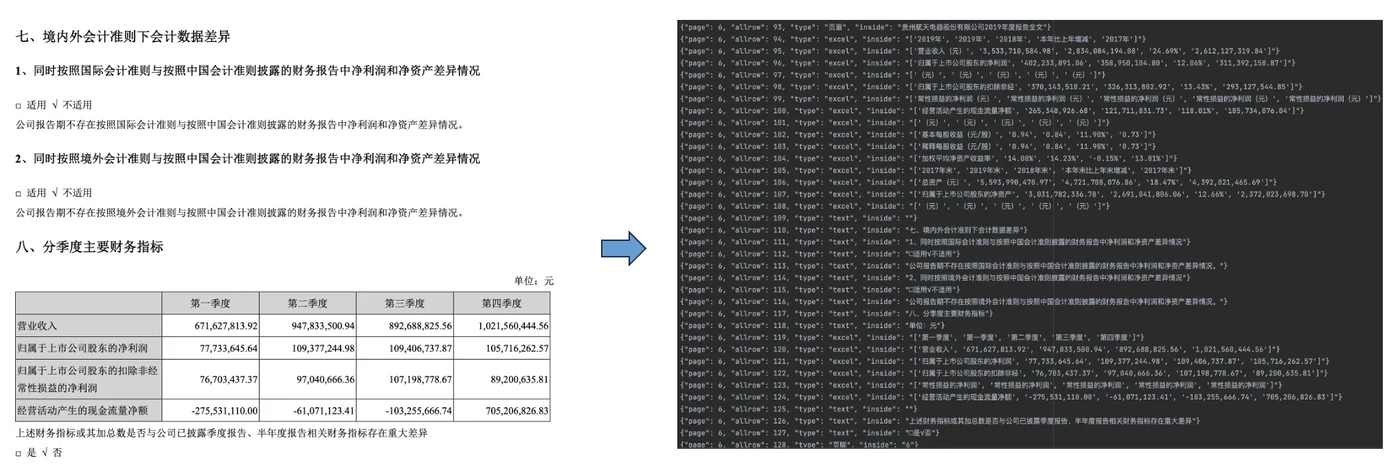
针对财报pdf这样的非结构化数据处理,考虑到针对财报文档的一些特性,表格数据密集,专业术语繁多等情况,需要在信息抽取之前对pdf这样的非结构化数据进行预处理,主要的思路是将非结构化数据 -> 结构化数据,因此首先在数据读取和数据预处理模块,利用pdfplumber按页读取并转换为json格式,并且识别出哪些是需要的文本数据,哪些是表格数据,哪些是不需要的数据,比如页眉,页脚等等。
3.2 知识抽取
数据预处理后,我们得到了标准的结构化的json数据,基于处理后的json数据,我们将内容划分为文本和表格两大块,针对这两块数据分别进行文本信息抽取和表格抽取。
3.2.1 文本抽取
文本抽取包括知识切片,元数据信息抽取,embedding等一系列子任务组成。
知识切片主要目的是1.保持语义相关性,也就是上下文相关性,这直接关乎回复准确率。2.保持在大模型的上下文限制内,分块保证输入到LLMs的文本不会超过其token limitations。这里有很多种分片策略进行选择:按照文本大小切分,按照页切分,按照标题进行切分。本次案例为了保持语义的相关性,推荐采取按照页进行切分和按照标题级别进行切分。