后端与系统架构图文讲义2817 字

从一条SQL的系统异常彻底理解死锁问题

·全库 585 / 611

《从一条SQL的系统异常彻底理解死锁问题》共 7 页、0.3 万字,通篇围绕 并发、MySQL、日志、数据库 展开,归在「后端与系统架构」这一层。

覆盖并发MySQL日志数据库吞吐安全

适合给 AI 系统搭底座、要管得住的人

目录骨架(8 节)
  1. 一条 SQL 导致的系统异常:死锁问题怎么解决?
  2. 4 方案 3 原理详解
  3. 四死锁场景分享
  4. 4)二级唯一索引(查询未命中)
  5. 2 分析 MySQL 死锁日志
  6. 死锁案例一
  7. 死锁案例二
  8. 死锁案例三

原 PDF 已逐页还原成图,共 7 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01一条 SQL 导致的系统异常:死锁问题怎么解决?
  2. 02为什么需要 RedoLog? Buf…
  3. 034)二级唯一索引(查询未命中)
011 / 3
第 1 页:一条 SQL 导致的系统异常:死锁问题怎么解决?
第 1 页

一条 SQL 导致的系统异常:死锁问题怎么解决?

最近线上消费 RocketMQ 的服务频繁报 SQL 死锁异常,虽然最终可以基于事务自动回滚和逻辑重试保证 最终正确性,但若一直放任不管,海量报警日志会掩盖真正需要紧急处理的异常,同时频繁回滚也会降 低消费端的吞吐量。个人通过分析线上服务日志、MySQL 死锁日志、梳理 MySQL 在 RR 级别下的锁机 制,找到了真正的问题所在,并对业务处理逻辑进行了优化

正所谓“工欲善其事,必先利其器”,在具体介绍 CASE 背景和解决方案前,先对需要系统了解的知识点进 行详细介绍,以便大家能够快速理解解决方案。 死锁通常是因为两个及以上事务发生了死循环锁依赖,此时不得不回滚来释放锁,那么事务是个什么东 西?

  • 为什么需要事务? 我们在业务实现时,经常需要保证某一批 SQL 能够具备 ACID 特性,如果没有事务,在应用里自己保证 将会变得非常复杂,InnoDB 引擎引入事务机制,极大简化了我们在此方面的编程模型。 ACID 的实现机制是什么?
  • 原子性(Atomicity):事务内 SQL 要么同时成功要么同时失败,基于 UndoLog 实现。
  • 一致性(Consistency):系统从一个正确态转移到另一个正确态,由应用通过 AID 来保证,并非 数据库的责任。
  • 隔离性(Isolation):控制事务并发执行时数据的可见性,基于锁和 MVCC 实现。
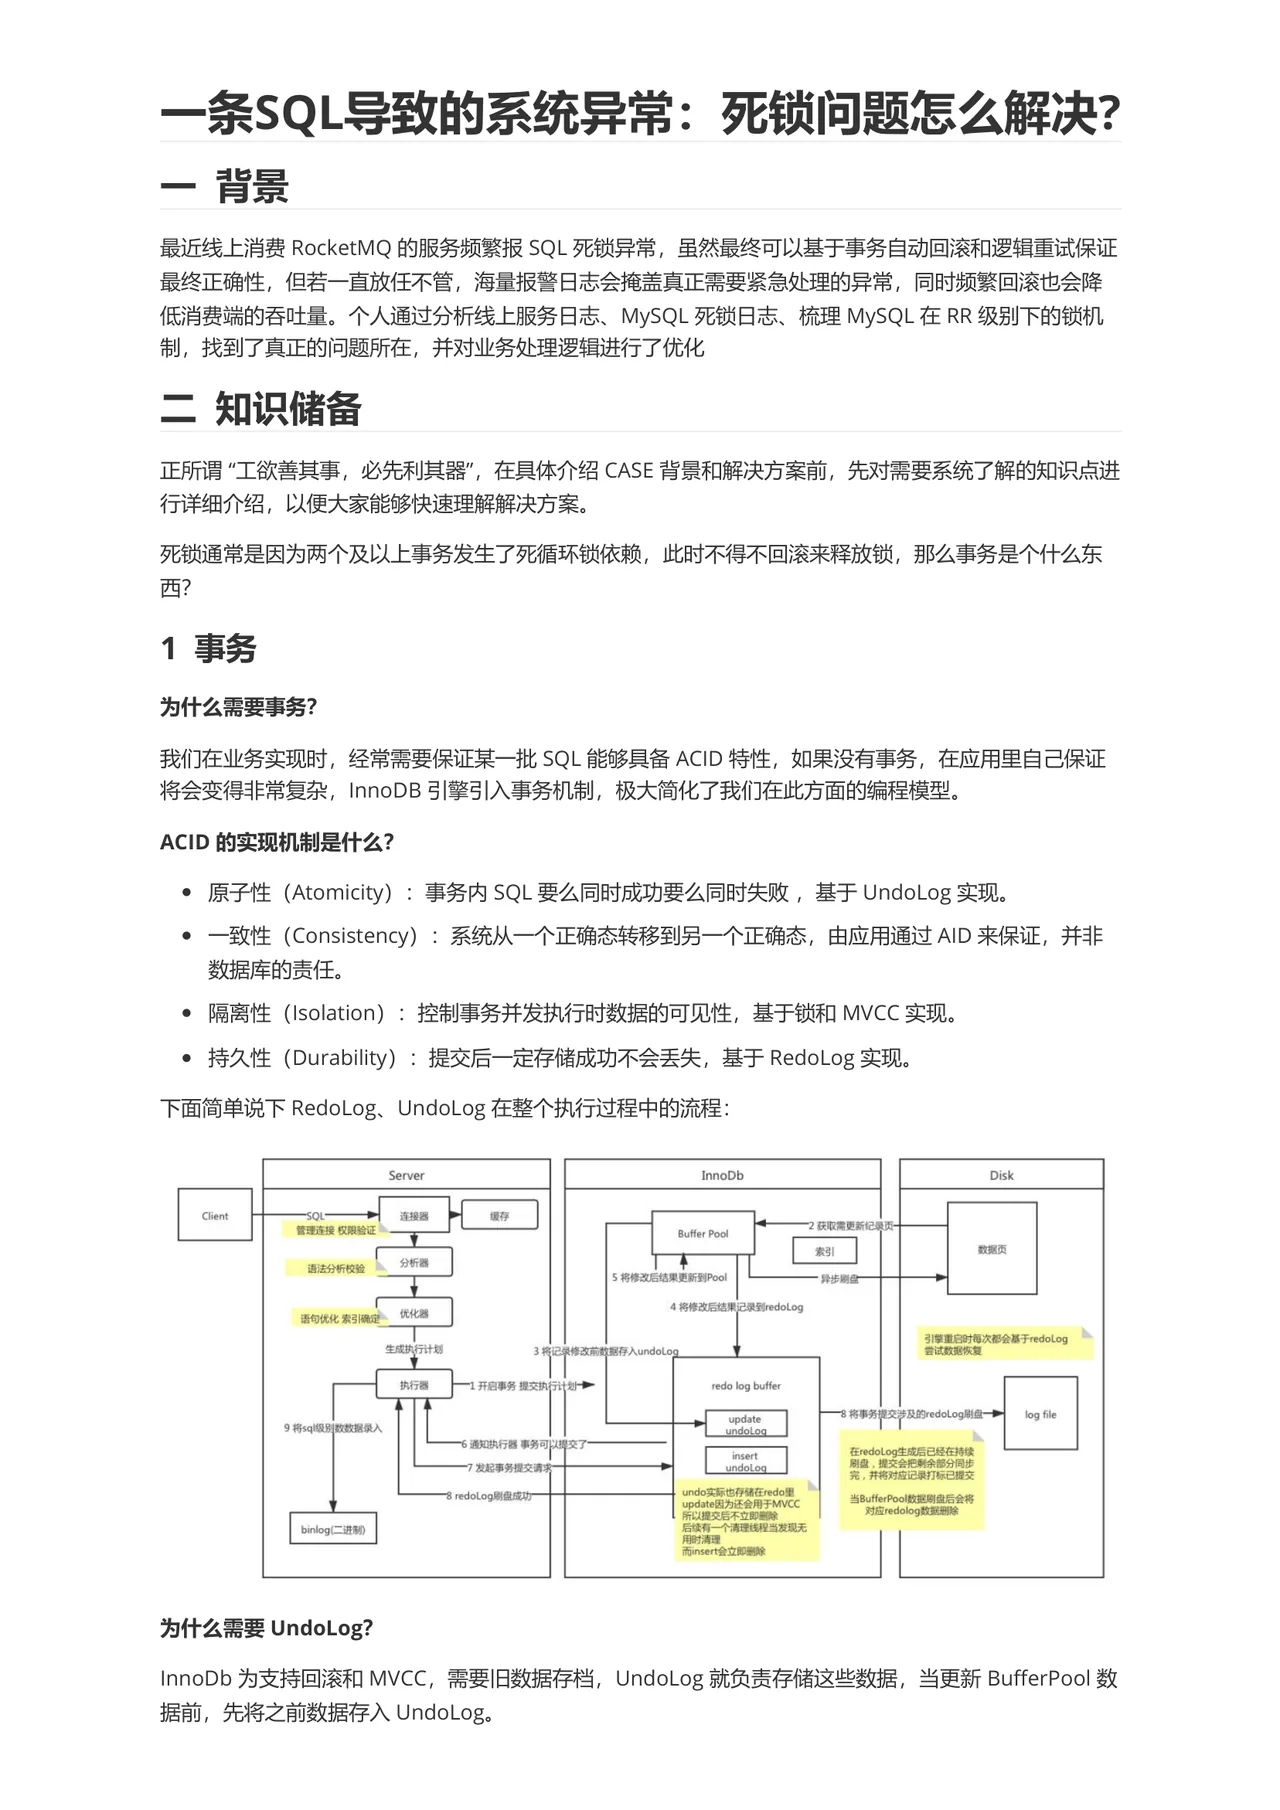
  • 持久性(Durability):提交后一定存储成功不会丢失,基于 RedoLog 实现。 下面简单说下 RedoLog、UndoLog 在整个执行过程中的流程:

9 将 sq 级別数数据泉入

binlog (二进制)

为什么需要 UndoLog? InnoDb 为支持回滚和 MVCC,需要旧数据存档,UndoLog 就负责存储这些数据,当更新 BufferPool 数 据前,先将之前数据存入 UndoLog。

InnoDb

5 将修改后結果更新到 Pool

4 0 份 R 日 NC 31600L09

redo log buffer

undo 类天也价在 redo

update 因为还会用于 MVCC

后桥有一个请理在纪兴发刊天

而 insert 会立即萄除

Disk

5 景里石时母六都公都-redoLog

-8 将事务提交涉及的 redolog 别盘一一 在 redoLog 生成后已经在持续 刷盘,提交会把剩余部分同步

花,开街鸡越北家刊环口理公

当 BufferPool 数掘咧盘后会格 对应 redolog 数起删除

一 1 开启事务提交执行计划-

-6 通知行器事务可以提交了

-8 redoLog 剧盘成功-

022 / 3
第 2 页
第 2 页

为什么需要 RedoLog? Buf…

为什么需要 RedoLog? BufferPool 是随机 10 以页为单位,性能损耗很大,不可每次提交都同步刷盘,需要后续异步进行。不能 同步刷就会有一个问题,如果 MySQL 宕机,而事务已提交在 BufferPool 的数据还没有刷到磁盘,就会 导致数据丢失持久性无法保证。为此引入 RedoLog,这个文件 10 是顺序追加 10 且以修改为单位,性能 很高,每次事务提交持久化 RedoLog 到磁盘也不会对性能造成太大影响,如果宕机可以通过重启从 redoLog 恢复丢失数据。 RedoLog 高性能? 映射一段连续的存储空间,保证顺序 1O,数据先写入 Buffer,后一次性批量将事务数据写入磁盘。

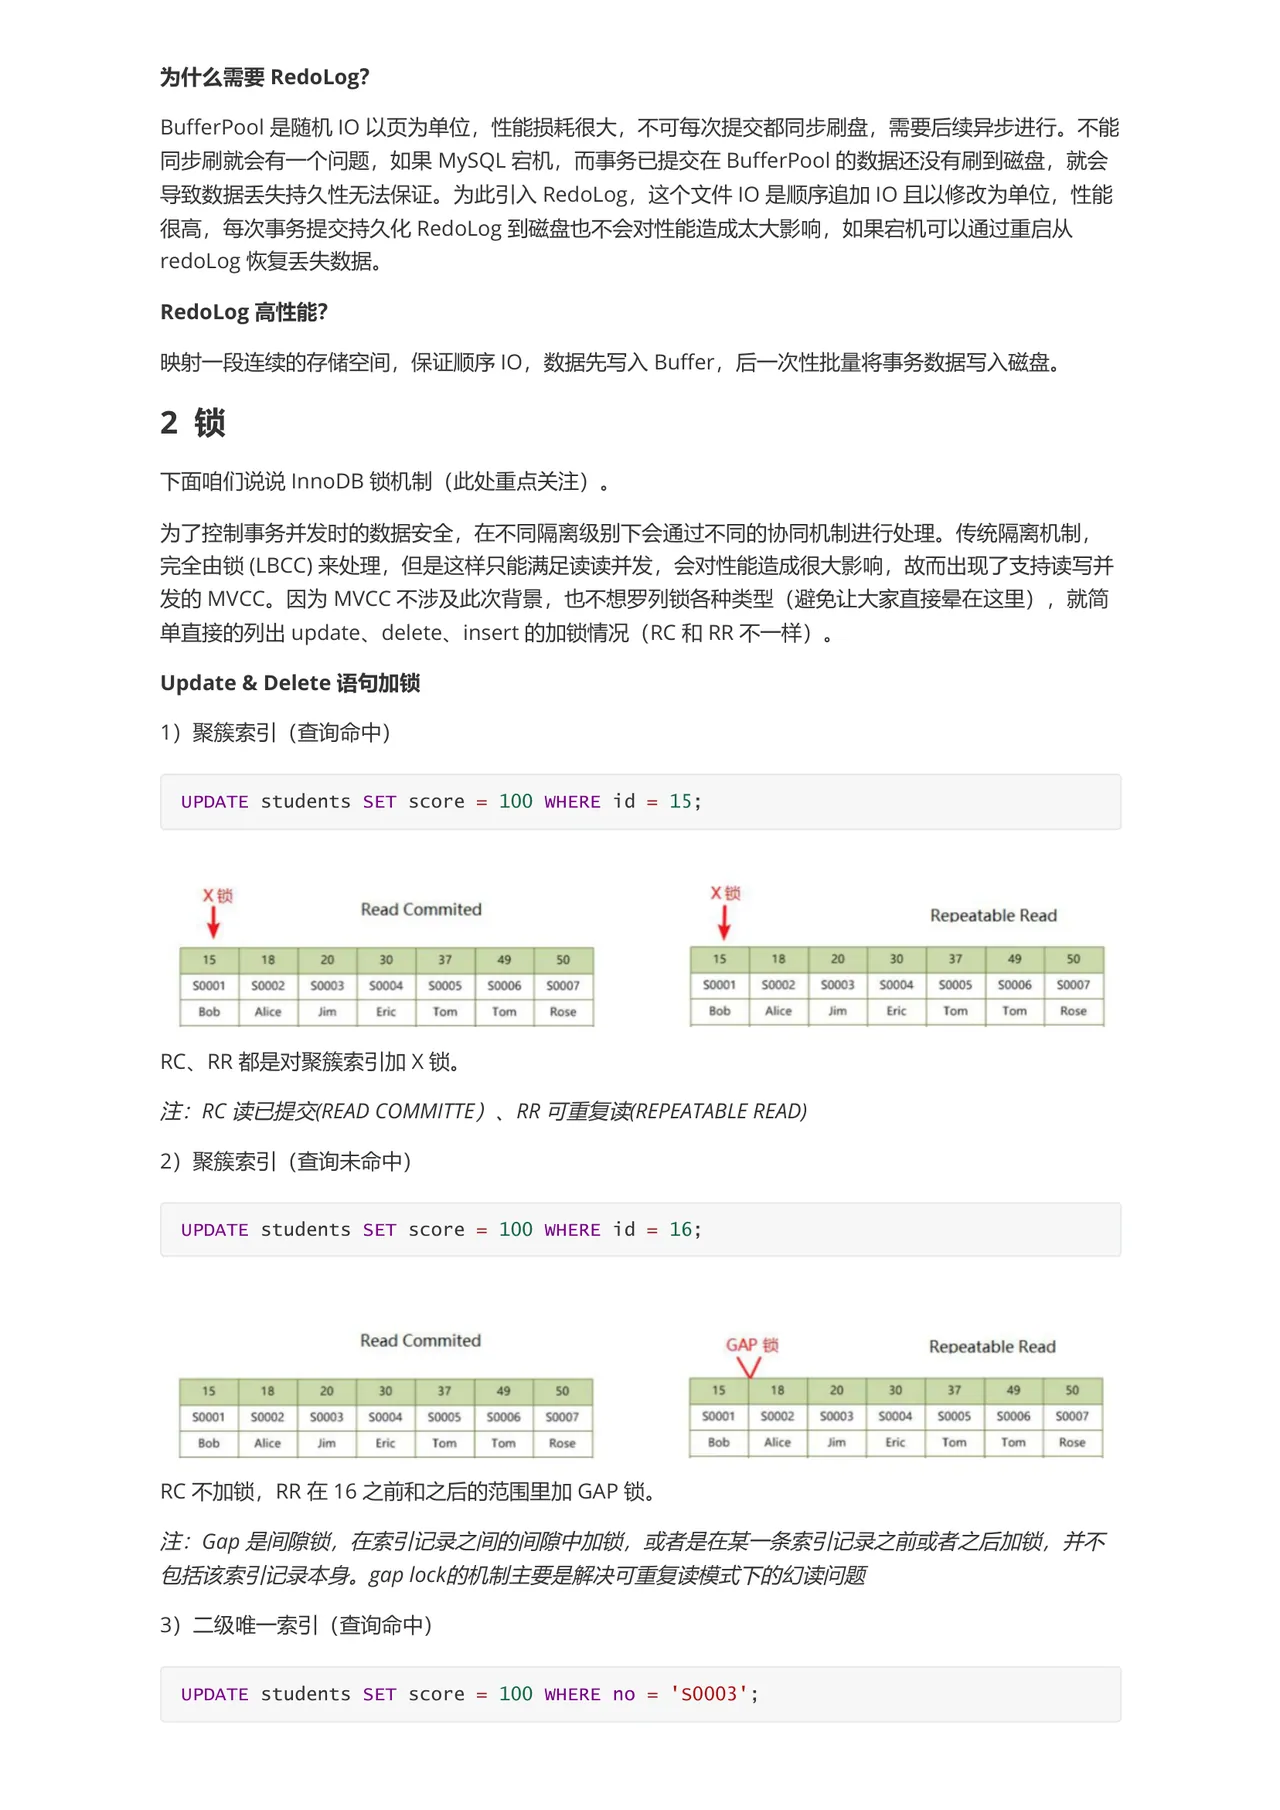
下面咱们说说 InnoDB 锁机制(此处重点关注)。 为了控制事务并发时的数据安全,在不同隔离级别下会通过不同的协同机制进行处理。传统隔离机制, 完全由锁(LBCC)来处理,但是这样只能满足读读并发,会对性能造成很大影响,故而出现了支持读写并 单直接的列出 update、delete、insert 的加锁情况(RC 和 RR 不一样)。 Update & Delete 语句加锁 1)聚簇索引(查询命中)

UPDATE students SET score =| 100 WHERE id = 15;

X 锁 X 锁

Read Commited Repeatable Read

S0001 S0006 S0005 S0006 S0007 S0001 S0002 S0007 S0004 S0003 S0004 Alice Eric Bob Alice Jim Eric Tom Rose Rose Bob Tom Tom Tom

RC、RR 都是对聚簇索引加 X 锁。 注:RC 读已提交(READ COMMITTE)、RR 可重复读(REPEATABLE READ) 2)聚簇索引(查询未命中)

UPDATE students SET score = 100 WHERE id = 16;

Read Commited Repeatable Read

S0002 S0003 S0004 S0005 S0006 S0001 S0007 S0001 S0006 S0007 S0003 S0004 S0005 Eric Alice Alice Tom Tom Eric Tom Tom Bob Bob Rose

RC 不加锁,RR 在 16 之前和之后的范围里加 GAP 锁。 注:Gap 是问隙锁,在索引/记录之间的间隙中加锁,或者是在某一条索引记录之前或者之后加锁,并不 包括该索引记录本身。gap lock 的机制主要是解决可重复读模式下的幻读问题 3)二级唯一索引(查询命中)

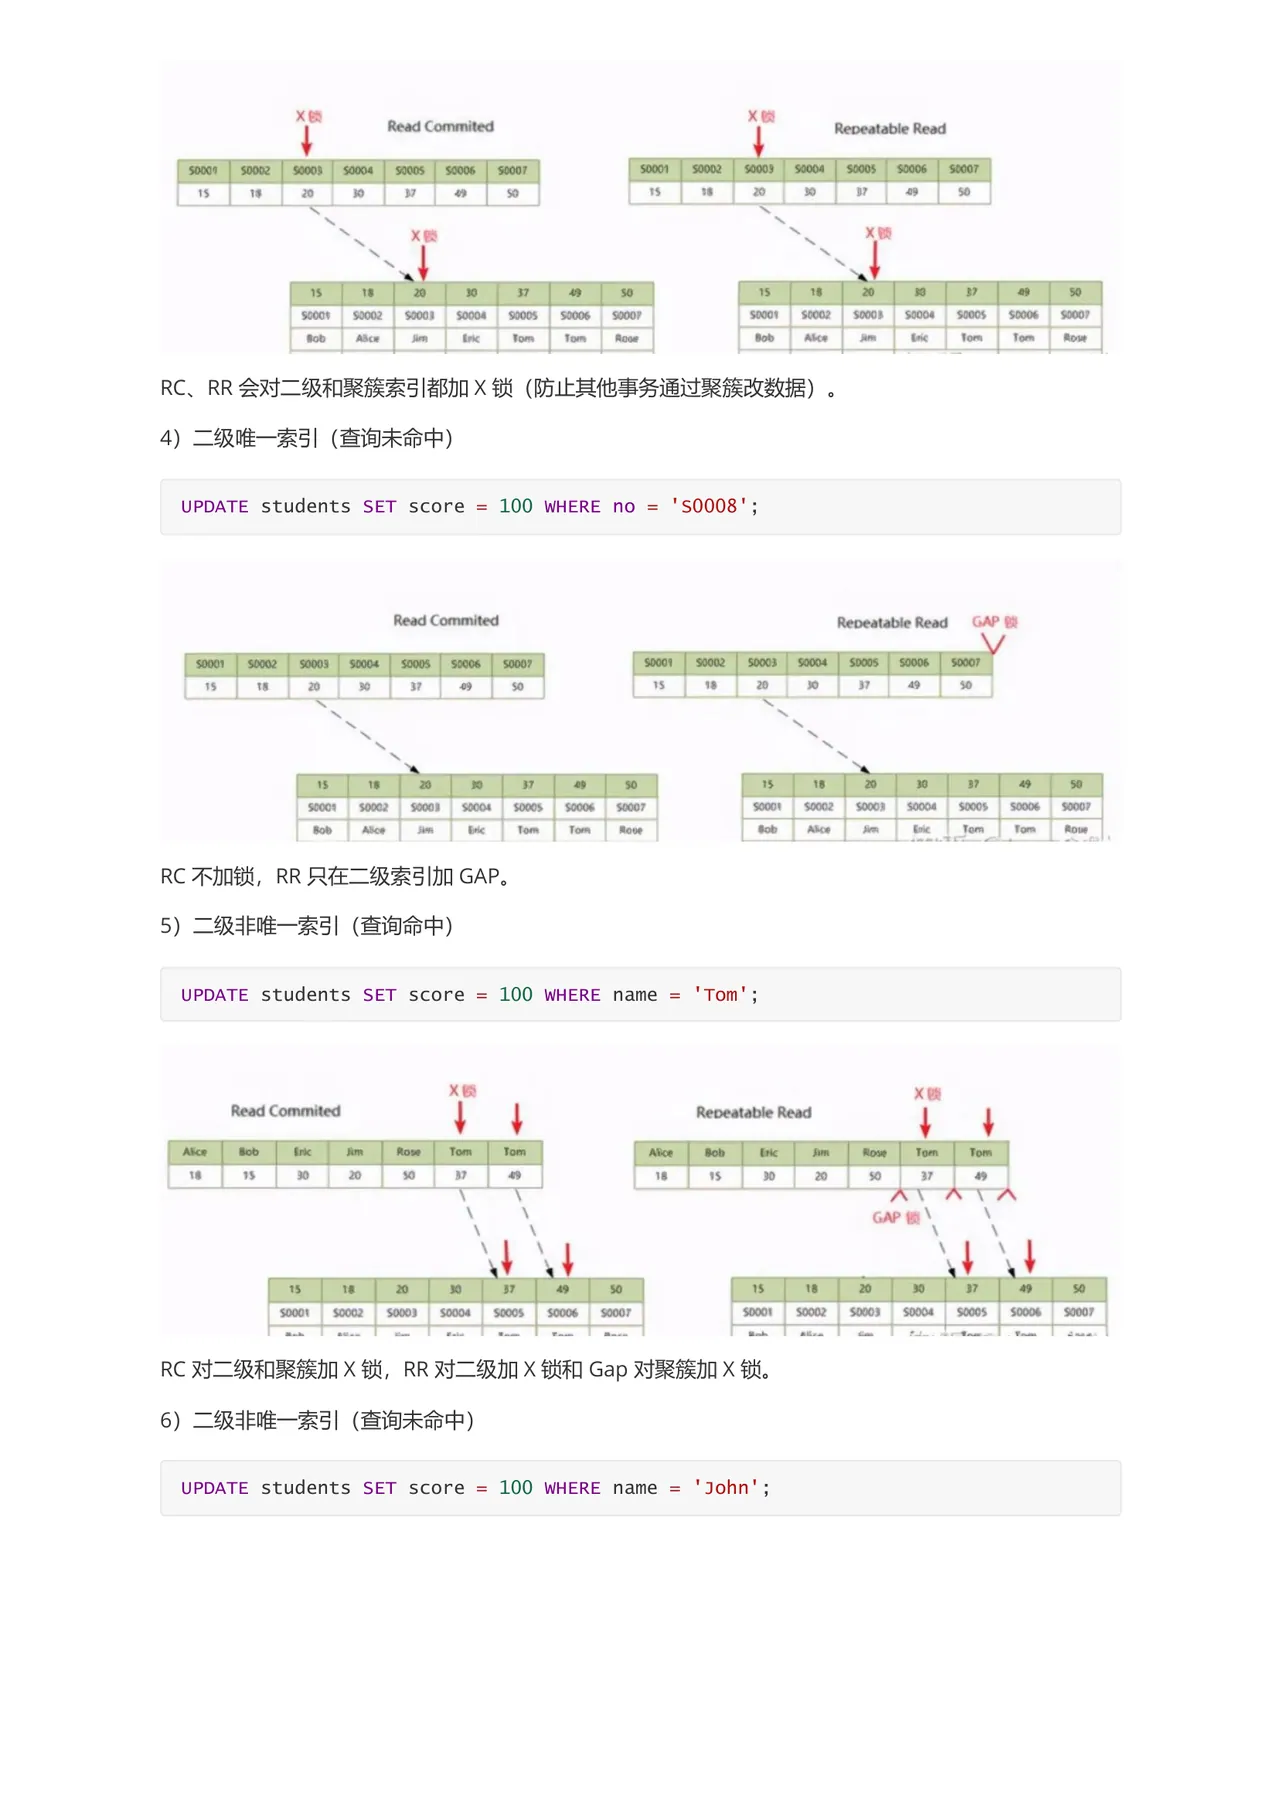
UPDATE students SET score = 100

033 / 3
第 3 页
第 3 页

4)二级唯一索引(查询未命中)

Read Commited Repeatable Read S0004 S0001 S0006 50002 $0004 50007

4)二级唯一索引(查询未命中)

UPDATE students SET score =

Read Commited Repeatable Read $0002 S0006 $0002

$0001 Alce

RC 不加锁,RR 只在二级索引加 GAP。 5)二级非唯一索引(查询命中)

WHERE name = 'Tom';

UPDATE Students

Read Commited Repeatable Read

Tom

$0003 $0007 $0002

RC 对二级和聚簇加 X 锁,RR 对二级加 X 锁和 Gap 对聚簇加 X 锁。 6)二级非唯一索引(查询未命中)

SET score = 100 WHERE name = 'John';

UPDATE students

Tom

S0006

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求