推理、部署与算力图文讲义5173 字

从0到1手写实现一个分布式RPC框架

·全库 586 / 611

《从0到1手写实现一个分布式RPC框架》共 20 页、0.5 万字,通篇围绕 缓存、并发、部署、微服务 展开,归在「推理、部署与算力」这一层。

覆盖缓存并发部署微服务

适合要把模型跑起来,还得跑得起的人

目录骨架(8 节)
  1. 从 0 到 1 手写实现一个分布式 RPC 框架
  2. 四整体架构
  3. 8 个线程发起 10000 个请求
  4. 100 个线程发起 10000 个请求
  5. 一什么是 RPC
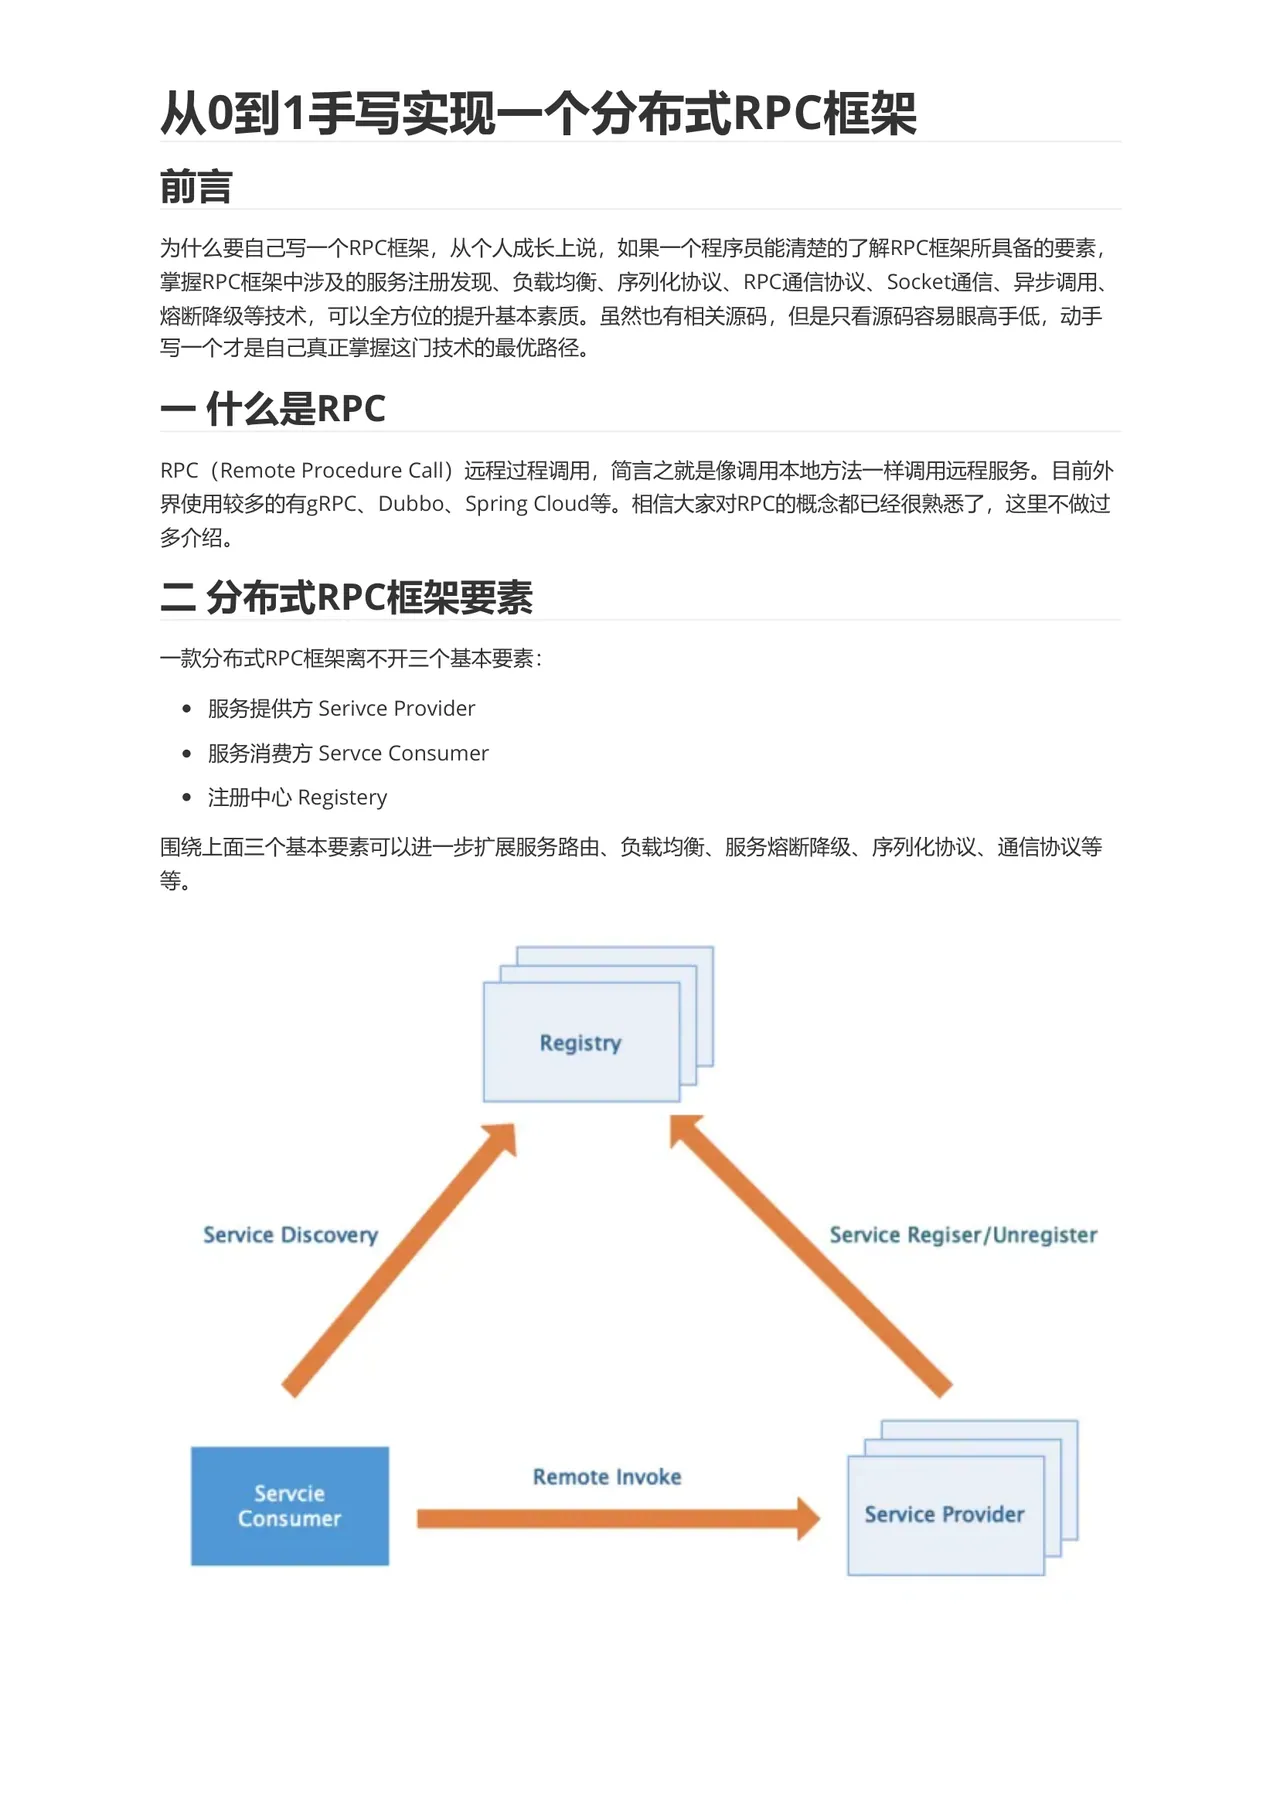
  6. 二分布式 RPC 框架要素
  7. 210 通信框架
  8. 1 服务注册发现

原 PDF 已逐页还原成图,共 20 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01从 0 到 1 手写实现一个分布式 RPC 框架
  2. 021 注册中心
  3. 03因为 TCP 是面向流,没有边界,而…
011 / 3
第 1 页:从 0 到 1 手写实现一个分布式 RPC 框架
第 1 页

从 0 到 1 手写实现一个分布式 RPC 框架

前言

为什么要自己写一个 RPC 框架,从个人成长上说,如果一个程序员能清楚的了解 RPC 框架所具备的要素, 掌握 RPC 框架中涉及的服务注册发现、负载均衡、序列化协议、RPC 通信协议、Socket 通信、异步调用、 熔断降级等技术,可以全方位的提升基本素质。虽然也有相关源码,但是只看源码容易眼高手低,动手 写一个才是自己真正掌握这门技术的最优路径。

一什么是 RPC

RPC (Remote Procedure Call)远程过程调用,简言之就是像调用本地方法一样调用远程服务。目前外 界使用较多的有 gRPC、Dubbo、Spring Cloud 等。相信大家对 RPC 的概念都已经很熟悉了,这里不做过 多介绍。

二分布式 RPC 框架要素

  • 一款分布式 RPC 框架离不开三个基本要素:
  • 服务提供方 Serivce Provider
  • 服务消费方 Servce Consumer
  • 注册中心 Registery 围绕上面三个基本要素可以进一步扩展服务路由、负载均衡、服务熔断降级、序列化协议、通信协议等

Service Discovery

Servcie Consumer

Registry

Remote Invoke

Service Regiser/Unregister

Service Provider

022 / 3
第 2 页
第 2 页

1 注册中心

1 注册中心

主要是用来完成服务注册和发现的工作。虽然服务调用是服务消费方直接发向服务提供方的,但是现在 服务都是集群部署,服务的提供者数量也是动态变化的,所以服务的地址也就无法预先确定。因此如何 发现这些服务就需要一个统一注册中心来承载。

2 服务提供方(RPC 服务端) 其需要对外提供服务接口,它需要在应用启动时连接注册中心,将服务名及其服务元数据发往注册中 心。同时需要提供服务服务下线的机制。需要维护服务名和真正服务地址映射。服务端还需要启动 Socket 服务监听客户端请求。

3 服务消费方(RPC 客户端) 客户端需要有从注册中心获取服务的基本能力,它需要在应用启动时,扫描依赖的 RPC 服务,并为其生成 代理调用对象,同时从注册中心拉取服务元数据存入本地缓存,然后发起监听各服务的变动做到及时更 新缓存。在发起服务调用时,通过代理调用对象,从本地缓存中获取服务地址列表,然后选择一种负载 均衡策略筛选出一个目标地址发起调用。调用时会对请求数据进行序列化,并采用一种约定的通信协议 进行 socket 通信。

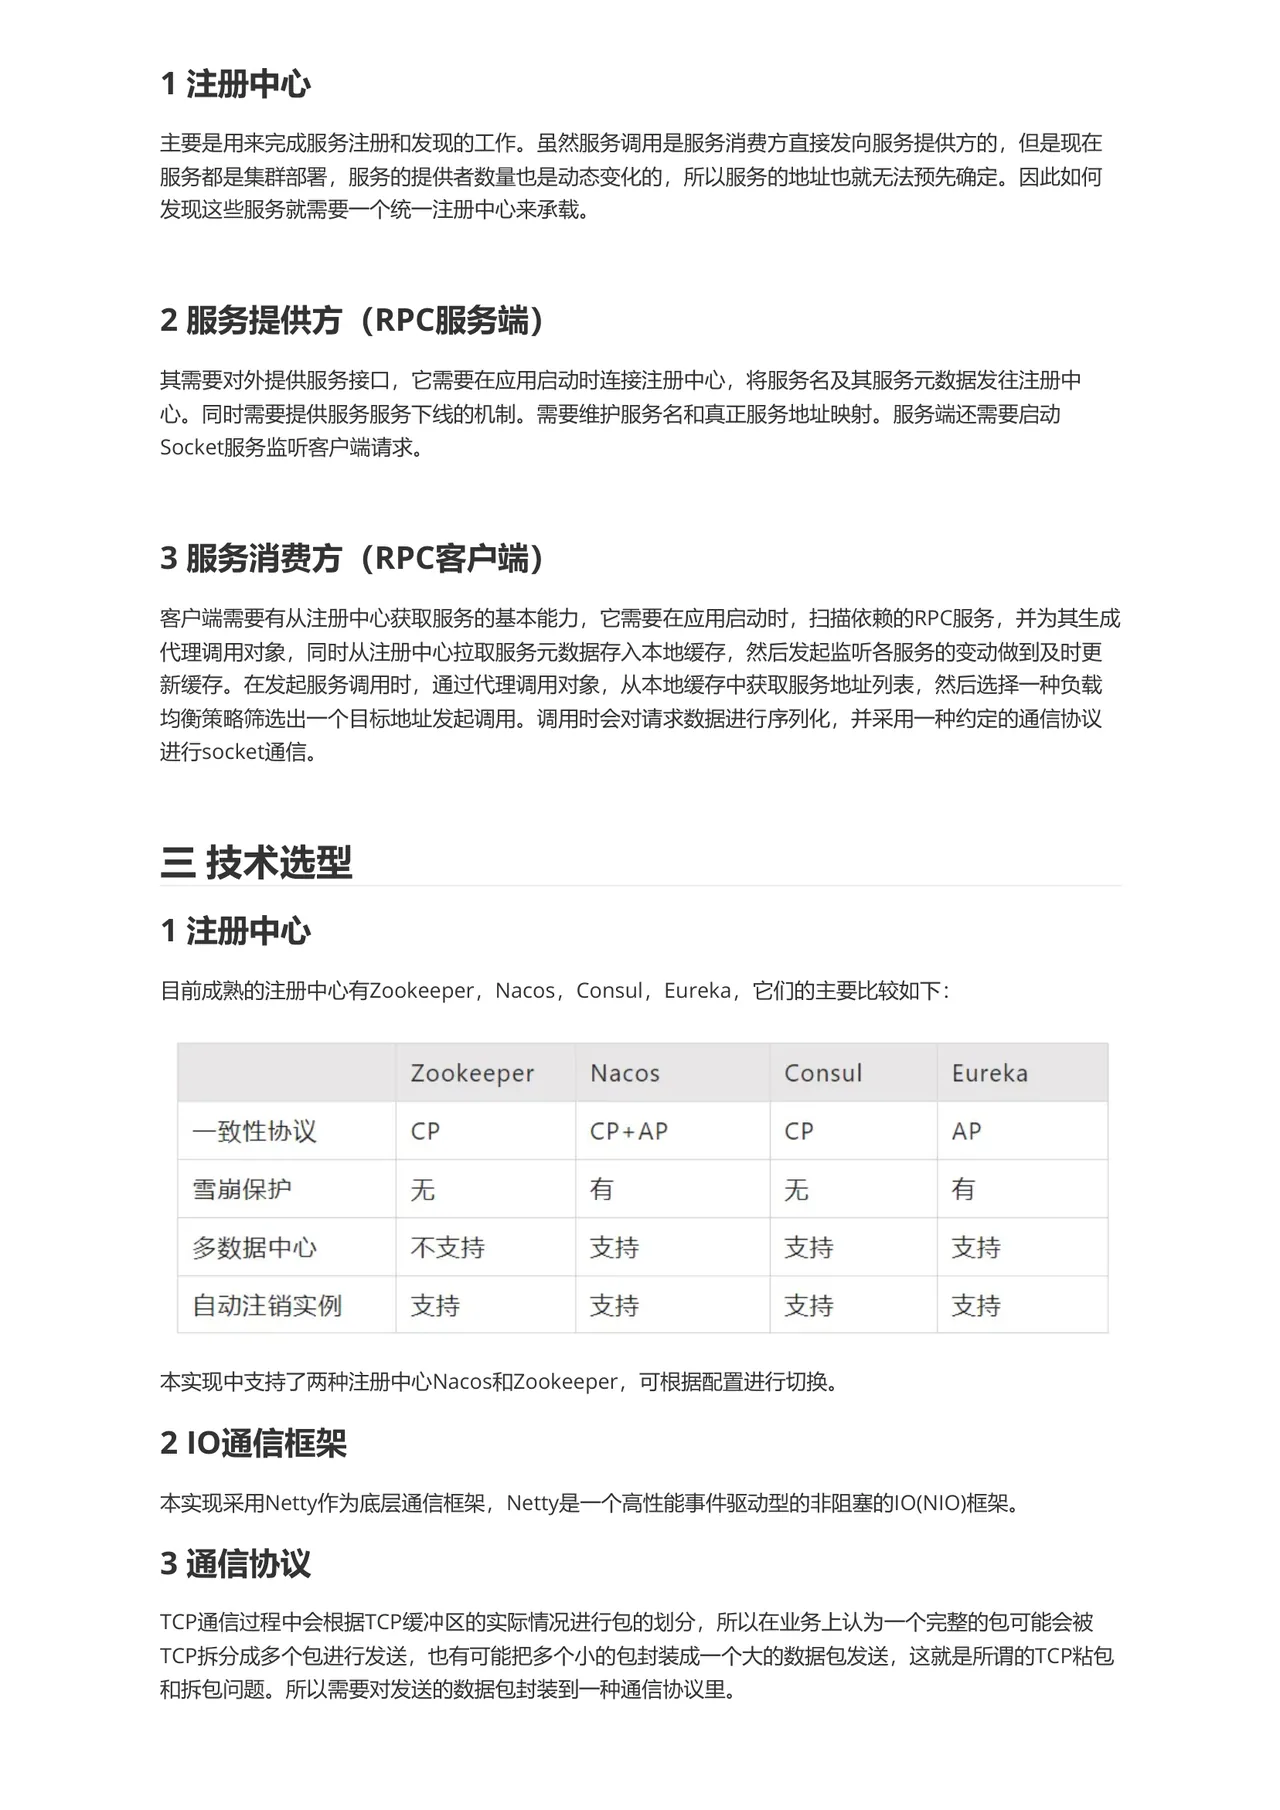
三技术选型 1 注册中心 目前成熟的注册中心有 Zookeeper,Nacos,Consul,Eureka,它们的主要比较如下:

一致性协议 雪崩保护 多数据中心 自动注销实例

本实现中支持了两种注册中心 Nacos 和 Zookeeper,可根据配置进行切换。

210 通信框架

本实现采用 Netty 作为底层通信框架,Netty 是一个高性能事件驱动型的非阻塞的 IO (NIO)框架。 3 通信协议 TCP 通信过程中会根据 TCP 缓冲区的实际情况进行包的划分,所以在业务上认为一个完整的包可能会被 TCP 拆分成多个包进行发送,也有可能把多个小的包封装成一个大的数据包发送,这就是所谓的 TCP 粘包 和拆包问题。所以需要对发送的数据包封装到一种通信协议里。

Zookeeper CP 无 不支持 支持

Consul CP

无 支持 支持

Eureka AP 有 支持 支持

Nacos CP+AP 有 支持 支持

033 / 3
第 3 页
第 3 页

因为 TCP 是面向流,没有边界,而…

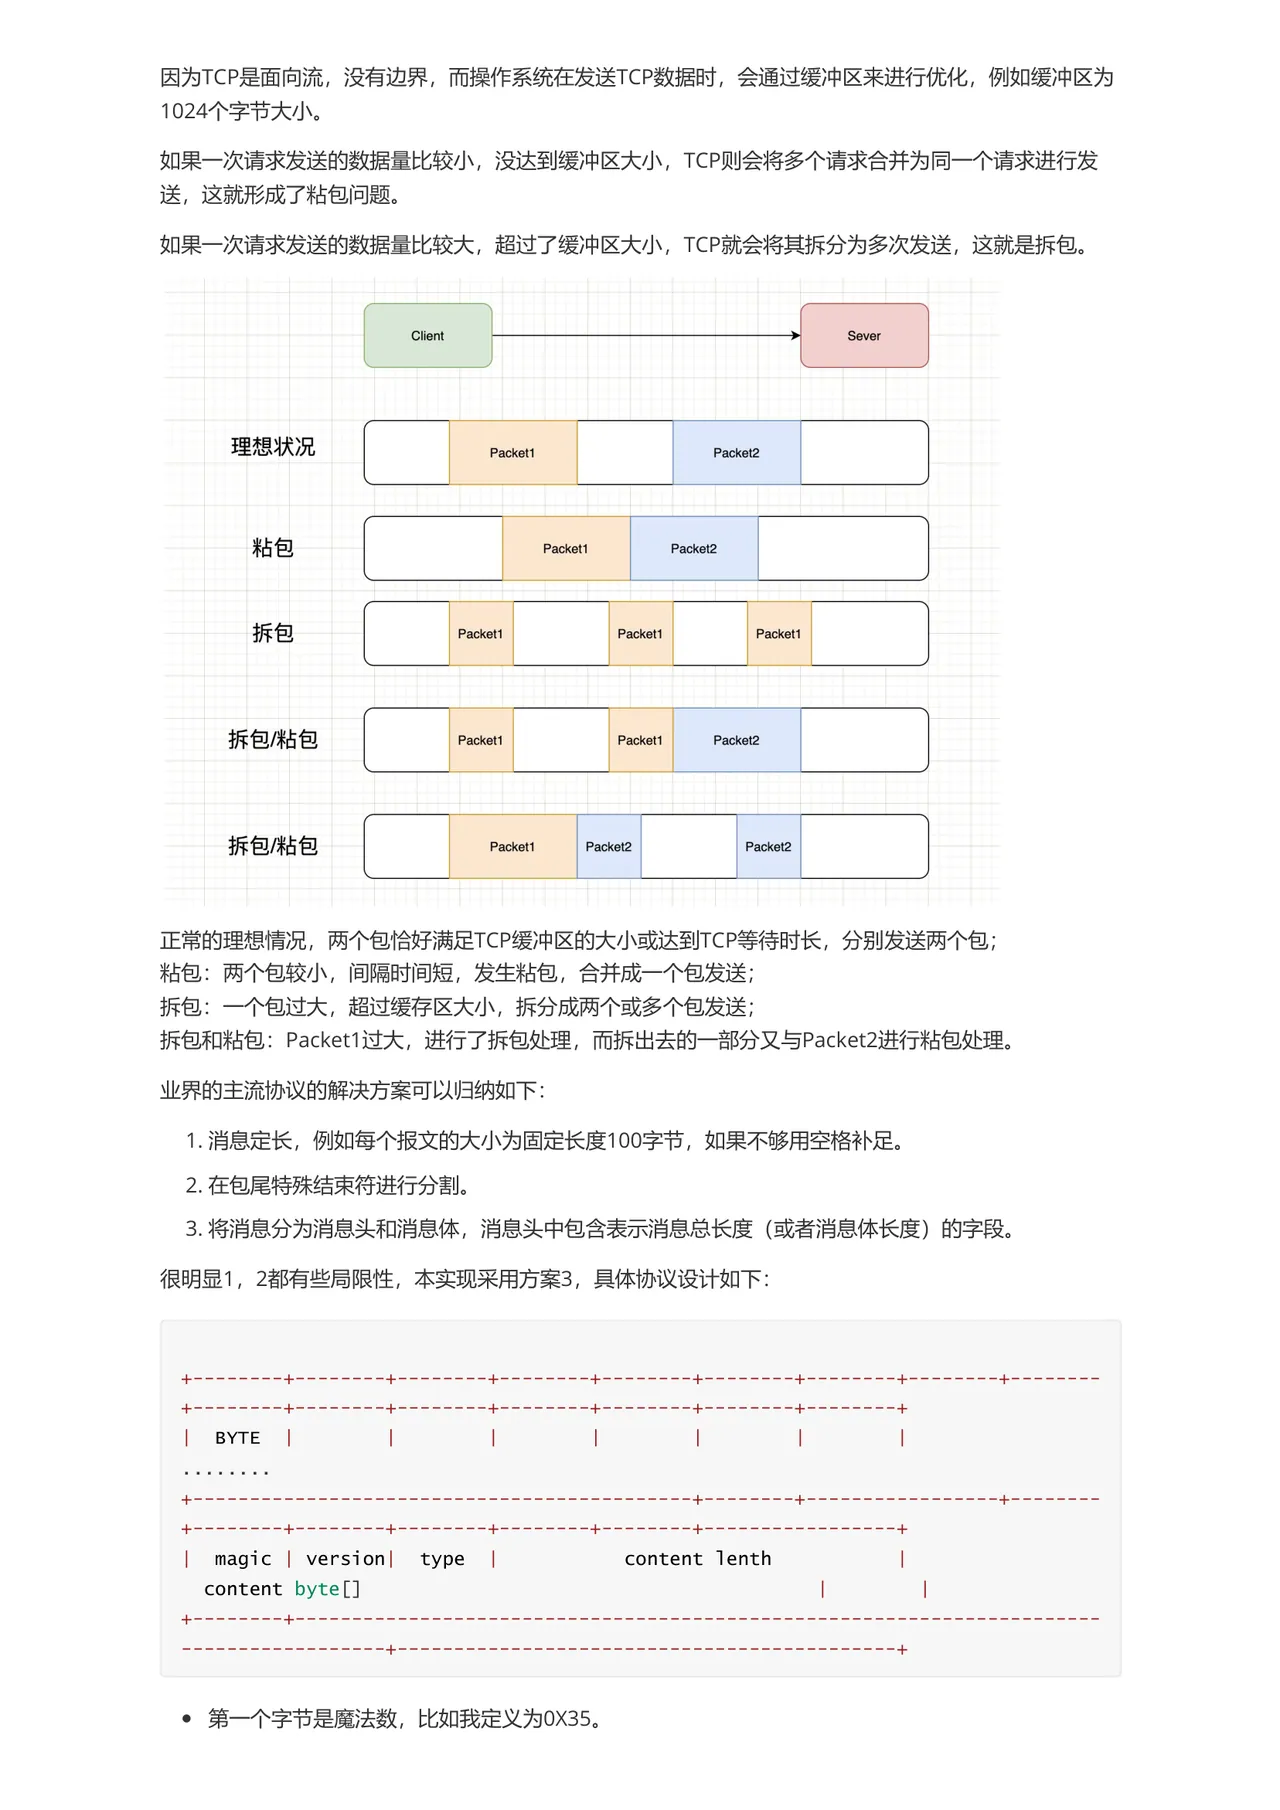
因为 TCP 是面向流,没有边界,而操作系统在发送 TCP 数据时,会通过缓冲区来进行优化,例如缓冲区为 1024 个字节大小。 如果一次请求发送的数据量比较小,没达到缓冲区大小,TCP 则会将多个请求合并为同一个请求进行发 送,这就形成了粘包问题。 如果一次请求发送的数据量比较大,超过了缓冲区大小,TCP 就会将其拆分为多次发送,这就是拆包。

理想状况

粘包

拆包

拆包/粘包

拆包/粘包

正常的理想情况,两个包恰好满足 TCP 缓冲区的大小或达到 TCP 等待时长,分别发送两个包; 粘包:两个包较小,间隔时间短,发生粘包,合并成一个包发送; 拆包:一个包过大,超过缓存区大小,拆分成两个或多个包发送; 拆包和粘包:Packet1 过大,进行了拆包处理,而拆出去的一部分又与 Packet2 进行粘包处理。 业界的主流协议的解决方案可以归纳如下: 1.消息定长,例如每个报文的大小为固定长度 100 字节,如果不够用空格补足。 2.在包尾特殊结束符进行分割。 3. 将消息分为消息头和消息体,消息头中包含表示消息总长度(或者消息体长度)的字段。 很明显 1,2 都有些局限性,本实现采用方案 3,具体协议设计如下:

BYTE

magic | version| content byte []

• 第一个字节是魔法数,比如我定义为 0X35。

Sever

Packet2

Packet1

Packet2

Packet2

content lenth

Packetl

type

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求