RAG 与知识库图文讲义1986 字

向量化和词嵌入的区别是什么

·全库 33 / 611

《向量化和词嵌入的区别是什么》共 20 页、0.2 万字,通篇围绕 向量、embedding、量化、Transformer 展开,归在「RAG 与知识库」这一层。

覆盖向量embedding量化Transformer上下文多模态

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(8 节)
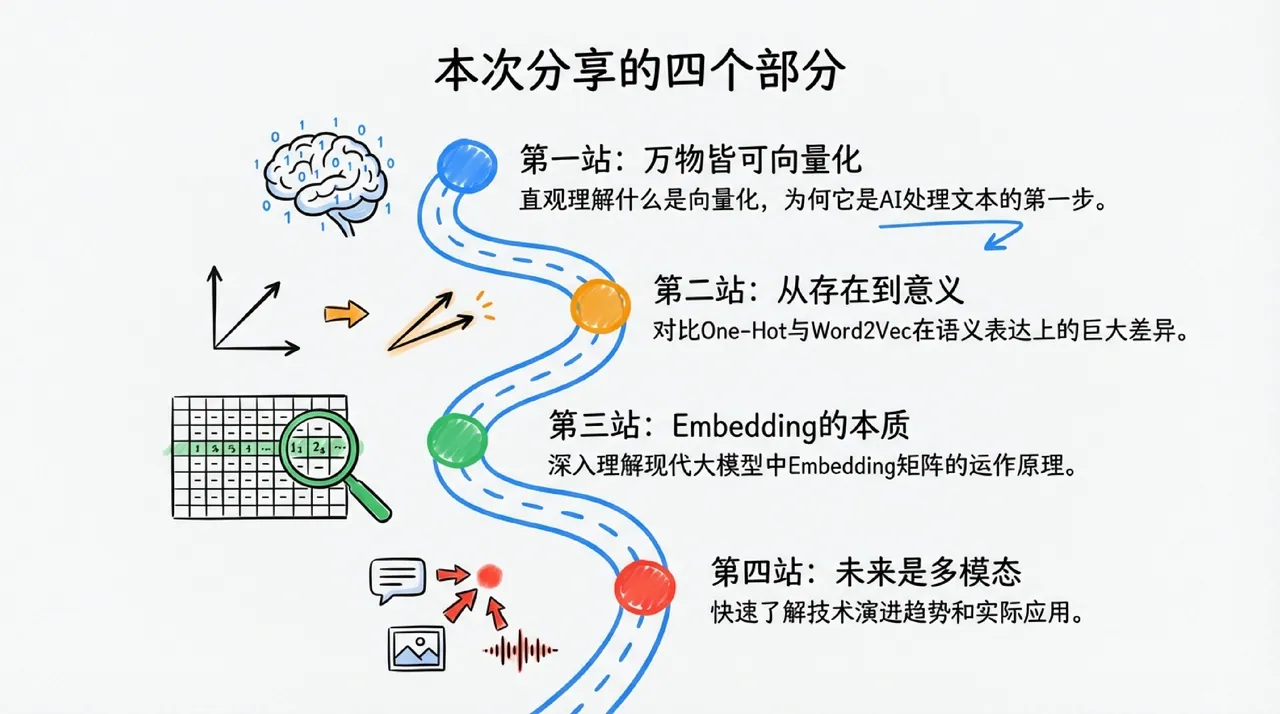
  1. 本次分享的四个部分
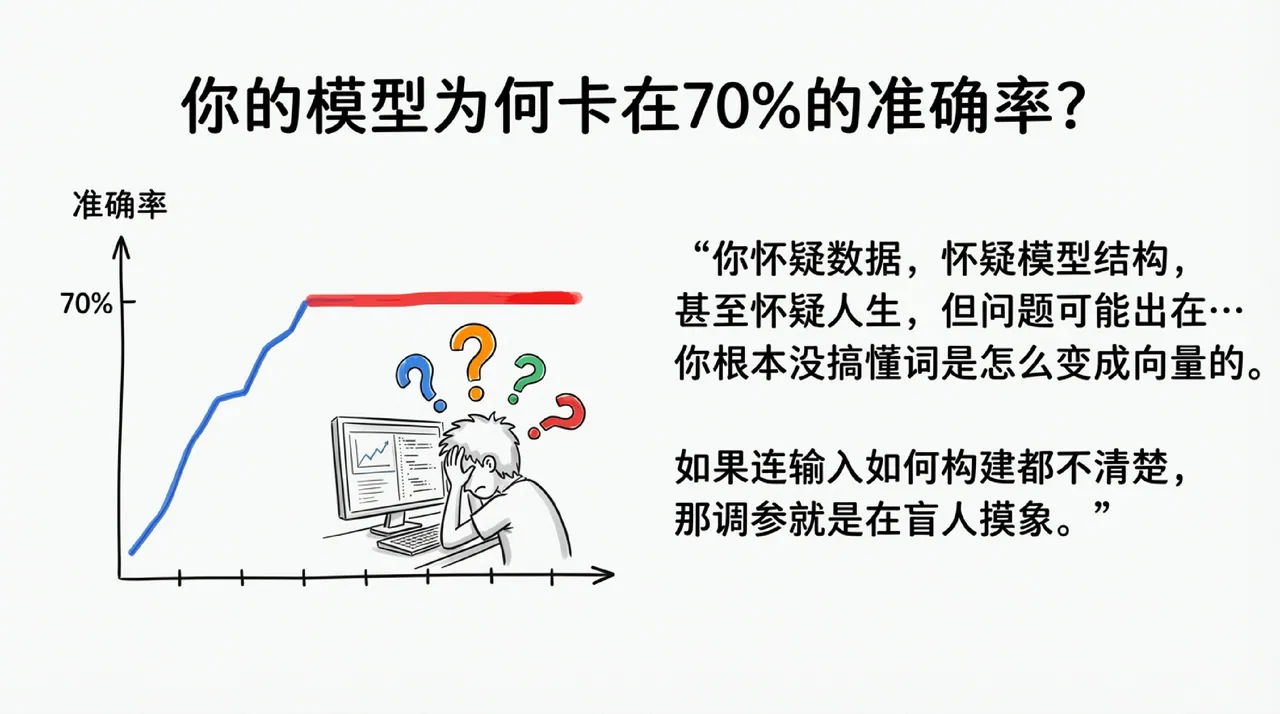
  2. 你的模型为何卡在 70%的准确率?
  3. 维度的力量:让复杂问题变简单
  4. One-Hot 的困境:维度灾难
  5. 迎来转机:Word2Vec 与“猜词游戏”
  6. king - man + woman ~ queen
  7. 构建一个语义空间(Semantic Space)
  8. Embedding 矩阵:一个巨大的查找表

原 PDF 已逐页还原成图,共 20 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01向量化和词嵌入的区别是什么?
  2. 02本次分享的四个部分
  3. 03你的模型为何卡在 70%的准确率?
011 / 3
第 1 页
第 1 页

向量化和词嵌入的区别是什么?

向量化和词嵌入的区别是什么?

从 One-Hot 到 Transformer,深入理解 AI 如何读懂语言

022 / 3
第 2 页:本次分享的四个部分
第 2 页

本次分享的四个部分

第一站:万物皆可向量化 直观理解什么是向量化,为何它是 AI 处理文本的第一步。 第二站:从存在到意义 对比 One-Hot 与 Word2Vec 在语义表达上的巨大差异。

第三站:Embedding 的本质 深入理解现代大模型中 Embedding 矩阵的运作原理。

第四站:未来是多模态 快速了解技术演进趋势和实际应用。

033 / 3
第 3 页:你的模型为何卡在 70%的准确率?
第 3 页

你的模型为何卡在 70%的准确率?

准确率

“你怀疑数据,怀疑模型结构, 甚至怀疑人生,但问题可能出在⋯ 你根本没搞懂词是怎么变成向量的。 如果连输入如何构建都不清楚, 那调参就是在盲人摸象。”

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求