RAG 与知识库图文讲义3301 字

RAG十种优化技巧

·全库 40 / 611

《RAG十种优化技巧》共 17 页、0.3 万字,通篇围绕 检索、向量、RAG、召回 展开,归在「RAG 与知识库」这一层。

覆盖检索向量RAG召回上下文rerank

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(8 节)
  1. RAG 十种优化技巧
  2. 一切的起点:标准 RAG 的工作流
  3. 标准 RAG 的挑战:我们为何需要优化?
  4. 核心思想:“小块检索,大块生成”(Small-to-Big)
  5. 技巧 3:句子窗口检索(Sentence-Window Retrieval)
  6. 技巧 4:多路召回(Multi-path Recal)
  7. 技巧 5:精排(Rerank)- 双层筛选,去粗取精
  8. 技巧 6:查询改写(Query Rewriting)- 更好地理解用户意图

原 PDF 已逐页还原成图,共 17 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01RAG 十种优化技巧
  2. 02我们将要探索的路径:RAG 工程师的…
  3. 03一切的起点:标准 RAG 的工作流
011 / 3
第 1 页:RAG 十种优化技巧
第 1 页

RAG 十种优化技巧

从能用到好用:一位 RAG 工程师的进阶之路

RAG 不是算法问题,是工程问题

022 / 3
第 2 页
第 2 页

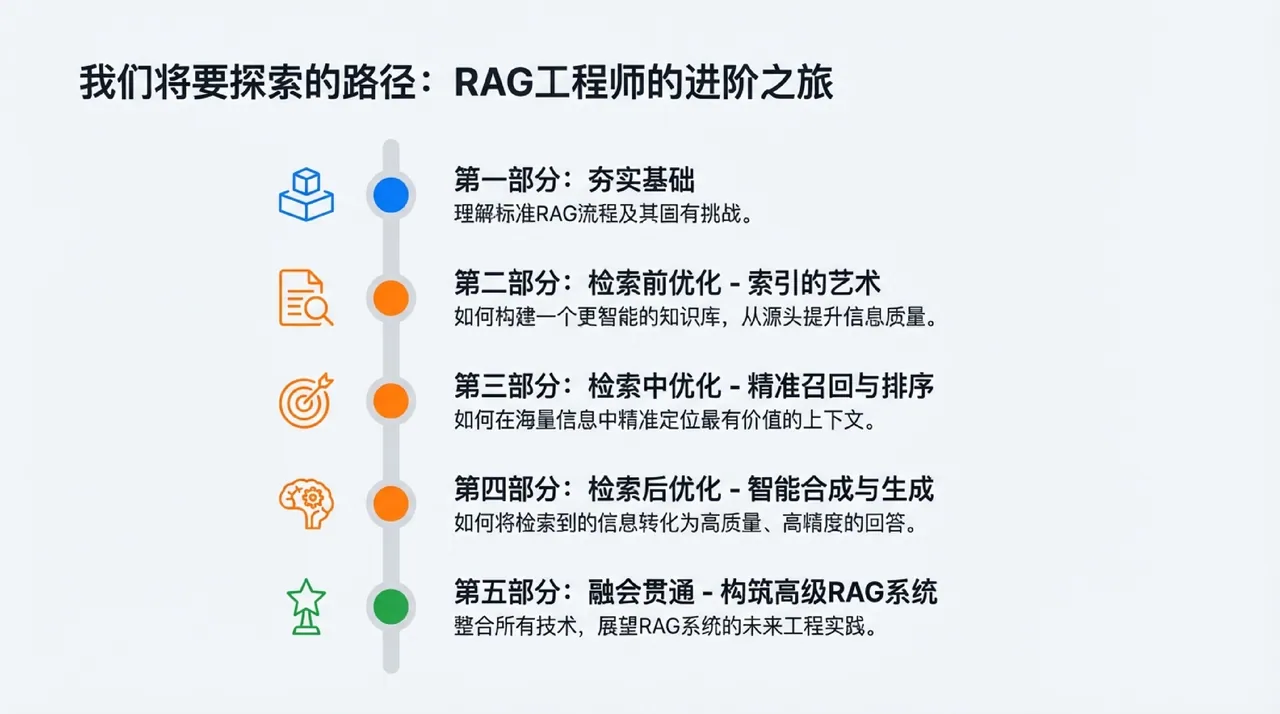
我们将要探索的路径:RAG 工程师的…

我们将要探索的路径:RAG 工程师的进阶之旅

第一部分:夯实基础 理解标准 RAG 流程及其固有挑战。 第二部分:检索前优化 - 索引的艺术 如何构建一个更智能的知识库,从源头提升信息质量。 第三部分:检索中优化- 精准召回与排序 如何在海量信息中精准定位最有价值的上下文。 第四部分:检索后优化- 智能合成与生成 如何将检索到的信息转化为高质量、高情度的回答。 第五部分:融会贯通- 构筑高级 RAG 系统 整合所有技术,展望 RAG 系统的未来工程实践。

033 / 3
第 3 页:一切的起点:标准 RAG 的工作流
第 3 页

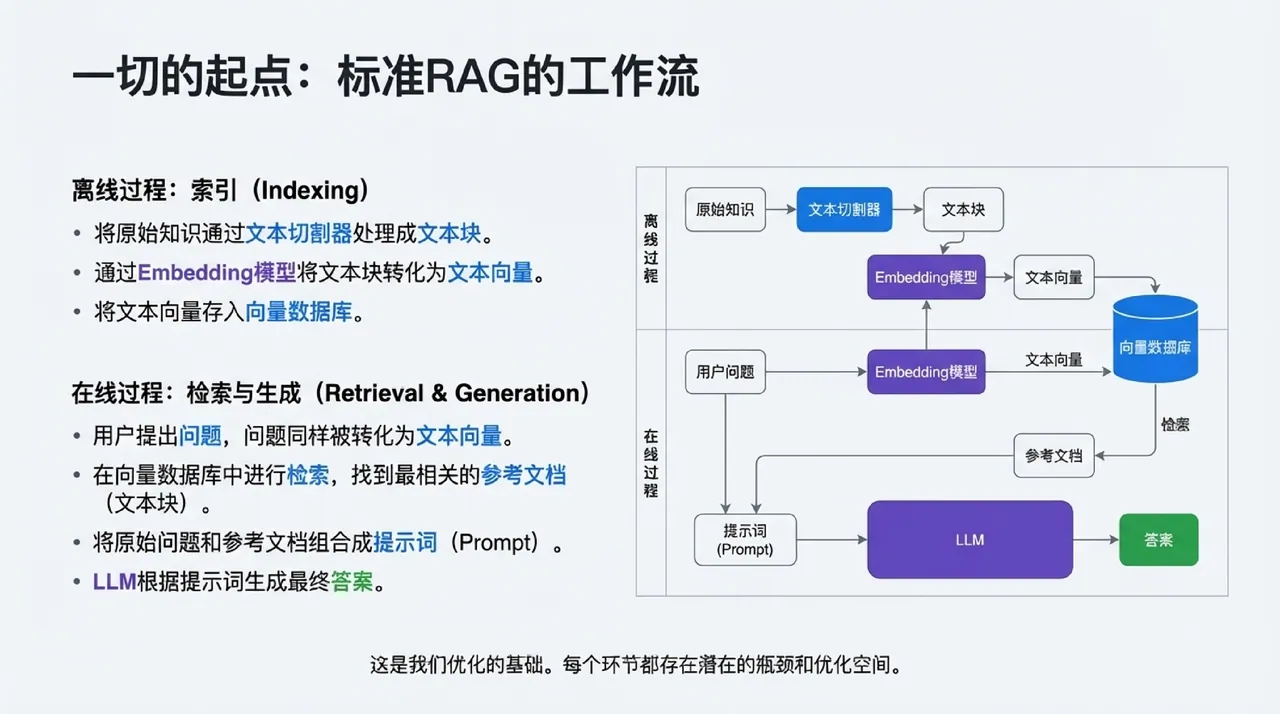
一切的起点:标准 RAG 的工作流

  • 离线过程:索引(Indexing)
  • 将原始知识通过文本切割器处理成文本块。
  • 通过 Embedding 模型将文本块转化为文本向量。
  • 将文本向量存入向量数据库。
  • 在线过程:检索与生成(Retrieval & Generation)
  • 用户提出问题,问题同样被转化为文本向量。
  • 在向量数据库中进行检索,找到最相关的参考文档 (文本块)。
  • 将原始问题和参考文档组合成提示词(Prompt)。
  • LLM 根据提示词生成最终答案。

文本块

文本向量 Embedding 模型

文本向量 Embedding 模型

原始知识

用户问题

提示词 (Prompt)

这是我们优化的基础。每个环节都存在潜在的瓶颈和优化空间。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求