RAG 与知识库图文讲义1288 字

Rerank模型深度讲解

·全库 36 / 611

《Rerank模型深度讲解》共 20 页、0.1 万字,通篇围绕 rerank、embedding、Attention、Transformer 展开,归在「RAG 与知识库」这一层。

覆盖rerankembeddingAttentionTransformer召回重排

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(8 节)
  1. Rerank 模型深度讲解:RAG 系统的“精挑细选”
  2. 本节课程核心大纲
  3. 为什么准确率至关重要?一个医疗场景的警示
  4. Rerank 在 RAG 流程中的定位
  5. 通俗理解:外卖点餐的比喻
  6. Embedding 的局限性(1):语义理解有限
  7. Embedding 的局限性(2):维度限制
  8. Embedding 的局限性(3):泛化能力弱

原 PDF 已逐页还原成图,共 20 页,这里先放前 3 页,其中 3 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01Rerank 模型深度讲解:RAG 系统的“精挑细选”
  2. 02本节课程核心大纲
  3. 03为什么准确率至关重要?一个医疗场景的警示
011 / 3
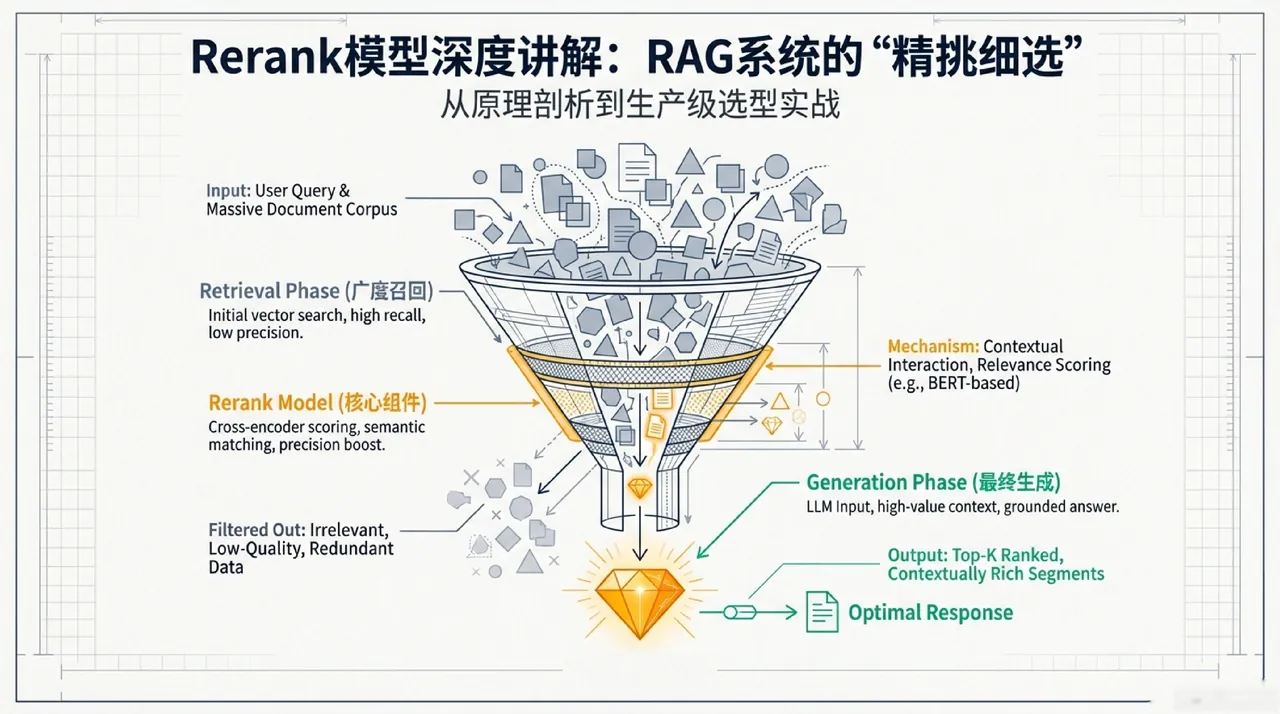
第 1 页:Rerank 模型深度讲解:RAG 系统的“精挑细选”
第 1 页

Rerank 模型深度讲解:RAG 系统的“精挑细选”

从原理剖析到生产级选型实战

Input: User Query & Massive Document Corpus

Retrieval Phase (广度召回) Initial vector search, high recall, low precision.

Rerank Model (核心组件) Cross-encoder scoring, semantic matching, precision boost.

Filtered Out: Irrelevant, Low-Quality, Redundant

Data

Mechanism: Contextual Interaction, Relevance Scoring (e.g, BERT-based)

Generation Phase (最终生成) LLM Input, high-value context, grounded answer. Output: Top-K Ranked, Contextually Rich Segments Optimal Response

022 / 3
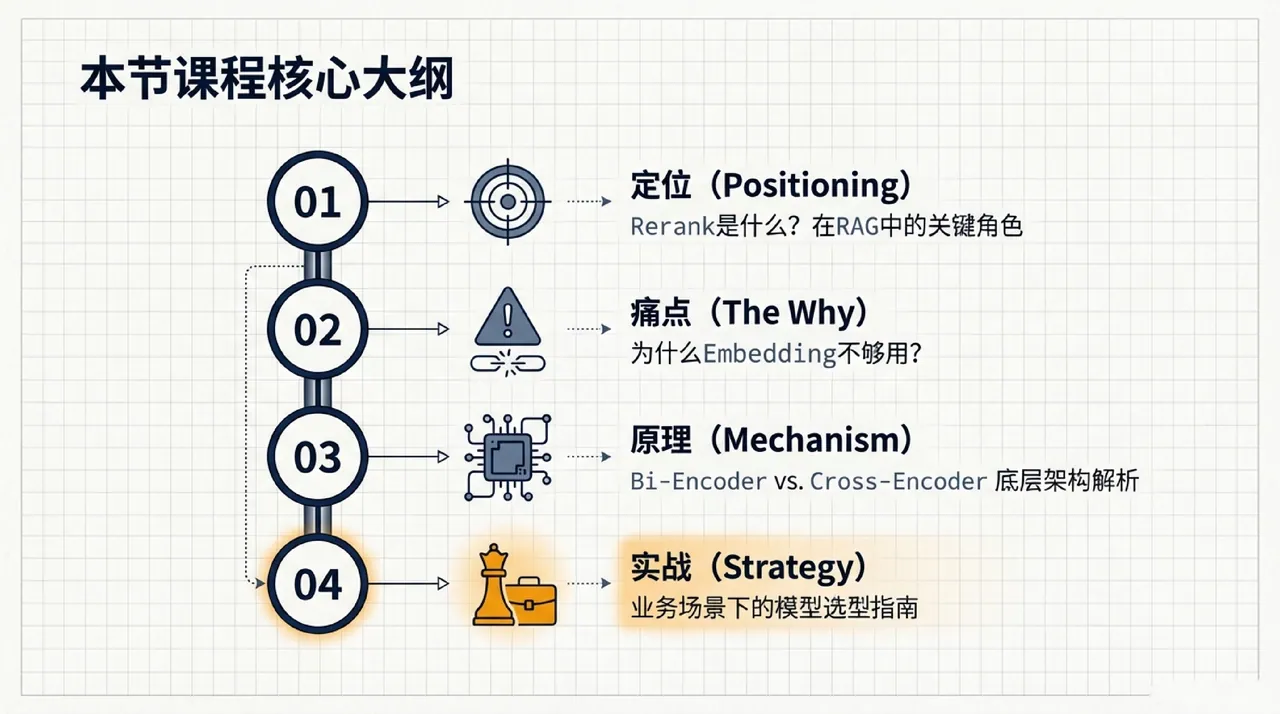
第 2 页:本节课程核心大纲
第 2 页

本节课程核心大纲

定位(Positioning) Rerank 是什么?在 RAG 中的关键角色

痛点(The Why) 为什么 Embedding 不够用?

原理(Mechanism) Bi-Encoder vs. Cross-Encoder 底层架构解析

实战(Strategy)

业务场景下的模型选型指南

033 / 3
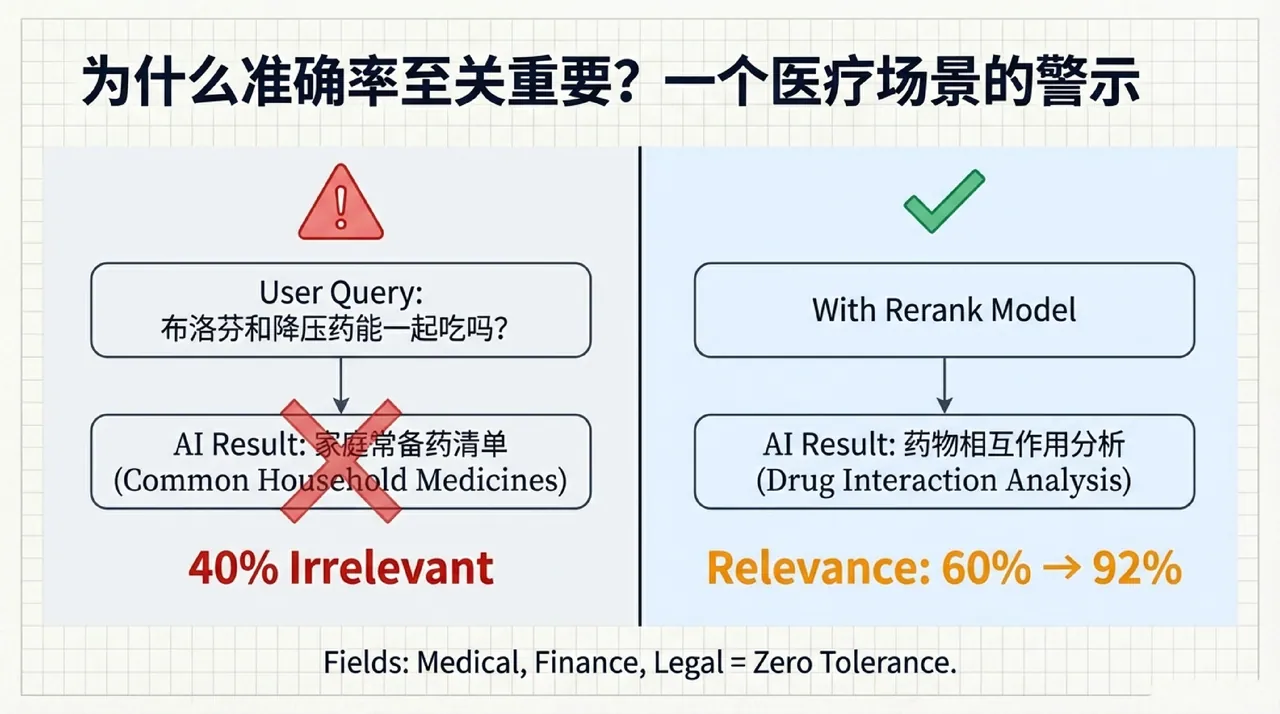
第 3 页:为什么准确率至关重要?一个医疗场景的警示
第 3 页

为什么准确率至关重要?一个医疗场景的警示

User Query:

布洛芬和降压药能一起吃吗?

家庭常备药清单 AI Result: (Common Household Medicines)

40% Irrelevant Fields: Medical, Finance, Legal = Zero Tolerance.

With Rerank Model

AI Result:药物相互作用分析 (Drug Interaction Analysis)

Relevance: 60% -92%

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求