推理、部署与算力图文讲义2244 字

DeepSpeed大模型分布式框架

·全库 55 / 611

《DeepSpeed大模型分布式框架》共 13 页、0.2 万字,通篇围绕 GPU、显存、吞吐、需求 展开,归在「推理、部署与算力」这一层。

覆盖GPU显存吞吐需求Attention推理

适合要把模型跑起来,还得跑得起的人

目录骨架(8 节)
  1. DeepSpeed 大模
  2. 核心挑战:AI 模型的“内存墙"
  3. DeepSpeed:为超大规模 AI 模型而生的分布式训练框架
  4. 基础并行策略:数据并行(DDP)
  5. DeepSpeed 核心创新:ZeRO
  6. ZeRO 详解:Stage 1 & Stage
  7. ZeRO 详解:Stage 3 与 Offload 技术
  8. 实战演练:通过'ds_config.json'启用 ZeRO

原 PDF 已逐页还原成图,共 13 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01DeepSpeed 大模
  2. 02本次分享大纲
  3. 03核心挑战:AI 模型的“内存墙"
011 / 3
第 1 页:DeepSpeed 大模
第 1 页

DeepSpeed 大模

型分布式框架

挑战每天讲透一个 AI 大模型知识点

022 / 3
第 2 页
第 2 页

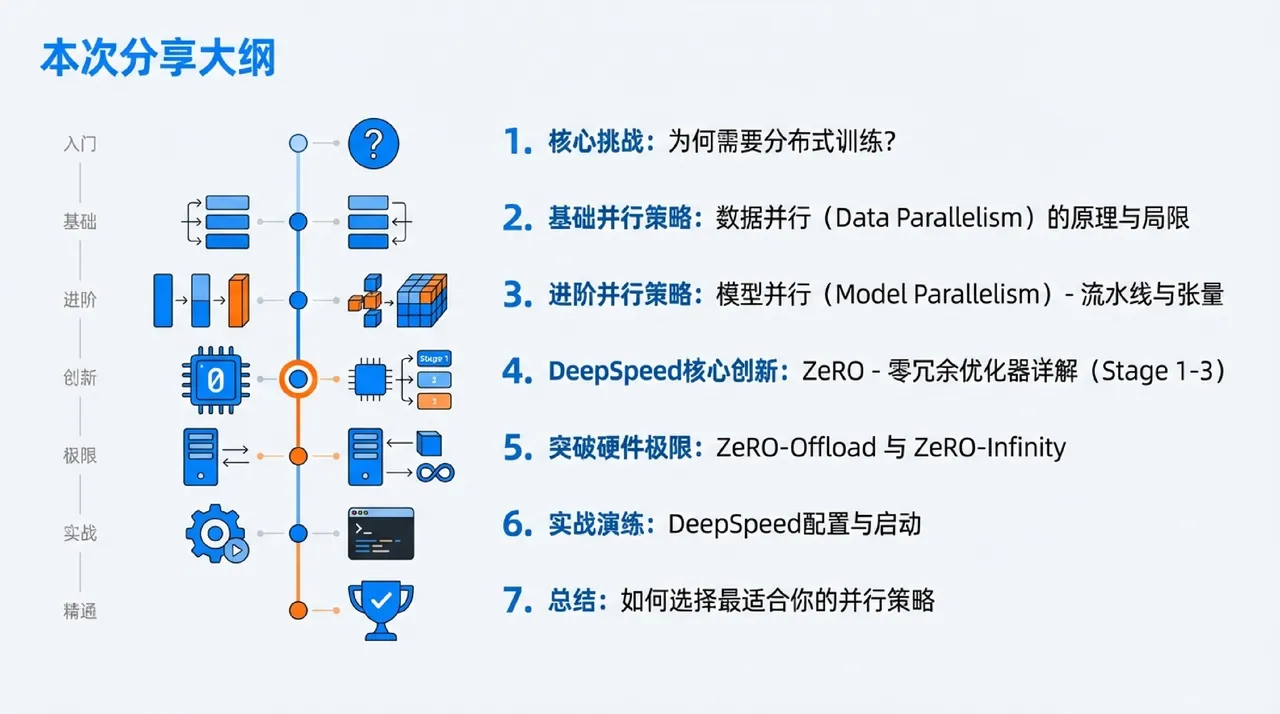
本次分享大纲

本次分享大纲

入门

基础

创新

实战

精通

  1. 核心挑战:为何需要分布式训练? 2. 基础并行策略:数据并行(Data Parallelism)的原理与局限 3. 进阶井行策略:模型并行(Model Parallelism)-流水线与张量 4. DeepSpeed 核心创新:ZeRO- 零冗余优化器详解(Stage 1-3) 5. 突破硬件极限:ZeRO-0ffload 与 ZeRO-Infinity 6. 实战演练:DeepSpeed 配置与启动 7. 总结:如何选择最适合你的并行策略
033 / 3
第 3 页:核心挑战:AI 模型的“内存墙"
第 3 页

核心挑战:AI 模型的“内存墙"

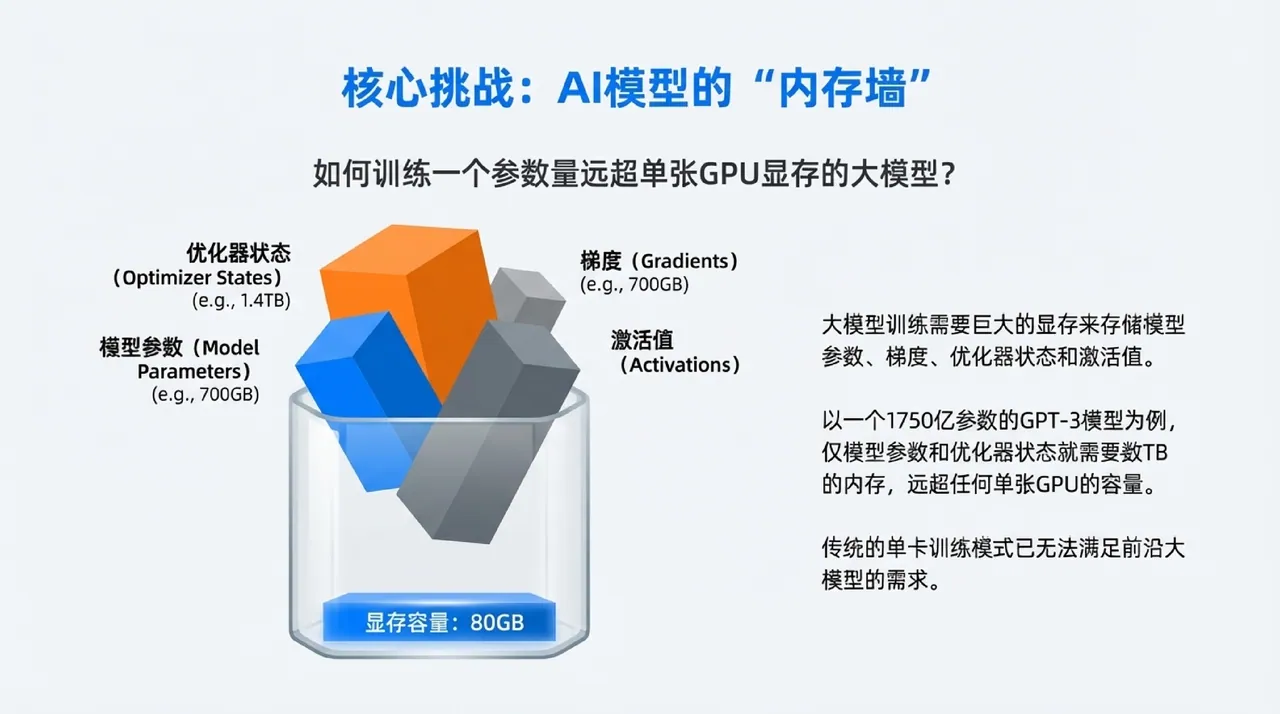
如何训练一个参数量远超单张 GPU 显存的大模型?

显存容量:80GB

优化器状态 (Optimizer States) (e.g.,1.4TB) 模型参数(Model Parameters) (e.g,700GB)

梯度(Gradients) (e.g,700GB)

(Activations)

大模型训练需要巨大的显存来存储模型 参数、梯度、优化器状态和激活值。 以一个 1750 亿参数的 GPT-3 模型为例, 仅模型参数和优化器状态就需要数 TB 的内存,远超任何单张 GPU 的容量。 传统的单卡训练模式已无法满足前沿大 模型的需求。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求