推理、部署与算力面试题图文讲义1872 字

大模型显存优化策略面试题

·全库 139 / 611

《大模型显存优化策略面试题》共 3 页、0.2 万字,通篇围绕 显存、需求、GPU、延迟 展开,归在「推理、部署与算力」这一层。

覆盖显存需求GPU延迟数据集

适合要把模型跑起来,还得跑得起的人

目录骨架(2 节)
  1. 显存优化策略篇
  2. labels)

原 PDF 已逐页还原成图,共 3 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01显存优化策略篇
  2. 02# weights update o…
  3. 03及使用更大批量的数据,而无需占用大量…
011 / 3
第 1 页
第 1 页

显存优化策略篇

  • 显存优化策略篇
  • 一、介绍一下 gradient accumulation 显存优化方式?
  • 二、介绍一下 gradient checkpointing 显存优化方式?
  • 致谢

一、介绍一下 gradient accumulation 显存优化方式?

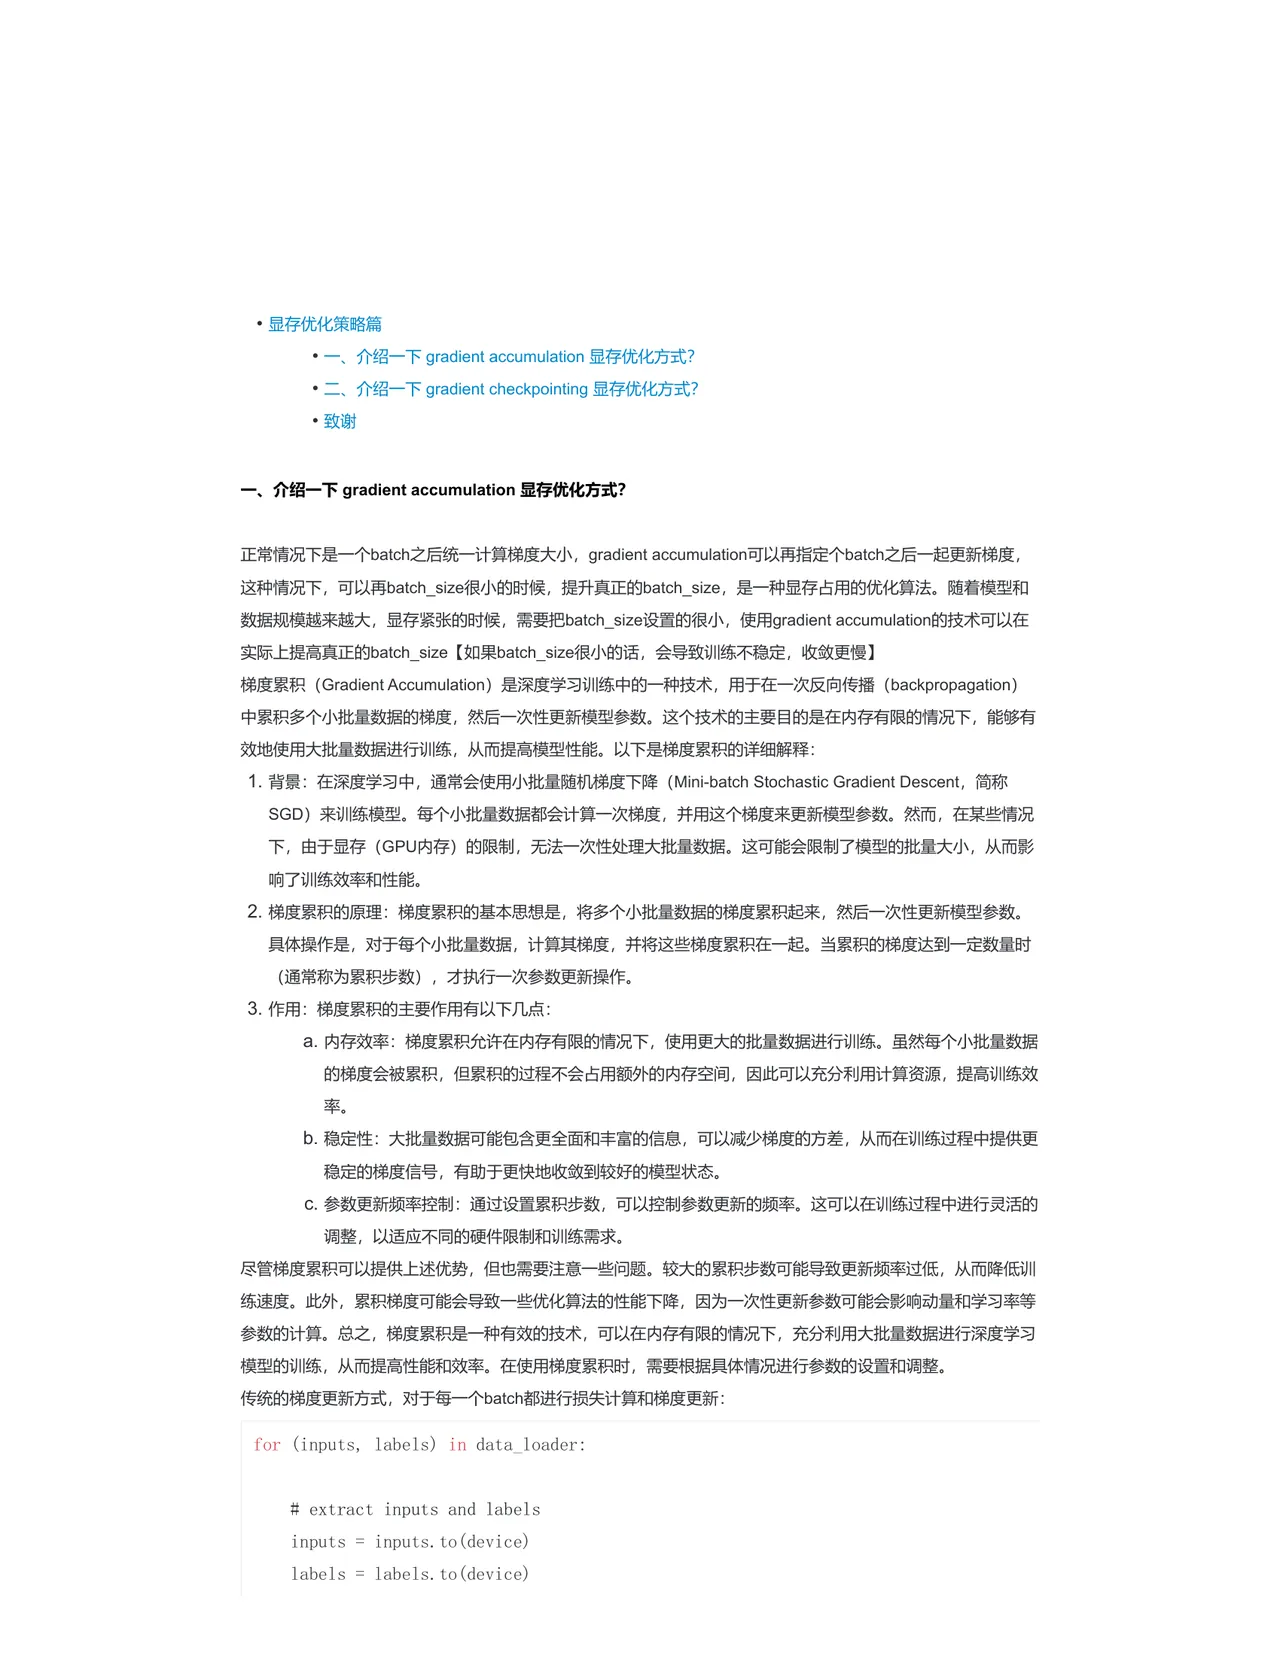
正常情况下是一个 batch 之后统一计算梯度大小,gradient accumulation 可以再指定个 batch 之后一起更新梯度, 这种情况下,可以再 batch_size 很小的时候,提升真正的 batch_size,是一种显存占用的优化算法。随看模型和 数据规模越来越大,显存紧张的时候,需要把 batch_size 设置的很小,使用 gradient accumulation 的技术可以在 实际上提高真正的 batch_size 【如果 batch_size 很小的话,会导致训练不稳定,收敛更慢】 梯度累积(Gradient Accumulation)是深度学习训练中的一种技术,用于在一次反向传播(backpropagation) 中累积多个小批量数据的梯度,然后一次性更新模型参数。这个技术的主要目的是在内存有限的情况下,能够有 效地使用大批量数据进行训练,从而提高模型性能。以下是梯度累积的详细解释: 1. 背景:在深度学习中,通常会使用小批量随机梯度下降(Mini-batch Stochastic Gradient Descent,简称 SGD)来训练模型。每个小批量数据都会计算一次梯度,并用这个梯度来更新模型参数。然而,在某些情况 下,由于显存(GPU 内存)的限制,无法一次性处理大批量数据。这可能会限制了模型的批量大小,从而影 响了训练效率和性能。 2. 梯度累积的原理:梯度累积的基本思想是,将多个小批量数据的梯度累积起来,然后一次性更新模型参数。 具体操作是,对于每个小批量数据,计算其梯度,并将这些梯度累积在一起。当累积的梯度达到一定数量时 (通常称为累积步数),才执行一次参数更新操作。 3. 作用:梯度累积的主要作用有以下几点: a. 内存效率:梯度累积允许在内存有限的情况下,使用更大的批量数据进行训练。虽然每个小批量数据 的梯度会被累积,但累积的过程不会占用额外的内存空间,因此可以充分利用计算资源,提高训练效 率。 b.稳定性:大批量数据可能包含更全面和丰富的信息,可以减少梯度的方差,从而在训练过程中提供更 稳定的梯度信号,有助于更快地收敛到较好的模型状态。 c.参数更新频率控制:通过设置累积步数,可以控制参数更新的频率。这可以在训练过程中进行灵活的 调整,以适应不同的硬件限制和训练需求。 尽管梯度累积可以提供上述优势,但也需要注意一些问题。较大的累积步数可能导致更新频率过低,从而降低训 练速度。此外,累积梯度可能会导致一些优化算法的性能下降,因为一次性更新参数可能会影响动量和学习率等 参数的计算。总之,梯度累积是一种有效的技术,可以在内存有限的情况下,充分利用大批量数据进行深度学习 模型的训练,从而提高性能和效率。在使用梯度累积时,需要根据具体情况进行参数的设置和调整。 传统的梯度更新方式,对于每一个 batch 都进行损失计算和梯度更新: for (inputs, labels)in data_loader:

# extract inputs and labels inputs = inputs. to (device) labels = labels.to (device)

022 / 3
第 2 页
第 2 页

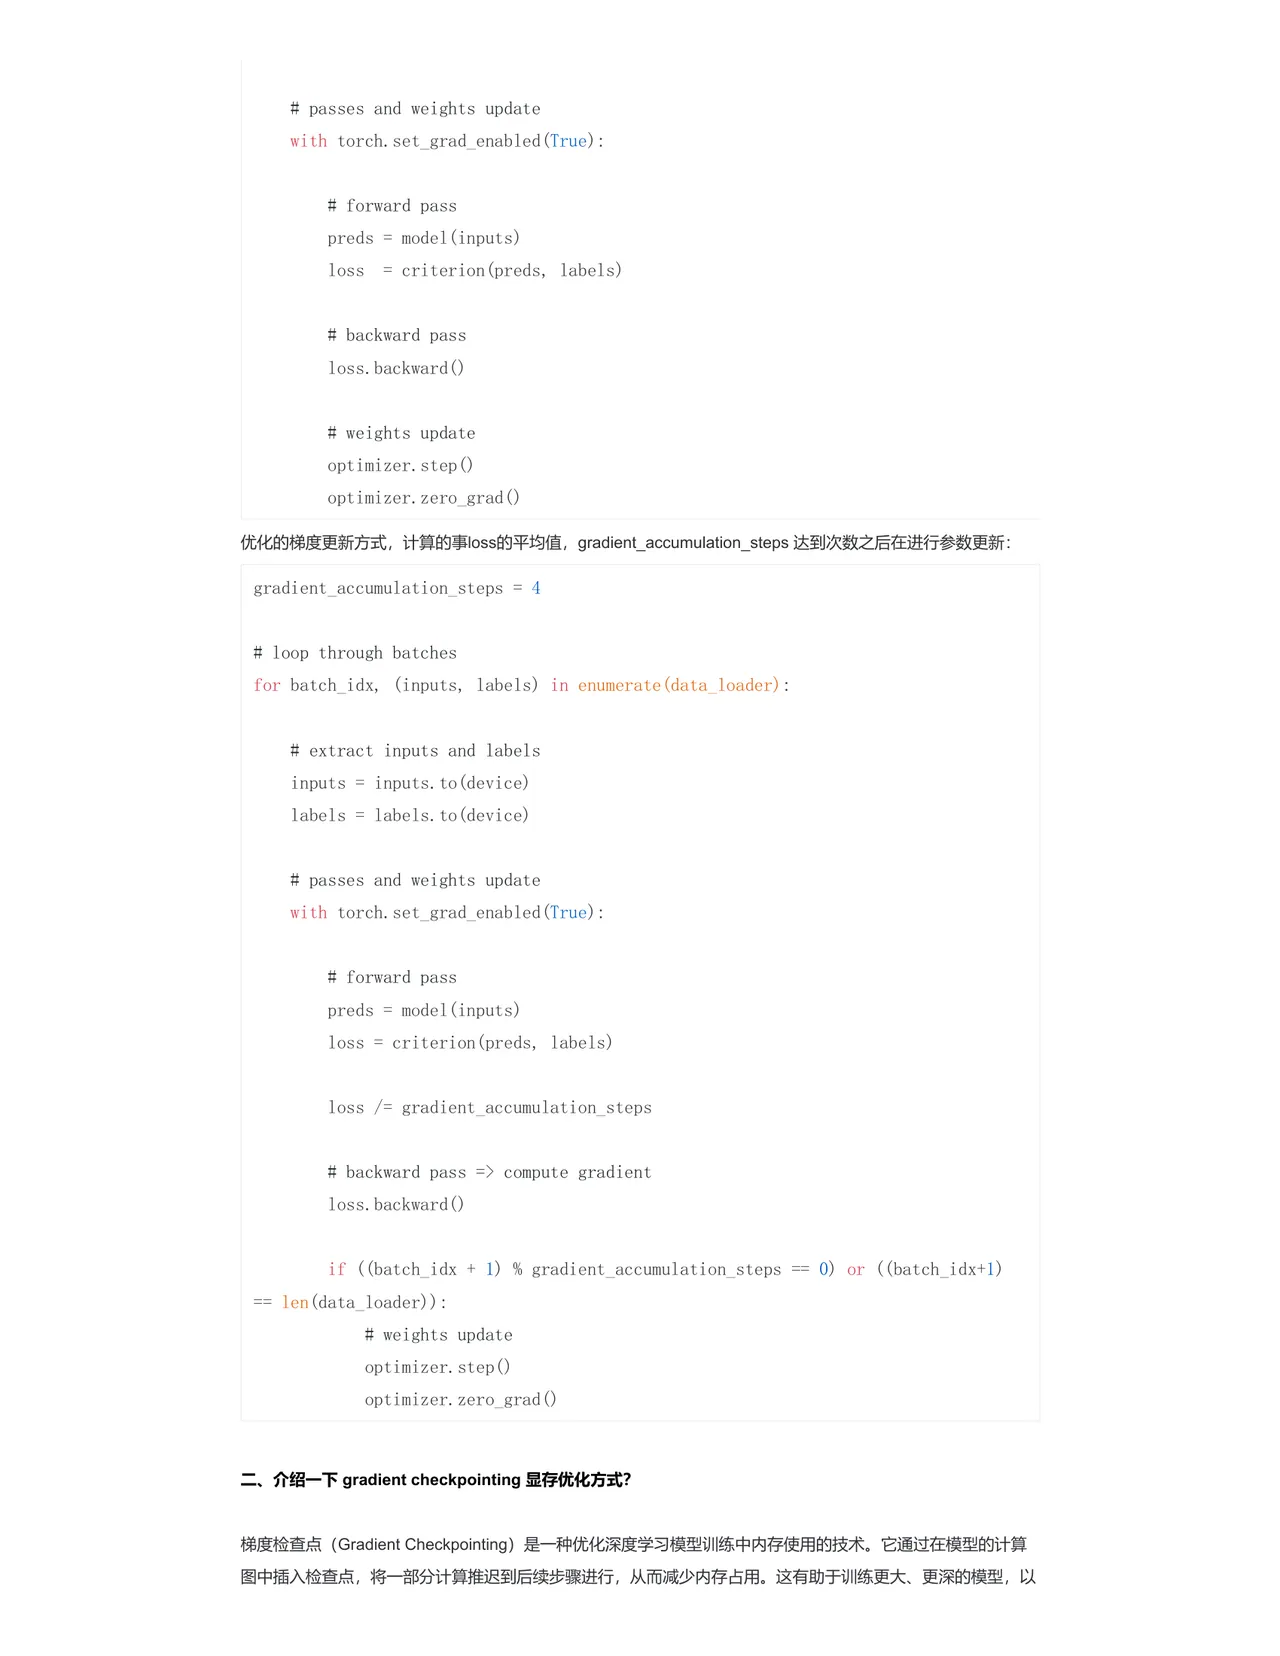
# weights update o…

# passes and weights update with torch.set_grad_enabled (True):

# forward pass preds = model (inputs) loss = criterion (preds, labels)

# backward pass loss. backward ()

# weights update optimizer.step () optimizer.zero_grad () 优化的梯度更新方式,计算的事 loss 的平均值,gradient_accumulation_steps 达到次数之后在进行参数更新: gradient_accumulation_steps =

# loop through batches for batch_idx,(inputs, in enumerate (data loader): labels)

# extract inputs and labels inputs = inputs. to (device) labels = labels. to (device)

# passes and weights update with torch.set_grad_enabled (True):

# forward pass preds = model (inputs) loss = criterion (preds,

labels)

loss /= gradient_accumulation_steps

# backward pass => compute gradient loss. backwardO

if ((batch_idx + 1)% gradient_accumulation_steps == 0)or ((batch_idx+1) == len (data_loader)): # weights update optimizer. step ( optimizer.zero gradO

二、介绍一下 gradient checkpointing 显存优化方式?

梯度检查点(Gradient Checkpointing)是一种优化深度学习模型训练中内存使用的技术。它通过在模型的计算 图中插入检查点,将一部分计算推迟到后续步骤进行,从而减少内存占用。这有助于训练更大、更深的模型,以

033 / 3
第 3 页
第 3 页

及使用更大批量的数据,而无需占用大量…

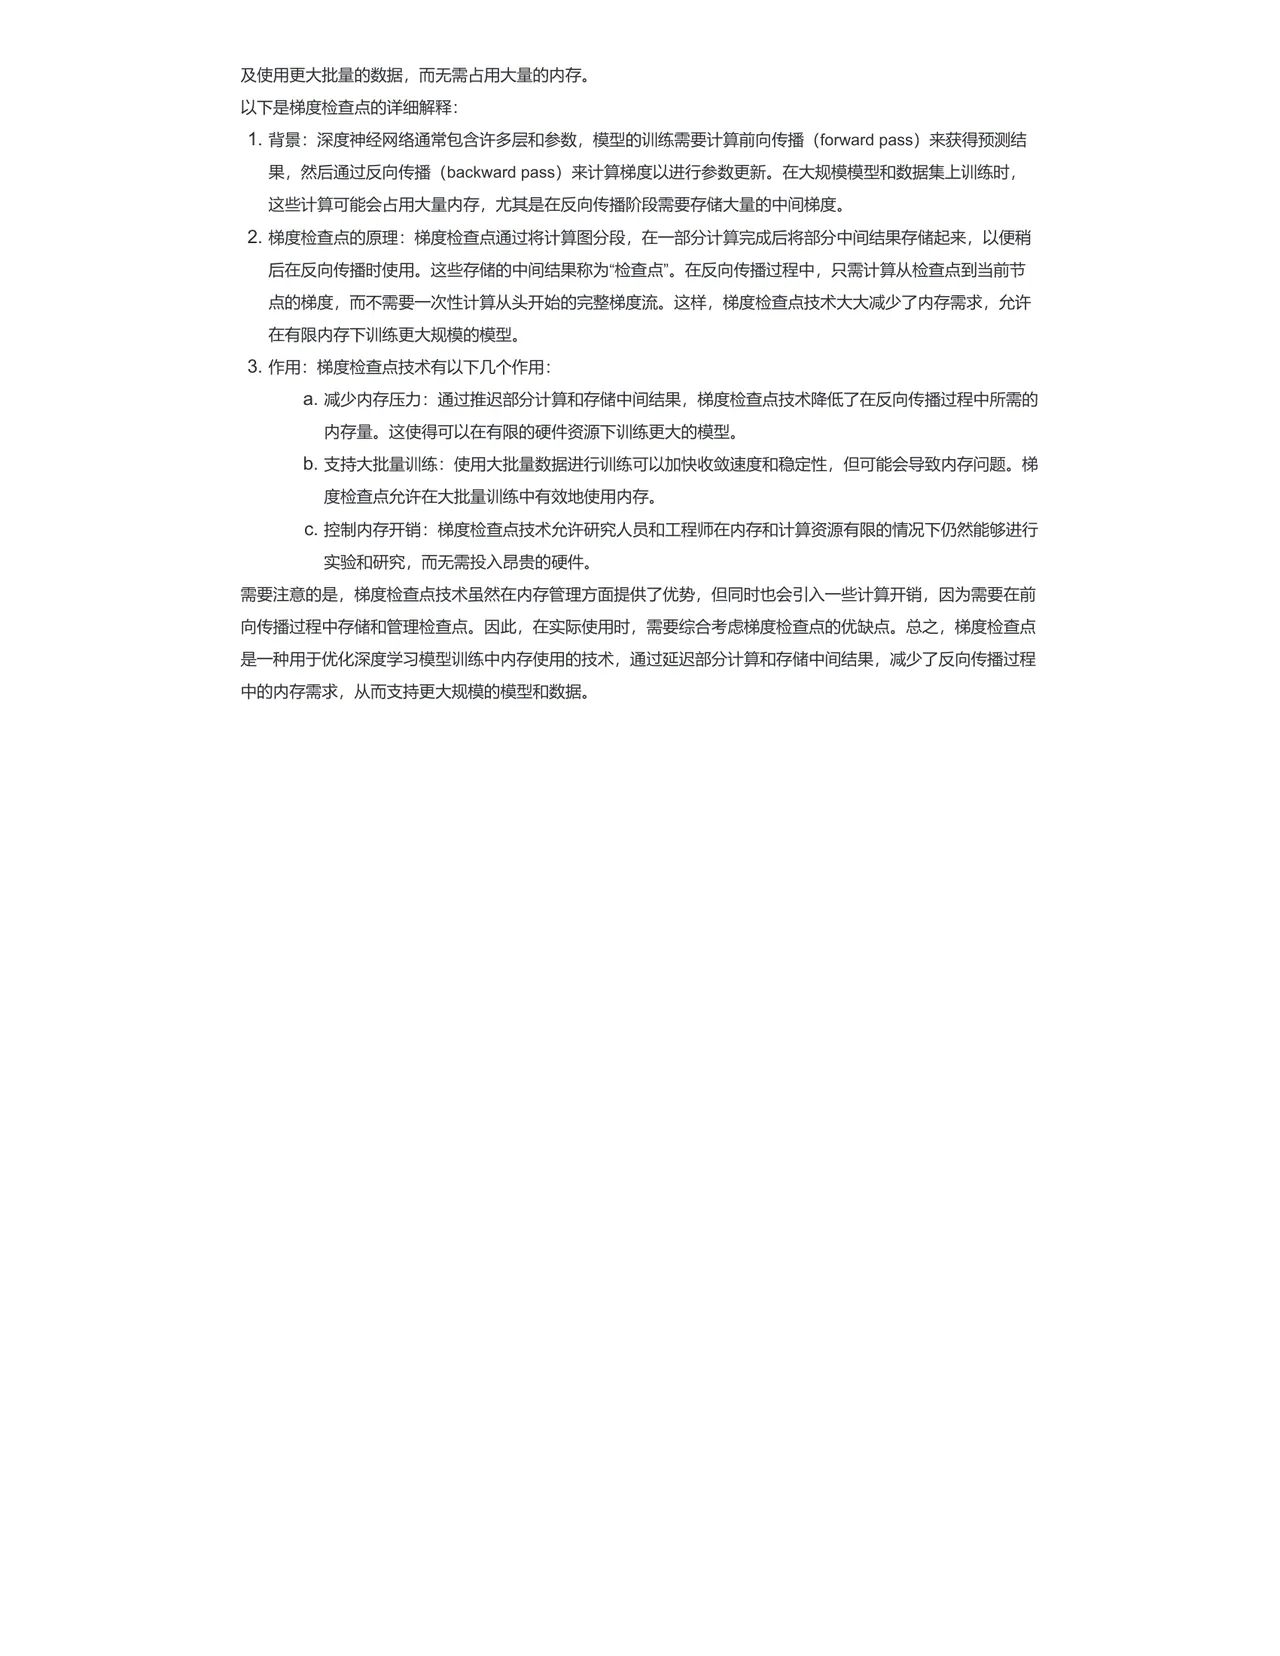
及使用更大批量的数据,而无需占用大量的内存。 以下是梯度检查点的详细解释: 1. 背景:深度神经网络通常包含许多层和参数,模型的训练需要计算前向传播(forward pass)来获得预测结 果,然后通过反向传播(backward pass)来计算梯度以进行参数更新。在大规模模型和数据集上训练时, 这些计算可能会占用大量内存,尤其是在反向传播阶段需要存储大量的中间梯度。 2. 梯度检查点的原理:梯度检查点通过将计算图分段,在一部分计算完成后将部分中间结果存储起来,以便稍 后在反向传播时使用。这些存储的中间结果称为”“检查点”。在反向传播过程中,只需计算从检查点到当前节 点的梯度,而不需要一次性计算从头开始的完整梯度流。这样,梯度检查点技术大大减少了内存需求,允许 在有限内存下训练更大规模的模型。 3. 作用:梯度检查点技术有以下几个作用: a.减少内存压力:通过推迟部分计算和存储中间结果,梯度检查点技术降低了在反向传播过程中所需的 内存量。这使得可以在有限的硬件资源下训练更大的模型。 b. 支持大批量训练:使用大批量数据进行训练可以加快收敛速度和稳定性,但可能会导致内存问题。梯 度检查点允许在大批量训练中有效地使用内存。 c.控制内存开销:梯度检查点技术允许研究人员和工程师在内存和计算资源有限的情况下仍然能够进行 实验和研究,而无需投入昂贵的硬件。 需要注意的是,梯度检查点技术虽然在内存管理方面提供了优势,但同时也会引入一些计算开销,因为需要在前 向传播过程中存储和管理检查点。因此,在实际使用时,需要综合考虑梯度检查点的优缺点。总之,梯度检查点 是一种用于优化深度学习模型训练中内存使用的技术,通过延迟部分计算和存储中间结果,减少了反向传播过程 中的内存需求,从而支持更大规模的模型和数据。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求