训练、微调与数据图文讲义1638 字

模型微调原理

·全库 81 / 611

《模型微调原理》共 15 页、0.2 万字,通篇围绕 微调、LoRA、预训练、评估 展开,归在「训练、微调与数据」这一层。

覆盖微调LoRA预训练评估场景对齐

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(8 节)
  1. 大模型微调原理
  2. 通用大模型:才华横溢,但并非“全能专家”
  3. 模型微调的“五步法”蓝图
  4. 第一步:选择基石- 准备预训练模型
  5. 第二步:准备养料 - 准备目标任务数据
  6. 第三步:格式对齐- 让模型“听懂”你的数据
  7. 第四步:配置与训练 - 效果与成本的艺术
  8. 第五步:验证与部署-创造并迭代价值

原 PDF 已逐页还原成图,共 15 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01大模型微调原理
  2. 02本次分享大纲
  3. 03通用大模型:才华横溢,但并非“全能专家”
011 / 3
第 1 页:大模型微调原理
第 1 页

大模型微调原理

从通用到专属,释放 AI 的真正潜能

022 / 3
第 2 页
第 2 页

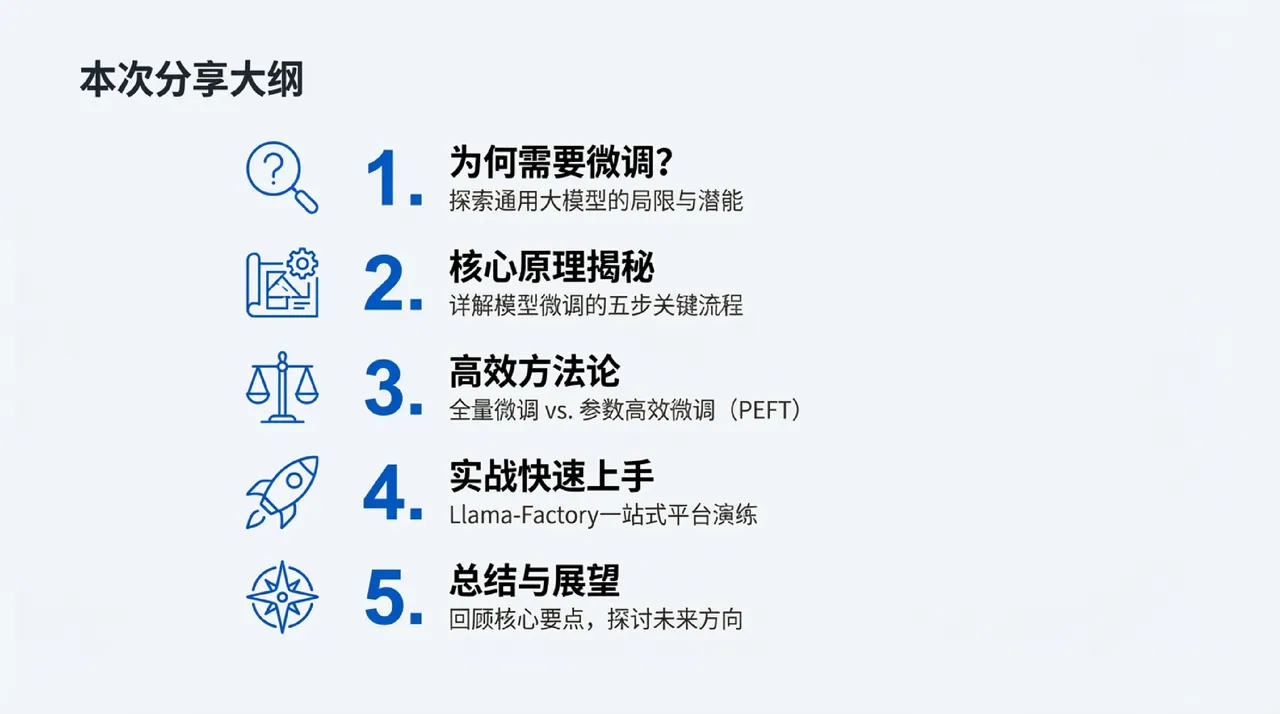
本次分享大纲

本次分享大纲

为何需要微调?

探索通用大模型的局限与潜能

核心原理揭秘

高效方法论

实战快速上手

4.

Llama-Factory 一站式平台演练 总结与展望 回顾核心要点,探讨未来方向

0i3. 煮效方法論效附间(0ET)

033 / 3
第 3 页:通用大模型:才华横溢,但并非“全能专家”
第 3 页

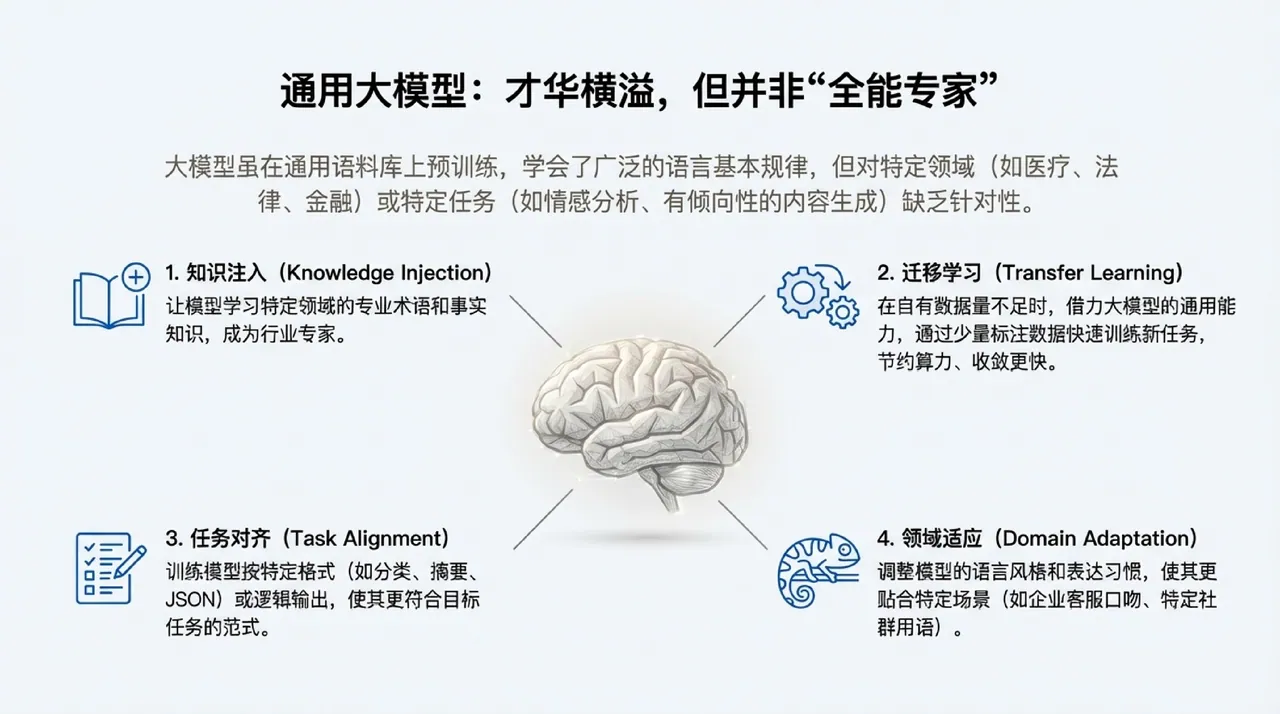
通用大模型:才华横溢,但并非“全能专家”

大模型虽在通用语料库上预训练,学会了广泛的语言基本规律,但对特定领域(如医疗、法 律、金融)或特定任务(如情感分析、有倾向性的内容生成)缺乏针对性。 1.知识注入(Knowledge Injection) 让模型学习特定领域的专业术语和事实 知识,成为行业专家。

  1. 任务对齐(Task Alignment) 训练模型按特定格式(如分类、摘要、 JSON)或逻朝输出,使其更符合目标 任务的范式。
  1. 迁移学习(Transfer Learning) 在自有数据量不足时,借力大模型的通用能 力,通过少量标注数据快連训练新任务, 节约算力、收敛更快。
  1. 领域适应(Domain Adaptation) 调整模型的语言风格和表达习惯,使其更 贴合特定场景(如企业客服口吻、特定社 群用语)。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求