入门与全局认知面试题图文讲义6481 字

大模型进阶面试题

·全库 120 / 611

《大模型进阶面试题》共 10 页、0.6 万字,通篇围绕 prompt、推理、Transformer、Attention 展开,归在「入门与全局认知」这一层。

覆盖prompt推理TransformerAttention需求微调

适合刚接手 AI 项目、需要先把全局图景拼起来的人

目录骨架(6 节)
  1. 大模型(LLMs)进阶面
  2. 三、LLMS 复读机问题
  3. 3.3.1 Unlikelihood Training
  4. 3.3.2 引入噪声
  5. 3.3.3 Repetition Penalty
  6. 3.3.4 Contrastive Search

原 PDF 已逐页还原成图,共 10 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01大模型(LLMs)进阶面
  2. 02c.在训练过程中加入一些设计好的 l…
  3. 03cECt
011 / 3
第 1 页
第 1 页

大模型(LLMs)进阶面

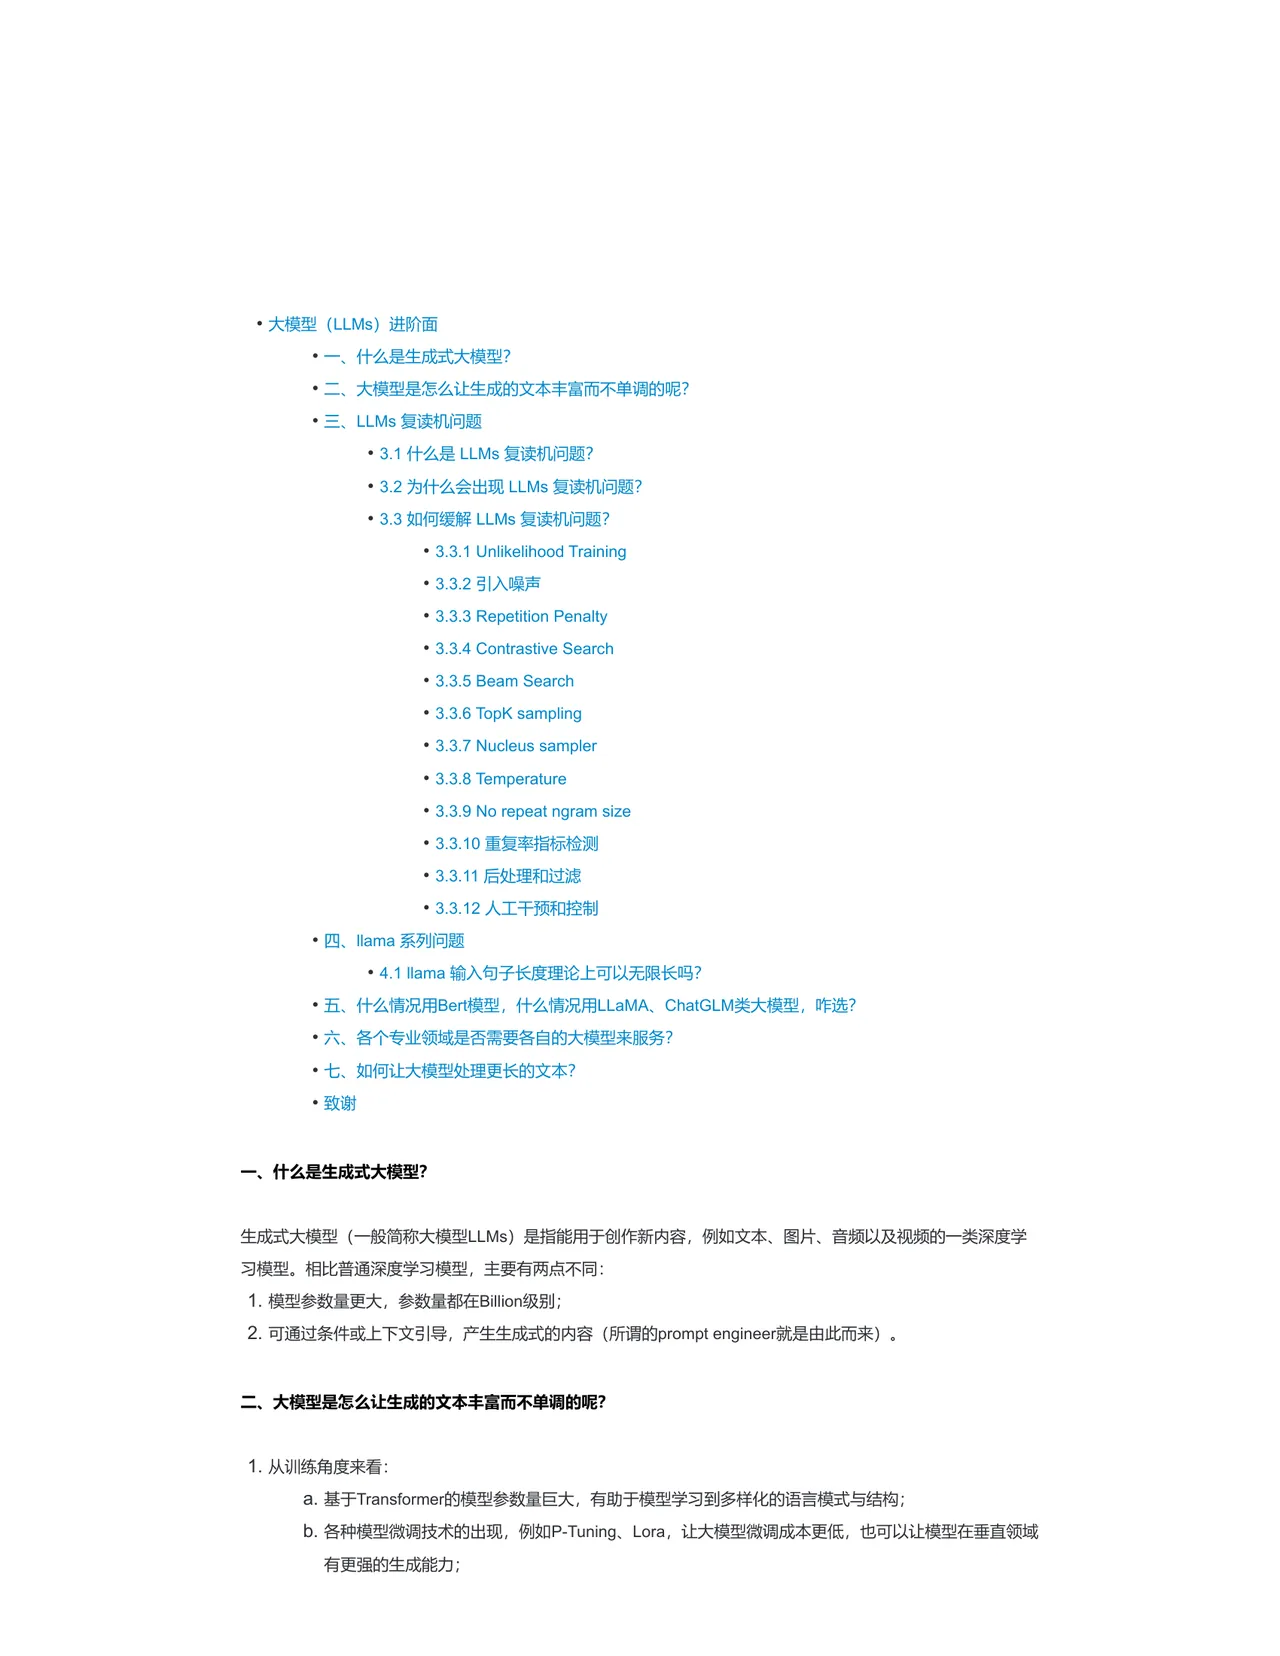
  • 大模型(LLMs)进阶面
  • 一、什么是生成式大模型?
  • 二、大模型是怎么让生成的文本丰富而不单调的呢?
  • 三、LLMS 复读机问题
  • 3.1 什么是 LLMs 复读机问题?
  • 3.2 为什么会出现 LLMs 复读机问题?
  • 3.3 如何缓解 LLMs 复读机问题?
  • 3.3.1 Unlikelihood Training
  • 3.3.2 引入噪声
  • 3.3.3 Repetition Penalty
  • 3.3.4 Contrastive Search
  • 3.3.5 Beam Search
  • 3.3.6 TopK sampling
  • 3.3.7 Nucleus sampler
  • 3.3.8 Temperature
  • 3.3.9 No repeat ngram size
  • 3.3.10 重复率指标检测
  • 3.3.11 后处理和过滤
  • 3.3.12 人工干预和控制
  • 四、Ilama 系列问题
  • 4.1 llama 输入句子长度理论上可以无限长吗? 。五、什么情况用 Bert 模型,什么情况用 LLaMA、ChatGLM 类大模型,咋选?
  • 六、各个专业领域是否需要各自的大模型来服务?
  • 七、如何让大模型处理更长的文本?

•致谢

一、什么是生成式大模型?

生成式大模型(一般简称大模型 LLMs)是指能用于创作新内容,例如文本、图片、音频以及视频的一类深度学 习模型。相比普通深度学习模型,主要有两点不同: 1.模型参数量更大,参数量都在 Bilion 级别; 2. 可通过条件或上下文引导,产生生成式的内容(所谓的 prompt engineer 就是由此而来)。

二、大模型是怎么让生成的文本丰富而不单调的呢?

1.从训练角度来看: a. 基于 Transformer 的模型参数量巨大,有助于模型学习到多样化的语言模式与结构; b.各种模型微调技术的出现,例如 P-Tuning、Lora,让大模型微调成本更低,也可以让模型在垂直领域 有更强的生成能力;

022 / 3
第 2 页
第 2 页

c.在训练过程中加入一些设计好的 l…

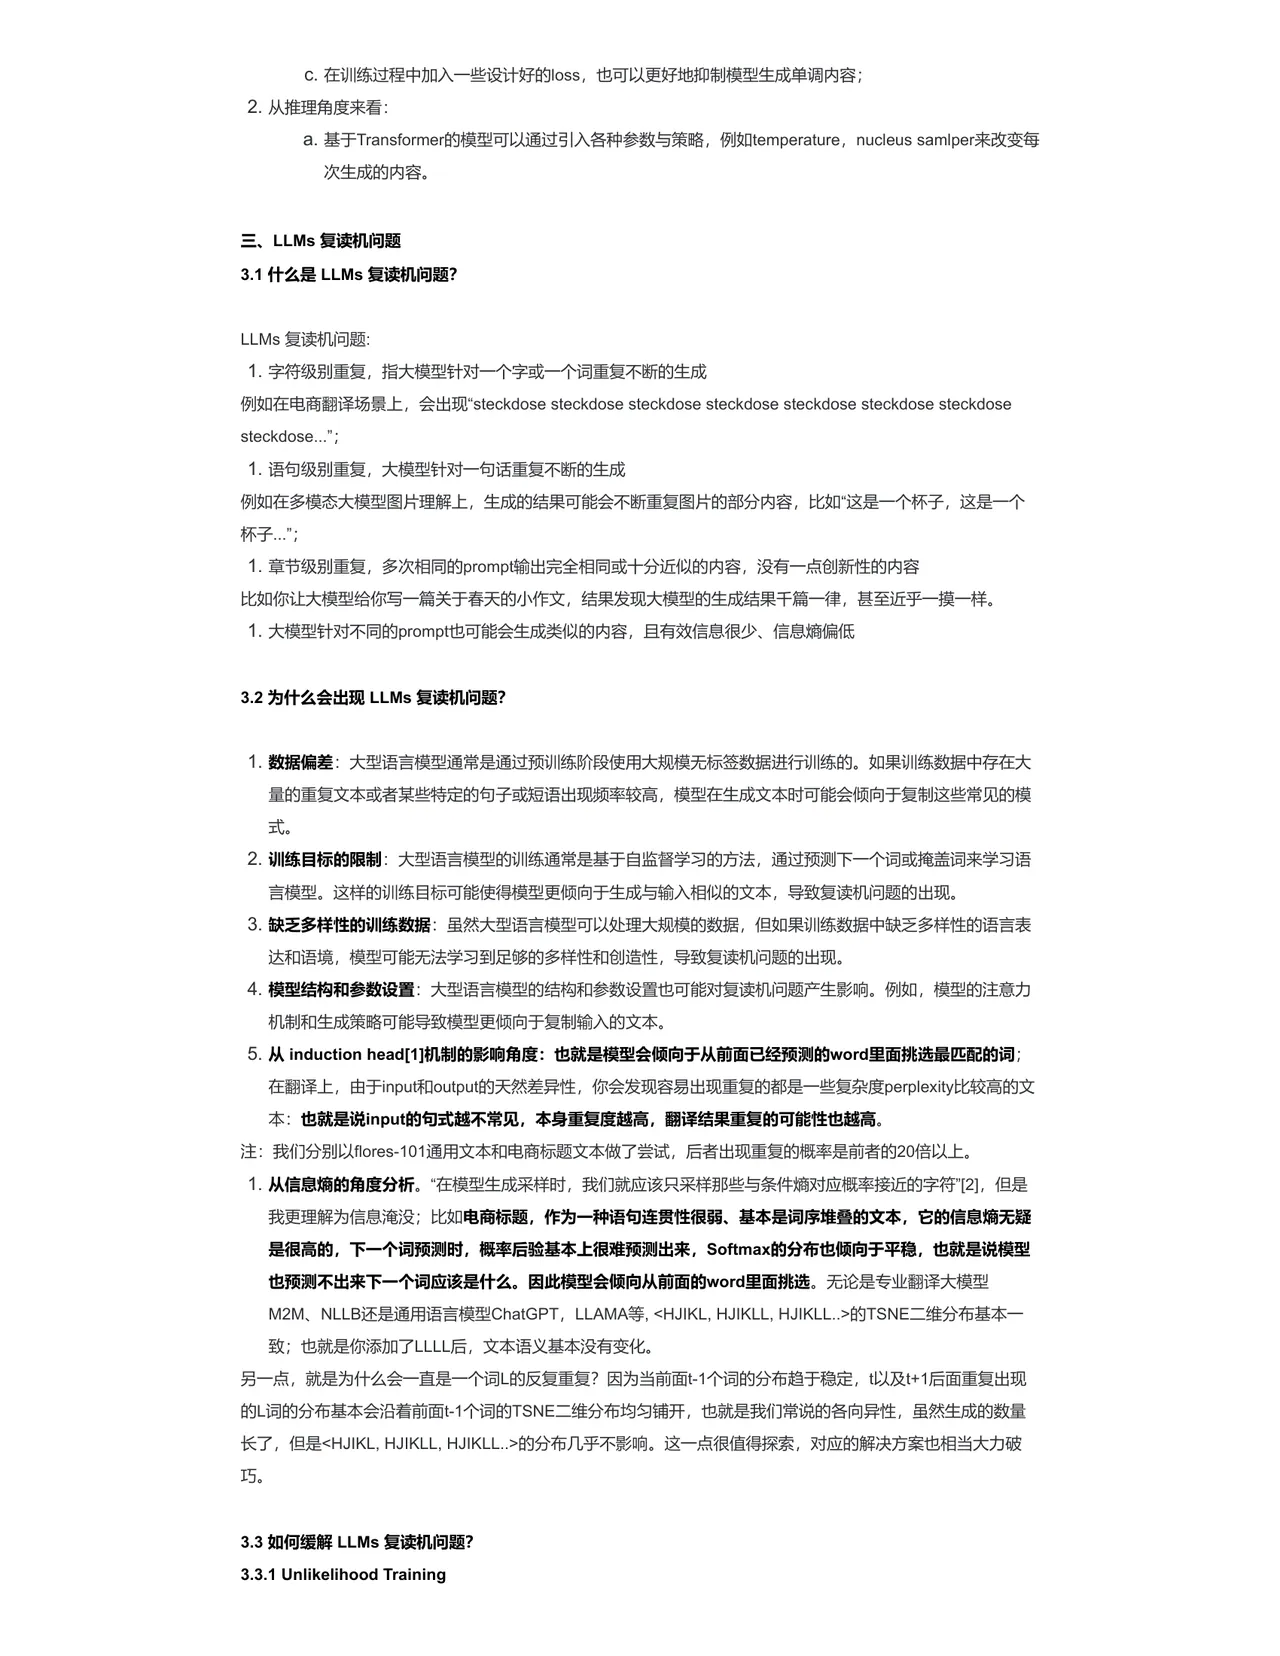
c.在训练过程中加入一些设计好的 loss,也可以更好地抑制模型生成单调内容; 2. 从推理角度来看: a. 基于 Transformer 的模型可以通过引入各种参数与策略,例如 temperature,nucleus samlper 来改变每 次生成的内容。

三、LLMs 复读机问题 3.1 什么是 LLMs 复读机问题?

LLMs 复读机问题: 1.字符级别重复,指大模型针对一个字或一个词重复不断的生成 例如在电商翻译场景上,会出现"steckdose steckdose steckdose steckdose steckdose steckdose steckdose steckdose.";

1.语句级别重复,大模型针对一句话重复不断的生成 例如在多模态大模型图片理解上,生成的结果可能会不断重复图片的部分内容,比如“这是一个杯子,这是一个

1.章节级别重复,多次相同的 prompt 输出完全相同或十分近似的内容,没有一点创新性的内容 比如你让大模型给你写一篇关于春天的小作文,结果发现大模型的生成结果干篇一律,甚至近乎一摸一样。 1. 大模型针对不同的 prompt 也可能会生成类似的内容,且有效信息很少、信息熵偏低

3.2 为什么会出现 LLMs 复读机问题?

  1. 数据偏差:大型语言模型通常是通过预训练阶段使用大规模无标签数据进行训练的。如果训练数据中存在大 量的重复文本或者某些特定的句子或短语出现频率较高,模型在生成文本时可能会倾向于复制这些常见的模 式。 2.训练目标的限制:大型语言模型的训练通常是基于自监督学习的方法,通过预测下一个词或掩盖词来学习语 言模型。这样的训练目标可能使得模型更倾向于生成与输入相似的文本,导致复读机问题的出现。 3.缺乏多样性的训练数据:虽然大型语言模型可以处理大规模的数据,但如果训练数据中缺乏多样性的语言表 达和语境,模型可能无法学习到足够的多样性和创造性,导致复读机问题的出现。 4.模型结构和参数设置:大型语言模型的结构和参数设置也可能对复读机问题产生影响。例如,模型的注意力 机制和生成策略可能导致模型更倾向于复制输入的文本。 5. 从 induction head [ 11 机制的影响角度:也就是模型会倾向于从前面已经预测的 word 里面挑选最匹配的词; 在翻译上,由于 inputoutput 的天然差异性,你会发现容易出现重复的都是一些复杂度 perplexity 比较高的文 本:也就是说 input 的句式越不常见,本身重复度越高,翻译结果重复的可能性也越高。 注:我们分别以 flores-101 通用文本和电商标题文本做了尝试,后者出现重复的概率是前者的 20 倍以上。 1. 从信息熵的角度分析。“在模型生成采样时,我们就应该只采样那些与条件熵对应概率接近的字符"\2 ],但是 我更理解为信息淹没;比如电商标题,作为一种语句连贯性很弱、基本是词序堆叠的文本,它的信息熵无疑 是很高的,下一个词预测时,概率后验基本上很难预测出来,Softmax 的分布也倾向于平稳,也就是说模型 也预测不出来下一个词应该是什么。因此模型会倾向从前面的 word 里面挑选。无论是专业翻译大模型 M2M、NLLB 还是通用语言模型 ChatGPT,LLAMA 等,<HJIKL, HUIKLL, HJIKLL.>的 TSNE 二维分布基本一 致;也就是你添加了 LLLL 后,文本语义基本没有变化。 另一点,就是为什么会一直是一个词 L 的反复重复?因为当前面 t-1 个词的分布趋于稳定,t 以及 1 后面重复出现 的 L 词的分布基本会沿着前面 t1 个词的 TSNE 二维分布均匀铺开,也就是我们常说的各向异性,虽然生成的数量 长了,但是<HUIKL,HUIKLL,HJIKLL..>的分布几乎不影响。这一点很值得探索,对应的解决方案也相当大力破 巧。

3.3 如何缓解 LLMs 复读机问题?

3.3.1 Unlikelihood Training

033 / 3
第 3 页:cECt
第 3 页

cECt

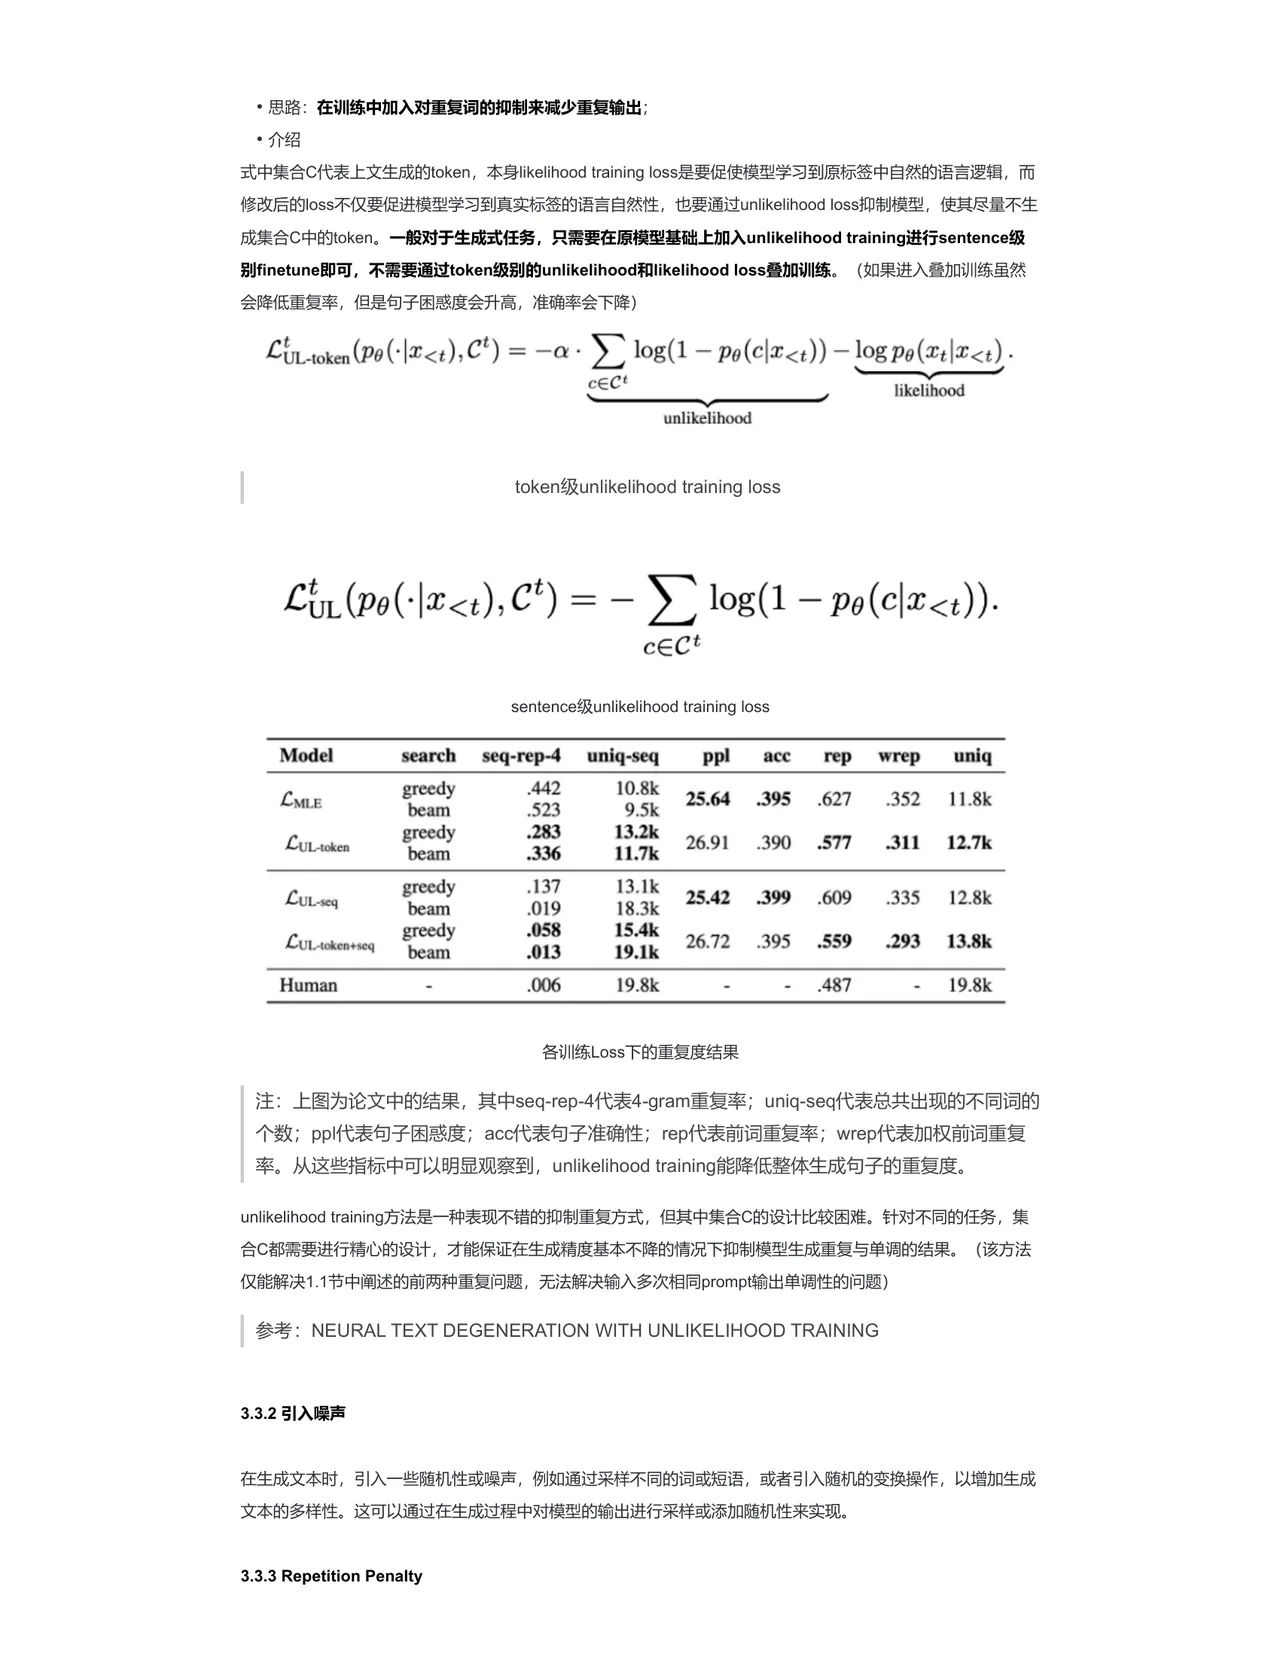
  • 思路:在训练中加入对重复词的抑制来减少重复输出;
  • 介绍 式中集合 C 代表上文生成的 token,本身 likelihood training loss 是要促使模型学习到原标签中自然的语言逻辑,而 修改后的 loss 不仅要促进模型学习到真实标签的语言自然性,也要通过 unlikelihood loss 抑制模型,使其尽量不生 成集合 C 中的 token。一般对于生成式任务,只需要在原模型基础上加入 unlikelihood training 进行 sentence 级 别 finetune 即可,不需要通过 token 级别的 unlikelihood 和 likelihood loss 叠加训练。(如果进入叠加训练虽然 会降低重复率,但是句子困惑度会升高,准确率会下降)

Model LMLE

Human

注:上图为论文中的结果,其中 seq-rep-4 代表 4-gram 重复率;uniq-seq 代表总共出现的不同词的 个数;Ppl 代表句子困惑度;acc 代表句子准确性;rep 代表前词重复率;wrep 代表加权前词重复 率。从这些指标中可以明显观察到,unlikelihood training 能降低整体生成句子的重复度。 unlikelihood training 方法是一种表现不错的抑制重复方式,但其中集合 C 的设计比较困难。针对不同的任务,集 合 C 都需要进行精心的设计,才能保证在生成精度基本不降的情况下抑制模型生成重复与单调的结果。(该方法 仅能解决 1.1 节中阐述的前两种重复问题,无法解決输入多次相同 prompt 输出单调性的问题) 参考:NEURAL TEXT DEGENERATION WITH UNLIKELIHOOD TRAINING

3.3.2 引入噪声

在生成文本时,引入一些随机性或噪声,例如通过采样不同的词或短语,或者引入随机的变换操作,以增加生成 文本的多样性。这可以通过在生成过程中对模型的输出进行采样或添加随机性来实现。

3.3.3 Repetition Penalty

likelihood

wrep rep 11.8k

unlikelihood

token 级 unlikelihood training loss

sentence 级 unlikelihood training loss search seg-rep-4 unig-seq greedy

10.8k

9.5k beam

13.2k greedy

26.91 beam

11.7k

13.1k greedy

18.3k beam .058

15.4k greedy

26.72 beam .013

19.8k

各训练 Loss 下的重复度结果

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求