模型架构与原理面试题图文讲义633 字

深度学习层归一化面试题

·全库 123 / 611

《深度学习层归一化面试题》共 3 页、0.1 万字,通篇围绕 Attention、Transformer、embedding 展开,归在「模型架构与原理」这一层。

覆盖AttentionTransformerembedding

适合要跟模型团队对话、得听懂他们在说什么的人

目录骨架(1 节)
  1. Expectation

原 PDF 已逐页还原成图,共 3 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01Layer normalizatio…
  2. 02Deep Norm 可以缓解爆炸式模…
  3. 03Layer normalizatio…
011 / 3
第 1 页
第 1 页

Layer normalizatio…

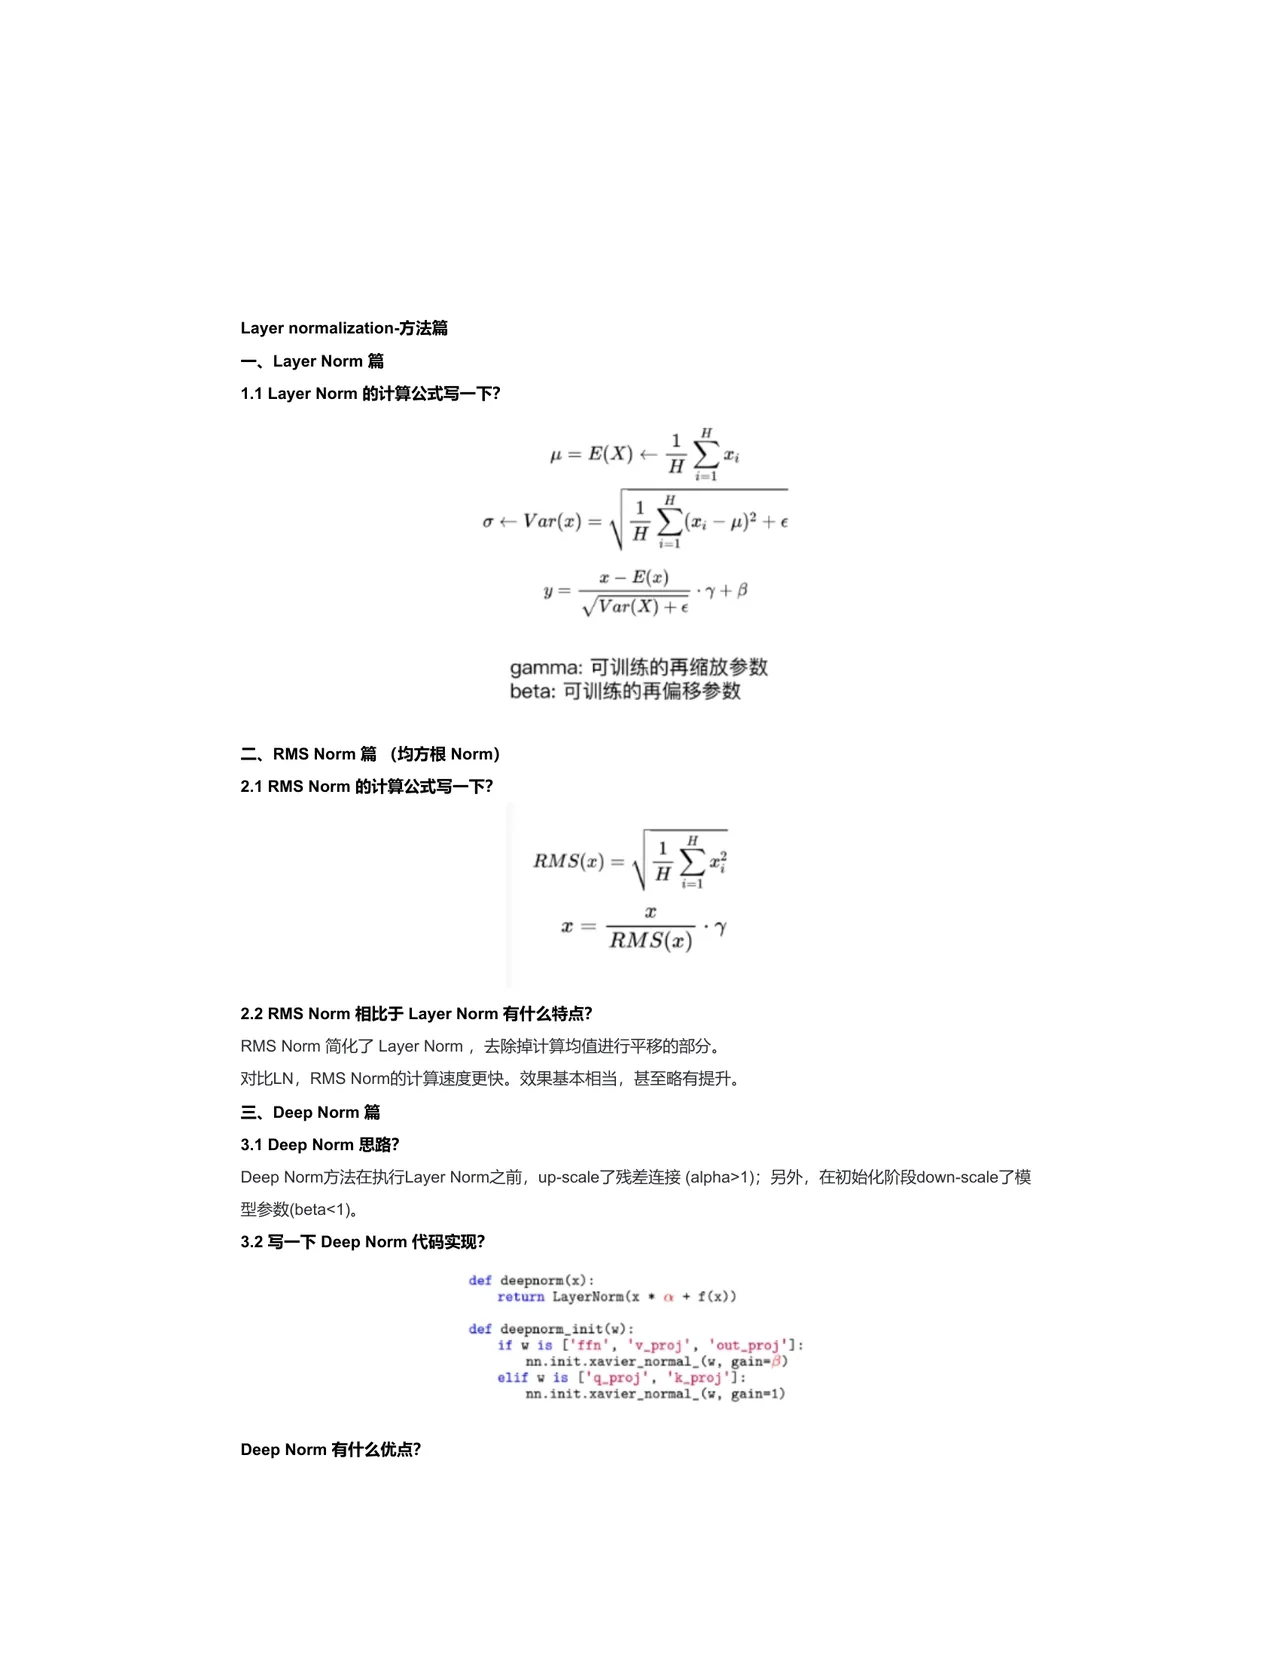
Layer normalization-方法篇 一、Layer Norm 篇 1.1 Layer Norm 的计算公式写一下?

二.RMS Norm 篇(均方根 Norm) 2.1 RMS Norm 的计算公式写一下?

2.2 RMS Norm 相比于 Layer Norm 有什么特点? RMS Norm 简化了 Layer Norm,去除掉计算均值进行平移的部分。 对比 LN,RMS Norm 的计算速度更快。效果基本相当,甚至略有提升。 三,Deep Norm 篇 3.1 Deep Norm 思路? Deep Norm 方法在执行 Layer Norm 之前,up-scale 了残差连接(alpha>1);另外,在初始化阶段 down-scale 了模 型参数(beta<1)。 3.2 写一下 Deep Norm 代码实现?

Deep Norm 有什么优点?

VVar (X)+e gamma:可训练的再缩放参数 beta:可训练的再偏移参数

def deepnorm_init (w): 'v_proj','out_proj']: nn.init.xavier_normal_(w,gain=1)

022 / 3
第 2 页
第 2 页

Deep Norm 可以缓解爆炸式模…

def deepnorm (x): lef deepnorm_init (w):

'out_proj']:

nn.init.xavier_normal_(w, nn.init.xavier_normal_(w, gain=1)

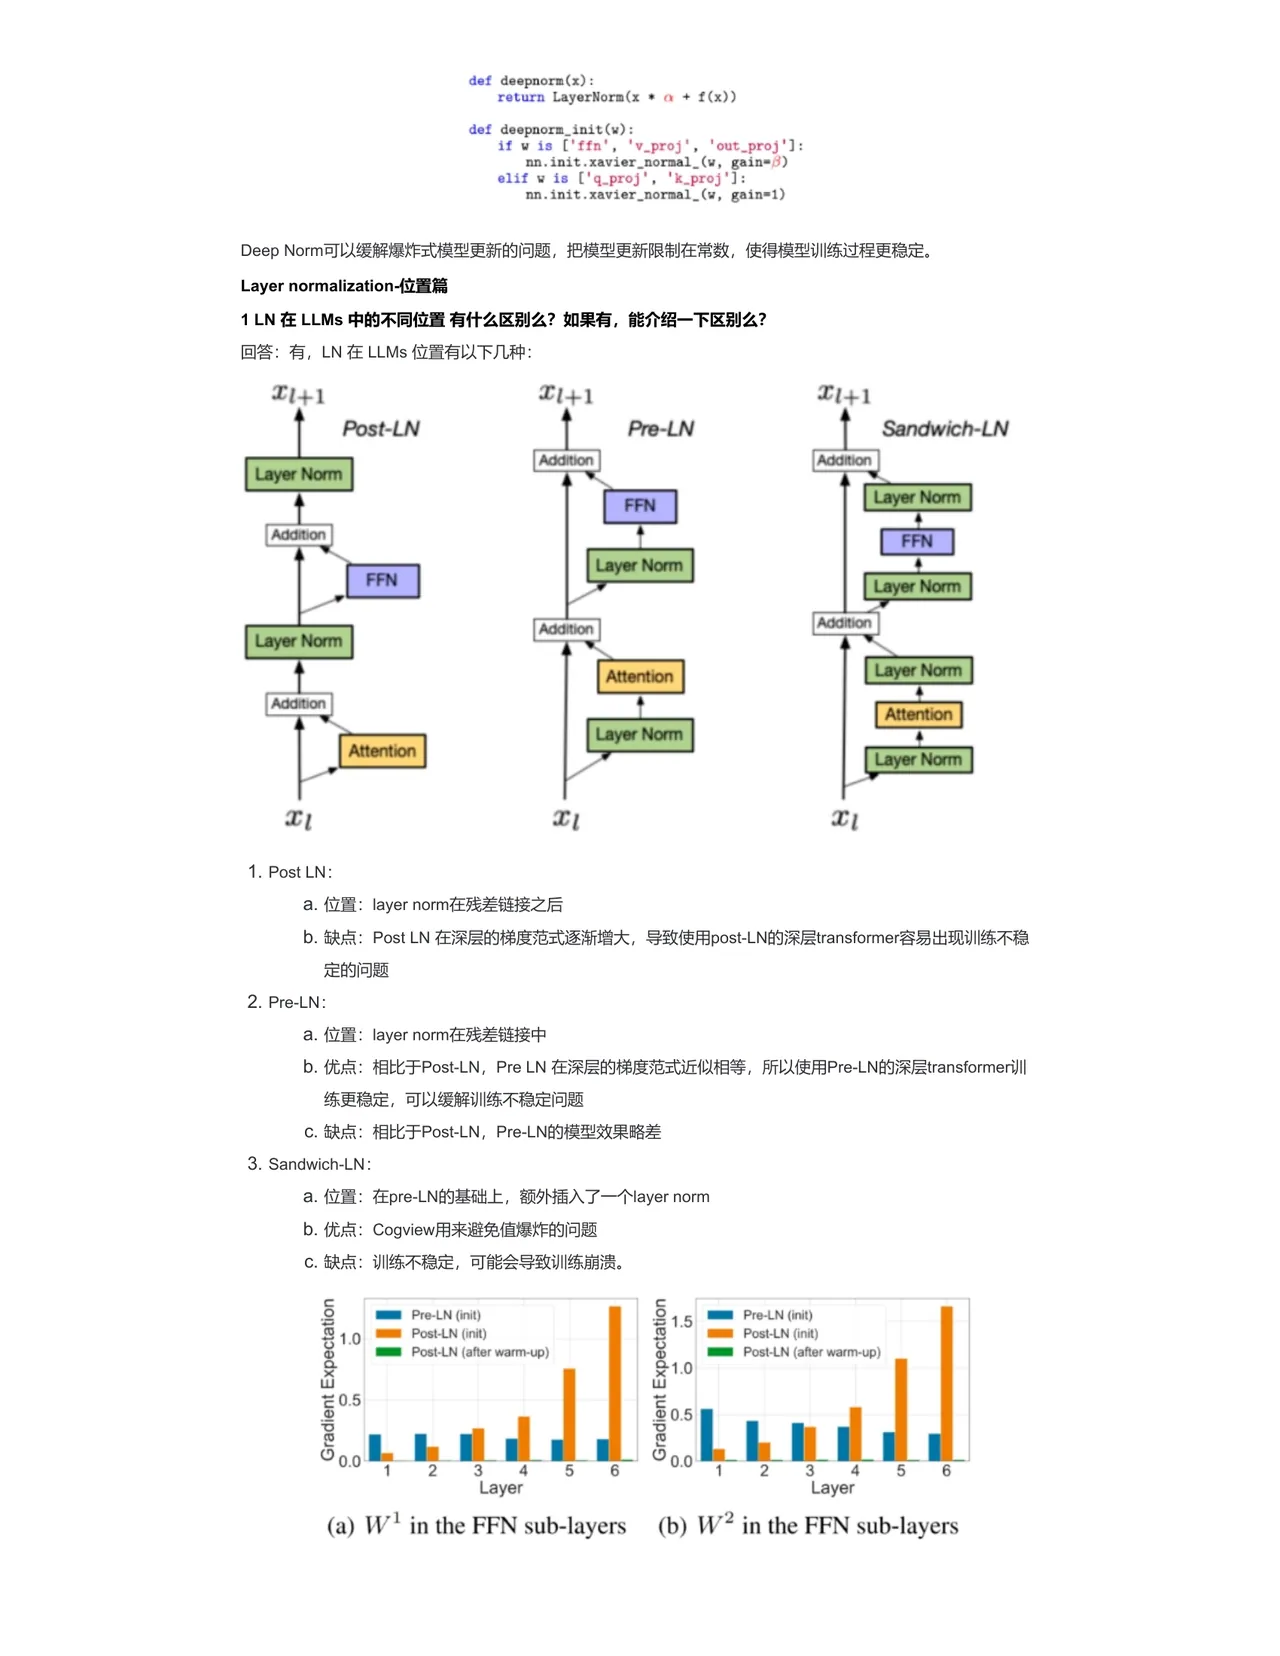
Deep Norm 可以缓解爆炸式模型更新的问题,把模型更新限制在常数,使得模型训练过程更稳定。 Layer normalization-位置篇 1LN 在 LLMs 中的不同位置有什么区别么?如果有,能介绍一下区别么? 回答:有,LN 在 LLMs 位置有以下几种:

Post-LN Pre-LN Sandwich-LN

Addition

Layer Norm FFN FFN Layer Norm FFN Layer Nomm Addition Addition Attention Addition

Attention Layer Norm Attention Layer Norm

a. 位置:layer norm 在残差链接之后 b. 缺点:Post LN 在深层的梯度范式逐渐增大,导致使用 post-LN 的深层 transformer 容易出现训练不稳 定的问题 2. Pre-LN: a. 位置:layer norm 在残差链接中 b. 优点:相比于 Post-LN,Pre LN 在深层的梯度范式近似相等,所以使用 Pre-LN 的深层 transformeri 练更稳定,可以缓解训练不稳定问题 C. 缺点:相比于 Post-LN,Pre-LN 的模型效果略差 3. Sandwich-LN: a. 位置:在 pre-LN 的基础上,额外插入了一个 layer norm b. 优点:Cogview 用来避免值爆炸的问题 C.缺点:训练不稳定,可能会导致训练崩溃。

Expectation

Pre-LN (init)

  • Post-LN (after warm-up)

Post-LN (after warm-up) 0.5

iradi

Layer

(a)WL in the FFN sub-layers (b)W" in the FFN sub-layers

033 / 3
第 3 页
第 3 页

Layer normalizatio…

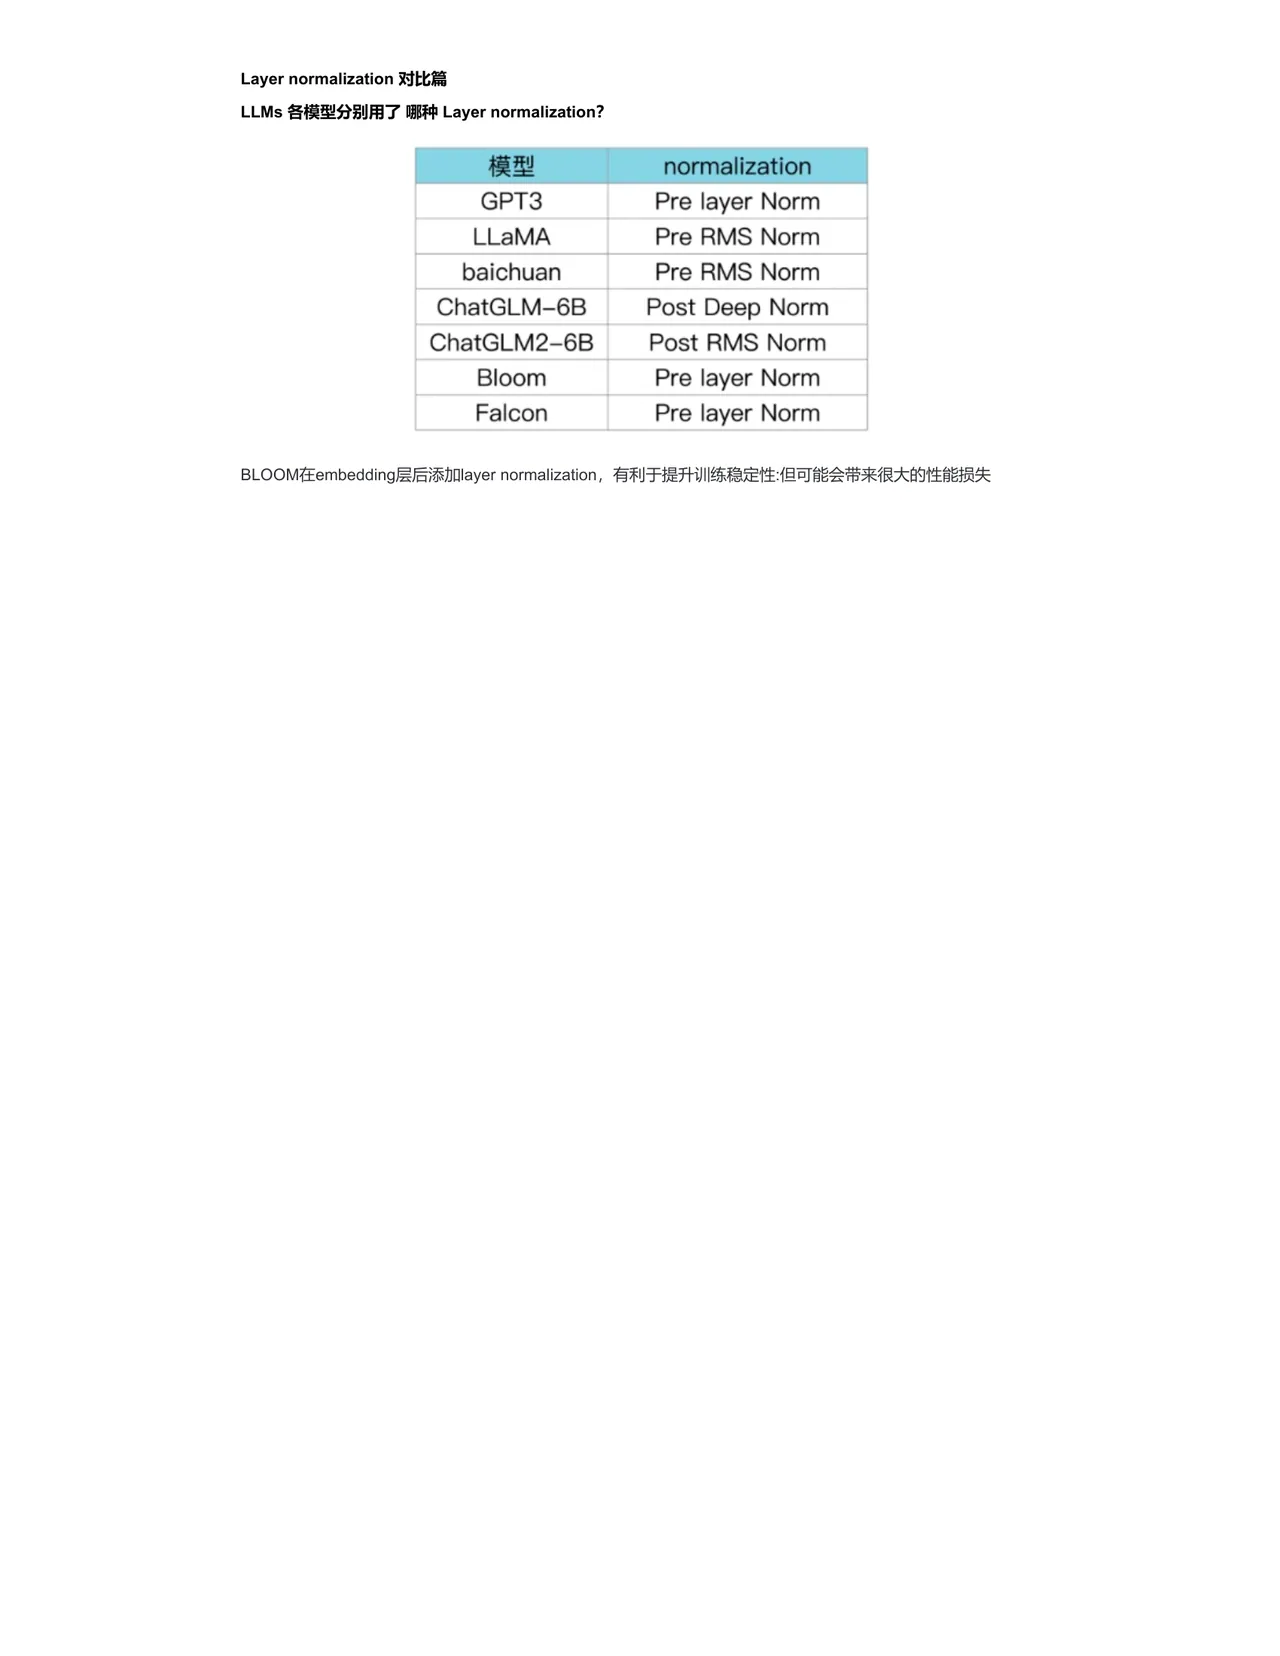
Layer normalization 对比篇 LLMs 各模型分别用了哪种 Layer normalization?

BLOOM 在 embedding 层后添加 layer normalization,有利于提升训练稳定性:但可能会带来很大的性能损失

模型 GPT3 LLaMA baichuan ChatGLM-6B ChatGLM2-6B Bloom Falcon

normalization Pre layer Norm Pre RMS Norm Pre RMS Norm Post Deep Norm Post RMS Norm Pre layer Norm Pre layer Norm

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求