训练、微调与数据面试题图文讲义2774 字

大模型负样本样本挖掘面试题

·全库 122 / 611

《大模型负样本样本挖掘面试题》共 5 页、0.3 万字,通篇围绕 向量、量化、检索、场景 展开,归在「训练、微调与数据」这一层。

覆盖向量量化检索场景召回蒸馏

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(3 节)
  1. 一、为什么需要构建负难样本?
  2. 二、负难样本构建方法篇
  3. 2.5 基于批内负采样的对比学习方法

原 PDF 已逐页还原成图,共 5 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

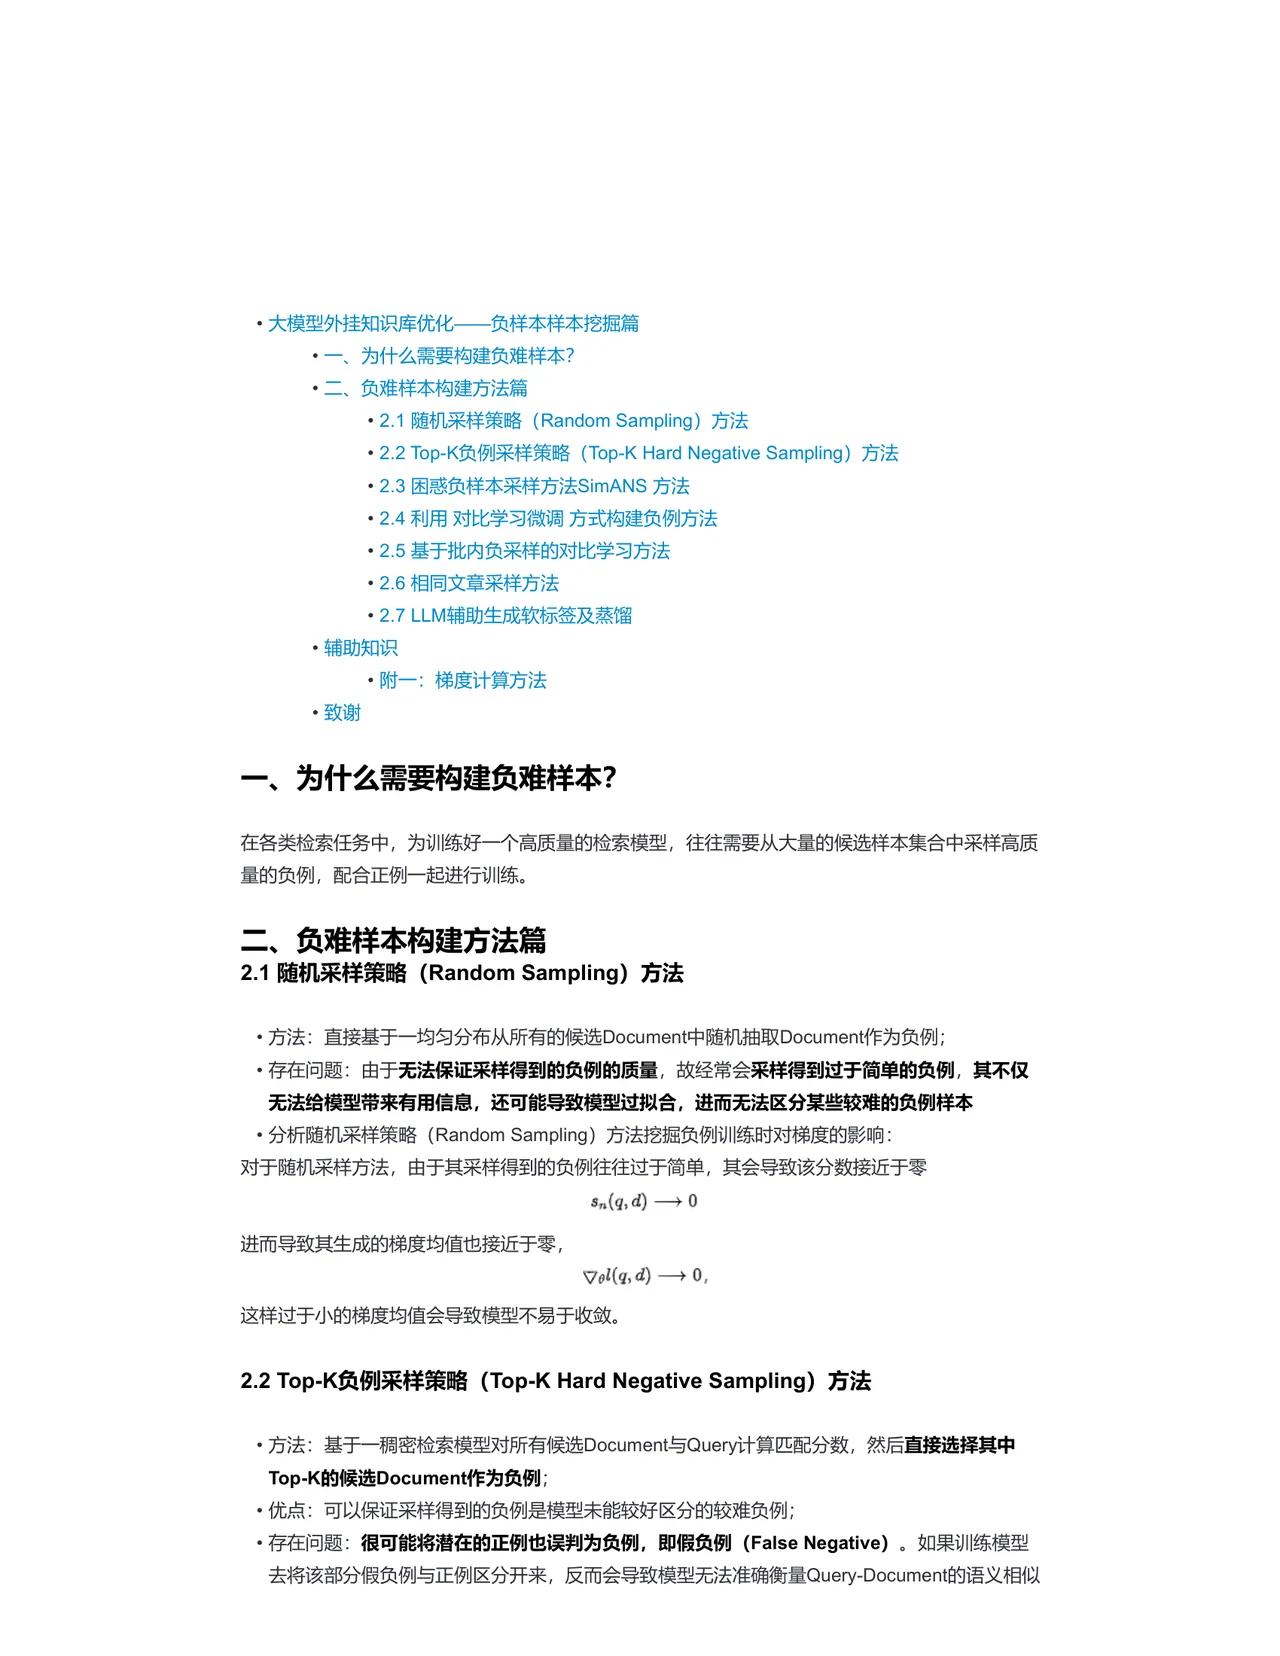
本讲义目录 · 3 页
  1. 01大模型外挂知识库优化——负样本样本挖…
  2. 02度。 •分析 Top-K 负例采样策…
  3. 032.4 利用对比学习微调方式构建负例…
011 / 3
第 1 页
第 1 页

大模型外挂知识库优化——负样本样本挖…

  • 大模型外挂知识库优化——负样本样本挖掘篇
  • 一、为什么需要构建负难样本?
  • 二、负难样本构建方法篇
  • 2.1 随机采样策略(Random Sampling)方法
  • 2.2 Top-K 负例采样策略(Top-K Hard Negative Sampling)方法
  • 2.3 困惑负样本采样方法 SimANS 方法
  • 2.4 利用对比学习微调方式构建负例方法
  • 2.5 基于批内负采样的对比学习方法
  • 2.6 相同文章采样方法
  • 2.7 LLM 辅助生成软标签及蒸馏
  • 辅助知识
  • 附一:梯度计算方法

一、为什么需要构建负难样本?

在各类检索任务中,为训练好一个高质量的检索模型,往往需要从大量的候选样本集合中采样高质 量的负例,配合正例一起进行训练。

二、负难样本构建方法篇

  • 2.1 随机采样策略(Random Sampling)方法
  • 方法:直接基于一均匀分布从所有的候选 Document 中随机抽取 Document 作为负例;
  • 存在问题:由于无法保证采样得到的负例的质量,故经常会采样得到过于简单的负例,其不仅 无法给模型带来有用信息,还可能导致模型过拟合,进而无法区分某些较难的负例样本
  • 分析随机采样策略(Random Sampling)方法挖掘负例训练时对梯度的影响: 对于随机采样方法,由于其采样得到的负例往往过于简单,其会导致该分数接近于零

进而导致其生成的梯度均值也接近于零,

这样过于小的梯度均值会导致模型不易于收敛。

  • 2.2 Top-K 负例采样策略(Top-K Hard Negative Sampling)方法
  • 方法:基于一稠密检索模型对所有候选 Document 与 Query 计算匹配分数,然后直接选择其中 Top-K 的候选 Document 作为负例;
  • 优点:可以保证采样得到的负例是模型未能较好区分的较难负例;
  • 存在问题:很可能将潜在的正例也误判为负例,即假负例(False Negative)。如果训练模型 去将该部分假负例与正例区分开来,反而会导致模型无法准确衡量 Query-Document 的语义相似
022 / 3
第 2 页
第 2 页

度。 •分析 Top-K 负例采样策…

度。 •分析 Top-K 负例采样策略(Top-K Hard Negative Sampling)方法挖掘负例训练时对梯度的影

但是左项符号相反,这样会导致计算得到的梯度方差很大,同样导致模型训练不稳定。

2.3 困惑负样本采样方法 SimANS 方法

  • 动机:在所有负例候选中,与 Query 的语义相似度接近于正例的负例可以同时具有较大的梯度 均值和较小的梯度方差,是更加高质量的困惑负样本
  • 方法:对与正例语义相似度接近的困惑负例样本进行采样
  • 采样方法特点:
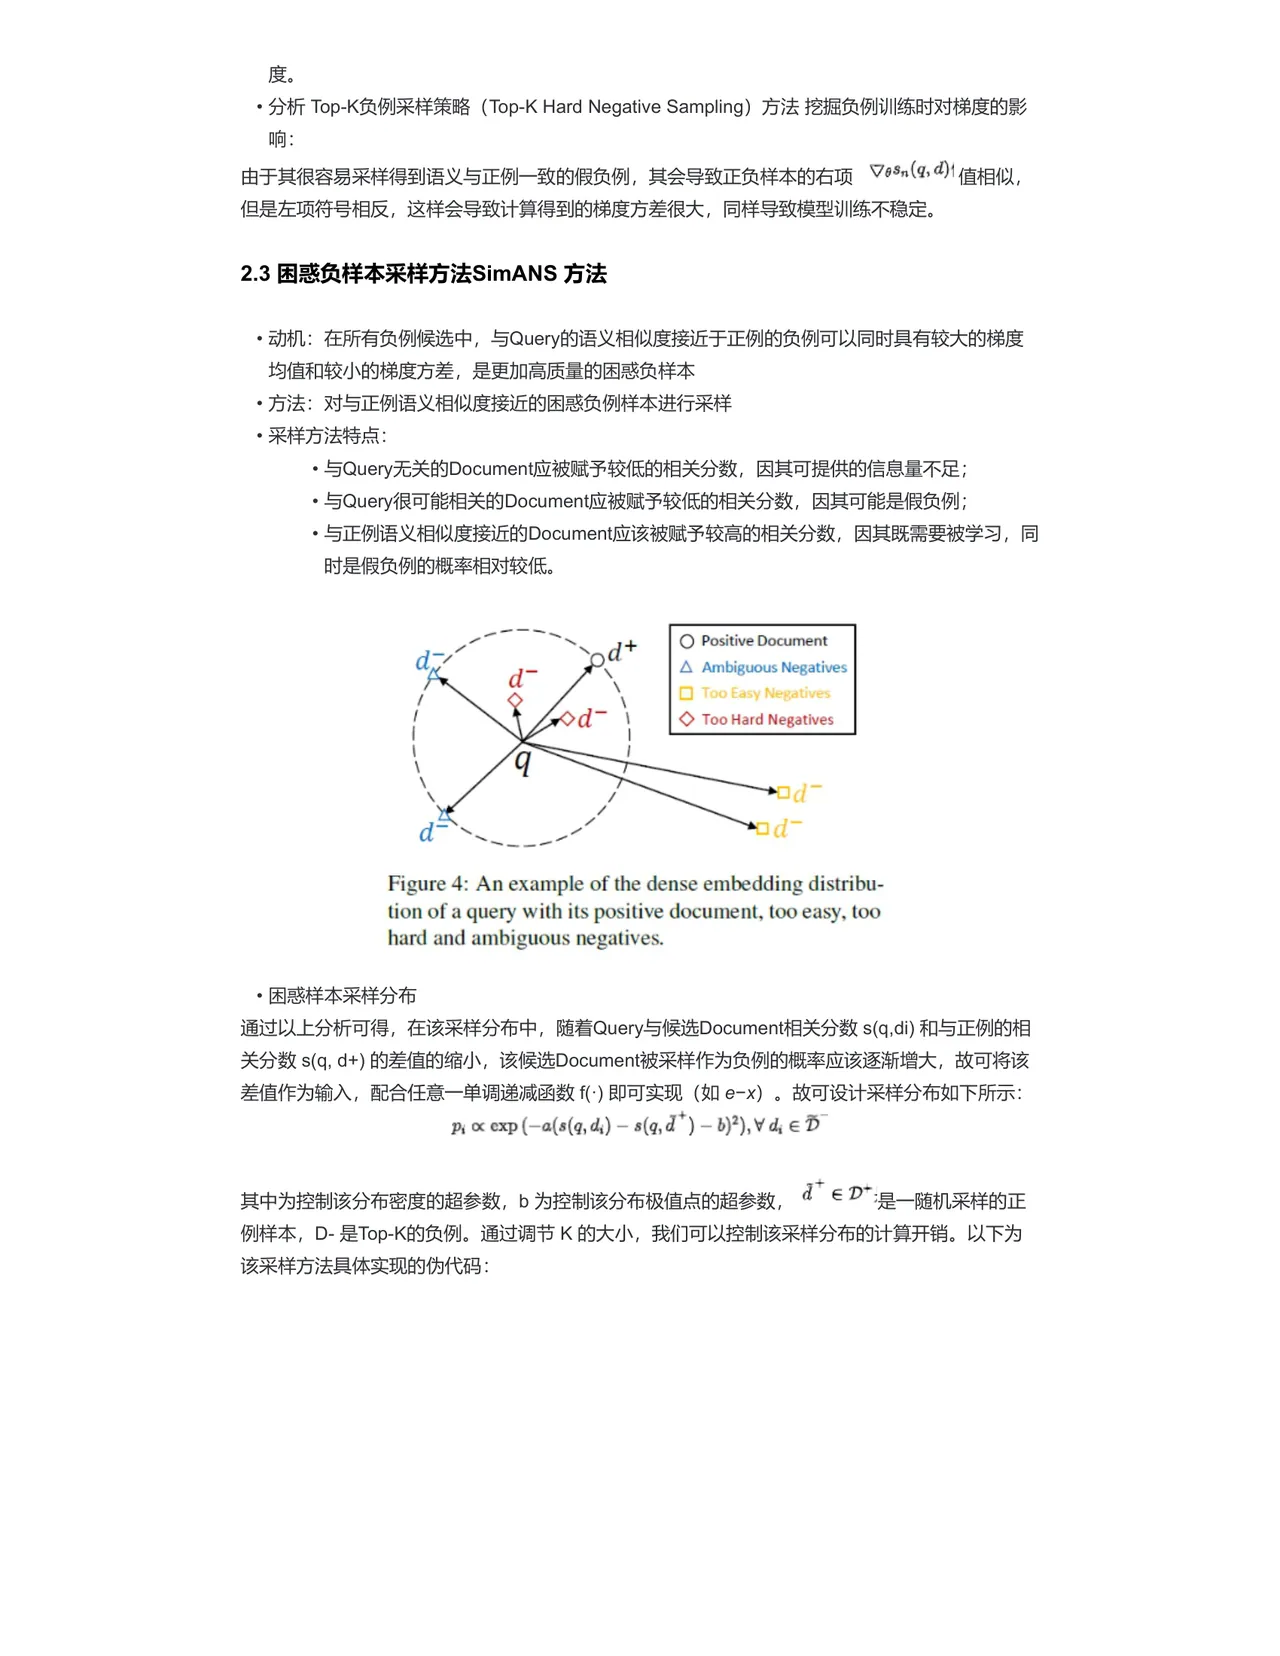
  • 与 Query 无关的 Document 应被赋予较低的相关分数,因其可提供的信息量不足;
  • 与 Query 很可能相关的 Document 应被赋予较低的相关分数,因其可能是假负例;
  • 与正例语义相似度接近的 Document 应该被赋予较高的相关分数,因其既需要被学习,同 时是假负例的概率相对较低。

Figure 4: An example of the dense embedding distribu- tion of a query with its positive document, too easy, too hard and ambiguous negatives.

  • 困惑样本采样分布 通过以上分析可得,在该采样分布中,随着 Query 与候选 Document 相关分数 s (9.di)和与正例的相 关分数 s (q,d+)的差值的缩小,该候选 Document 被采样作为负例的概率应该逐渐增大,故可将该 差值作为输入,配合任意一单调递减函数 f
  • )即可实现(如 e-x)。故可设计采样分布如下所示:

其中为控制该分布密度的超参数,b 为控制该分布极值点的超参数,&' D*、是一随机采样的正

例样本,D-是 Top-K 的负例。通过调节 K 的大小,我们可以控制该采样分布的计算开销。以下为 该采样方法具体实现的伪代码:

  • Positive Document A Ambiguous Negatives 口 Too Easy Negatives
  • Too Hard Negatives
033 / 3
第 3 页
第 3 页

2.4 利用对比学习微调方式构建负例…

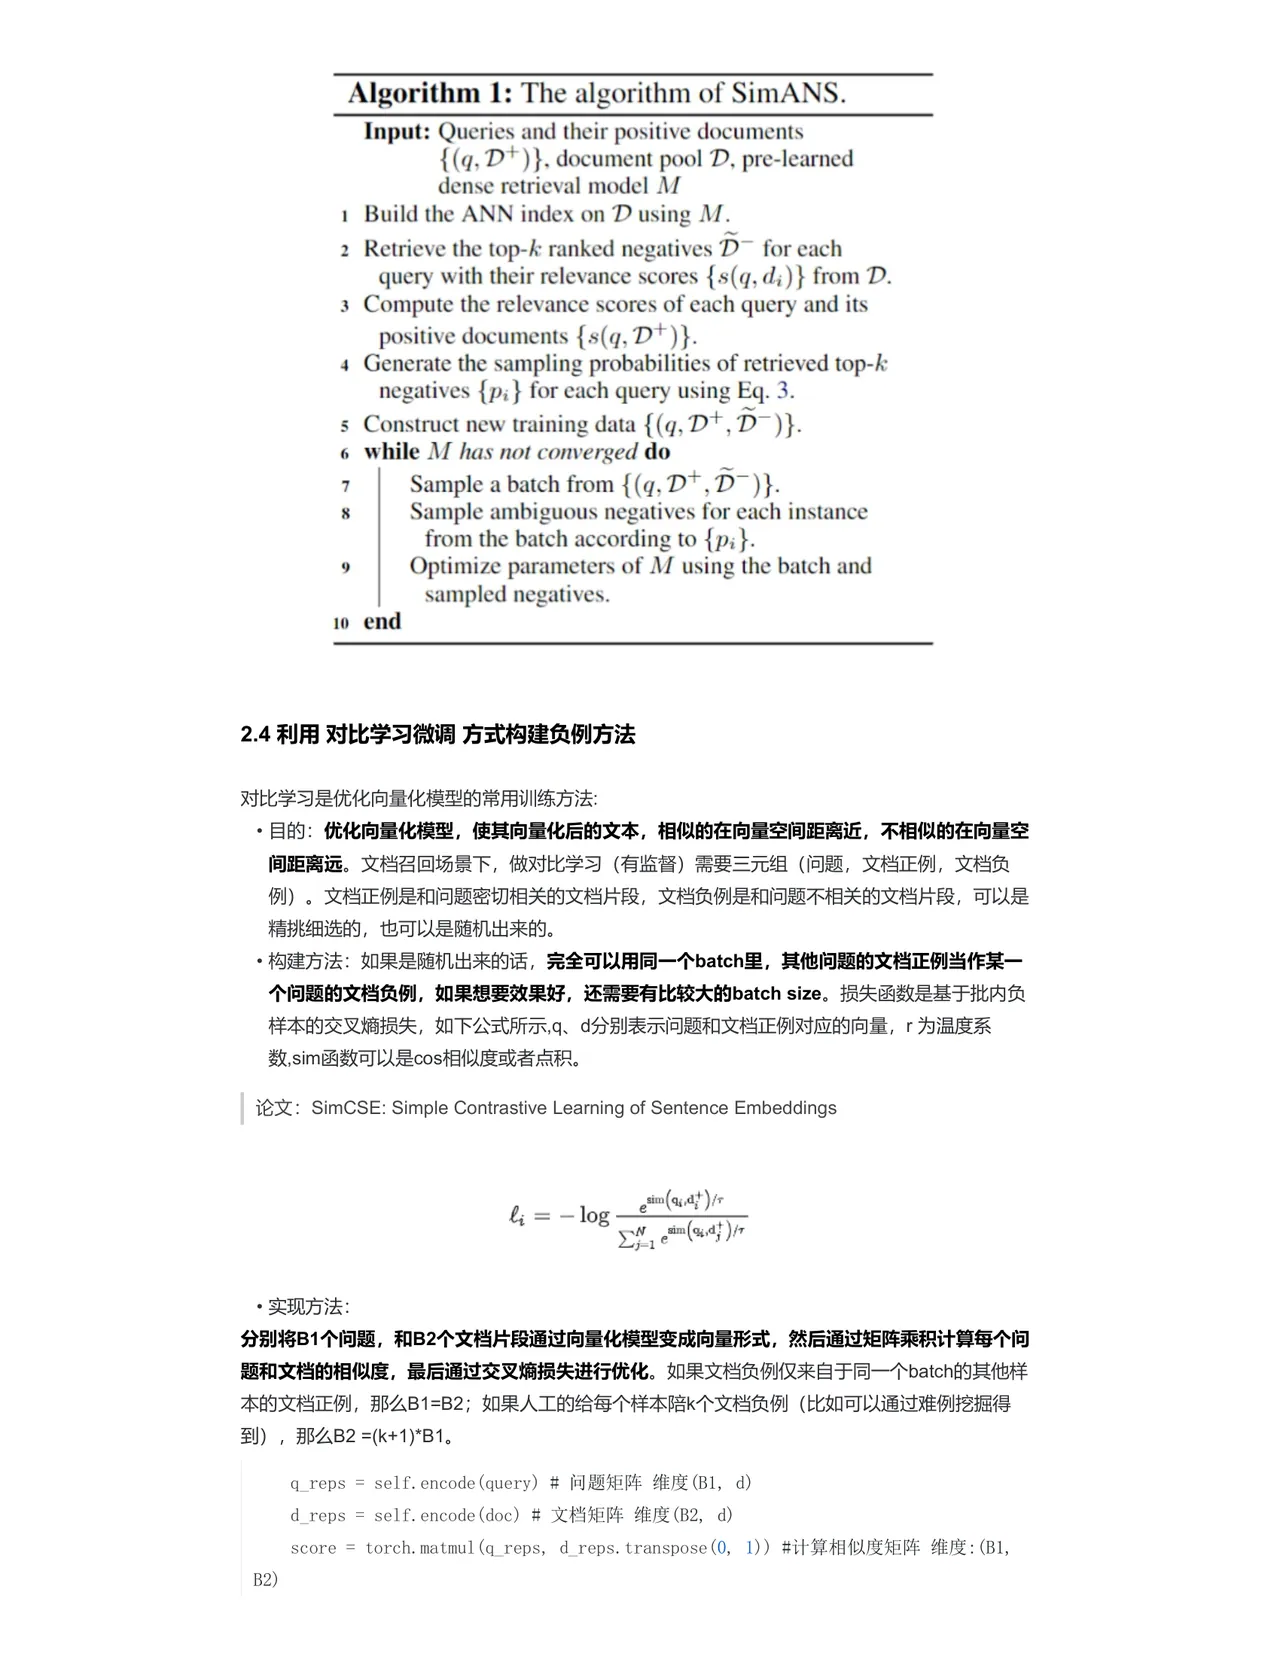
Algorithm 1: The algorithm of SimANS. Input: Queries and their positive documents dense retrieval model M

1 Build the ANN index on D using M. query with their relevance scores { s (g, di)} from D. 3 Compute the relevance scores of each query and its

positive documents { s (g, D+)}. 4 Generate the sampling probabilities of retrieved top-k negatives { pi } for each query using Eq. 3. 6 while M has not converged do

Sample a batch from {(g, D+,D-)}. Sample ambiguous negatives for each instance from the batch according to { pi }. Optimize parameters of M using the batch and sampled negatives. 10 end

  • 2.4 利用对比学习微调方式构建负例方法 对比学习是优化向量化模型的常用训练方法:
  • 目的:优化向量化模型,使其向量化后的文本,相似的在向量空间距离近,不相似的在向量空 间距离远。文档召回场景下,做对比学习(有监督)需要三元组(问题,文档正例,文档负 例)。文档正例是和问题密切相关的文档片段,文档负例是和问题不相关的文档片段,可以是 精挑细选的,也可以是随机出来的。
  • 构建方法:如果是随机出来的话,完全可以用同一个 batch 里,其他问题的文档正例当作某一 个问题的文档负例,如果想要效果好,还需要有比较大的 batch size。损失函数是基于批内负 样本的交叉熵损失,如下公式所示,9、d 分别表示问题和文档正例对应的向量,「为温度系 数,sim 函数可以是 cos 相似度或者点积。 论文:SimCSE: Simple Contrastive Learning of Sentence Embeddings

•实现方法: 分别将 B1 个问题,和 B2 个文档片段通过向量化模型变成向量形式,然后通过矩阵乘积计算每个问 题和文档的相似度,最后通过交叉熵损失进行优化。如果文档负例仅来自于同一个 batch 的其他样 本的文档正例,那么 B1=B2;如果人工的给每个样本陪 k 个文档负例(比如可以通过难例挖掘得 到),那么 B2=(k+1)*B1。 q_reps = self.encode (query)# 问题矩阵维度(B1,d) d_reps = self.encode (doc)# 文档矩阵维度(B2,d) score = torch.matmul (q_reps, d_reps. transpose (O, 1))#计算相似度矩阵维度:(BI, B2)

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求